카프카 4.0부터는 주키퍼(ZooKeeper)가 없습니다. 2025년 3월 18일 릴리스 공지는 4.0을 "아파치 주키퍼 없이 동작하는 첫 메이저 릴리스"로 소개합니다. 그 자리를 채운 것이 KRaft입니다. KRaft는 카프카 안에 들어간 Raft 합의 알고리즘으로, 클러스터 메타데이터를 카프카 자신의 로그에 저장합니다.
"주키퍼를 뺐다"는 말만 들으면 외부 의존성 하나를 걷어낸 정도로 보입니다. 실제로 바뀐 것은 메타데이터가 흐르는 방식입니다. 예전에는 메타데이터를 상태로 들고 있었고, 지금은 이벤트 로그로 흘립니다. 이 글에서는 토픽 하나를 만들 때 레코드가 어떤 순서로 컨트롤러와 브로커를 지나가는지, 리더 컨트롤러가 죽으면 누가 어떻게 다음 리더를 뽑는지를 차례로 따라갑니다. 마지막에는 로컬에서 컨트롤러 3대와 브로커 1대를 띄우고 리더를 죽여 보면서 확인합니다. 실습은 카프카 4.3.1 바이너리로 했습니다.
1. 왜 주키퍼를 걷어냈나
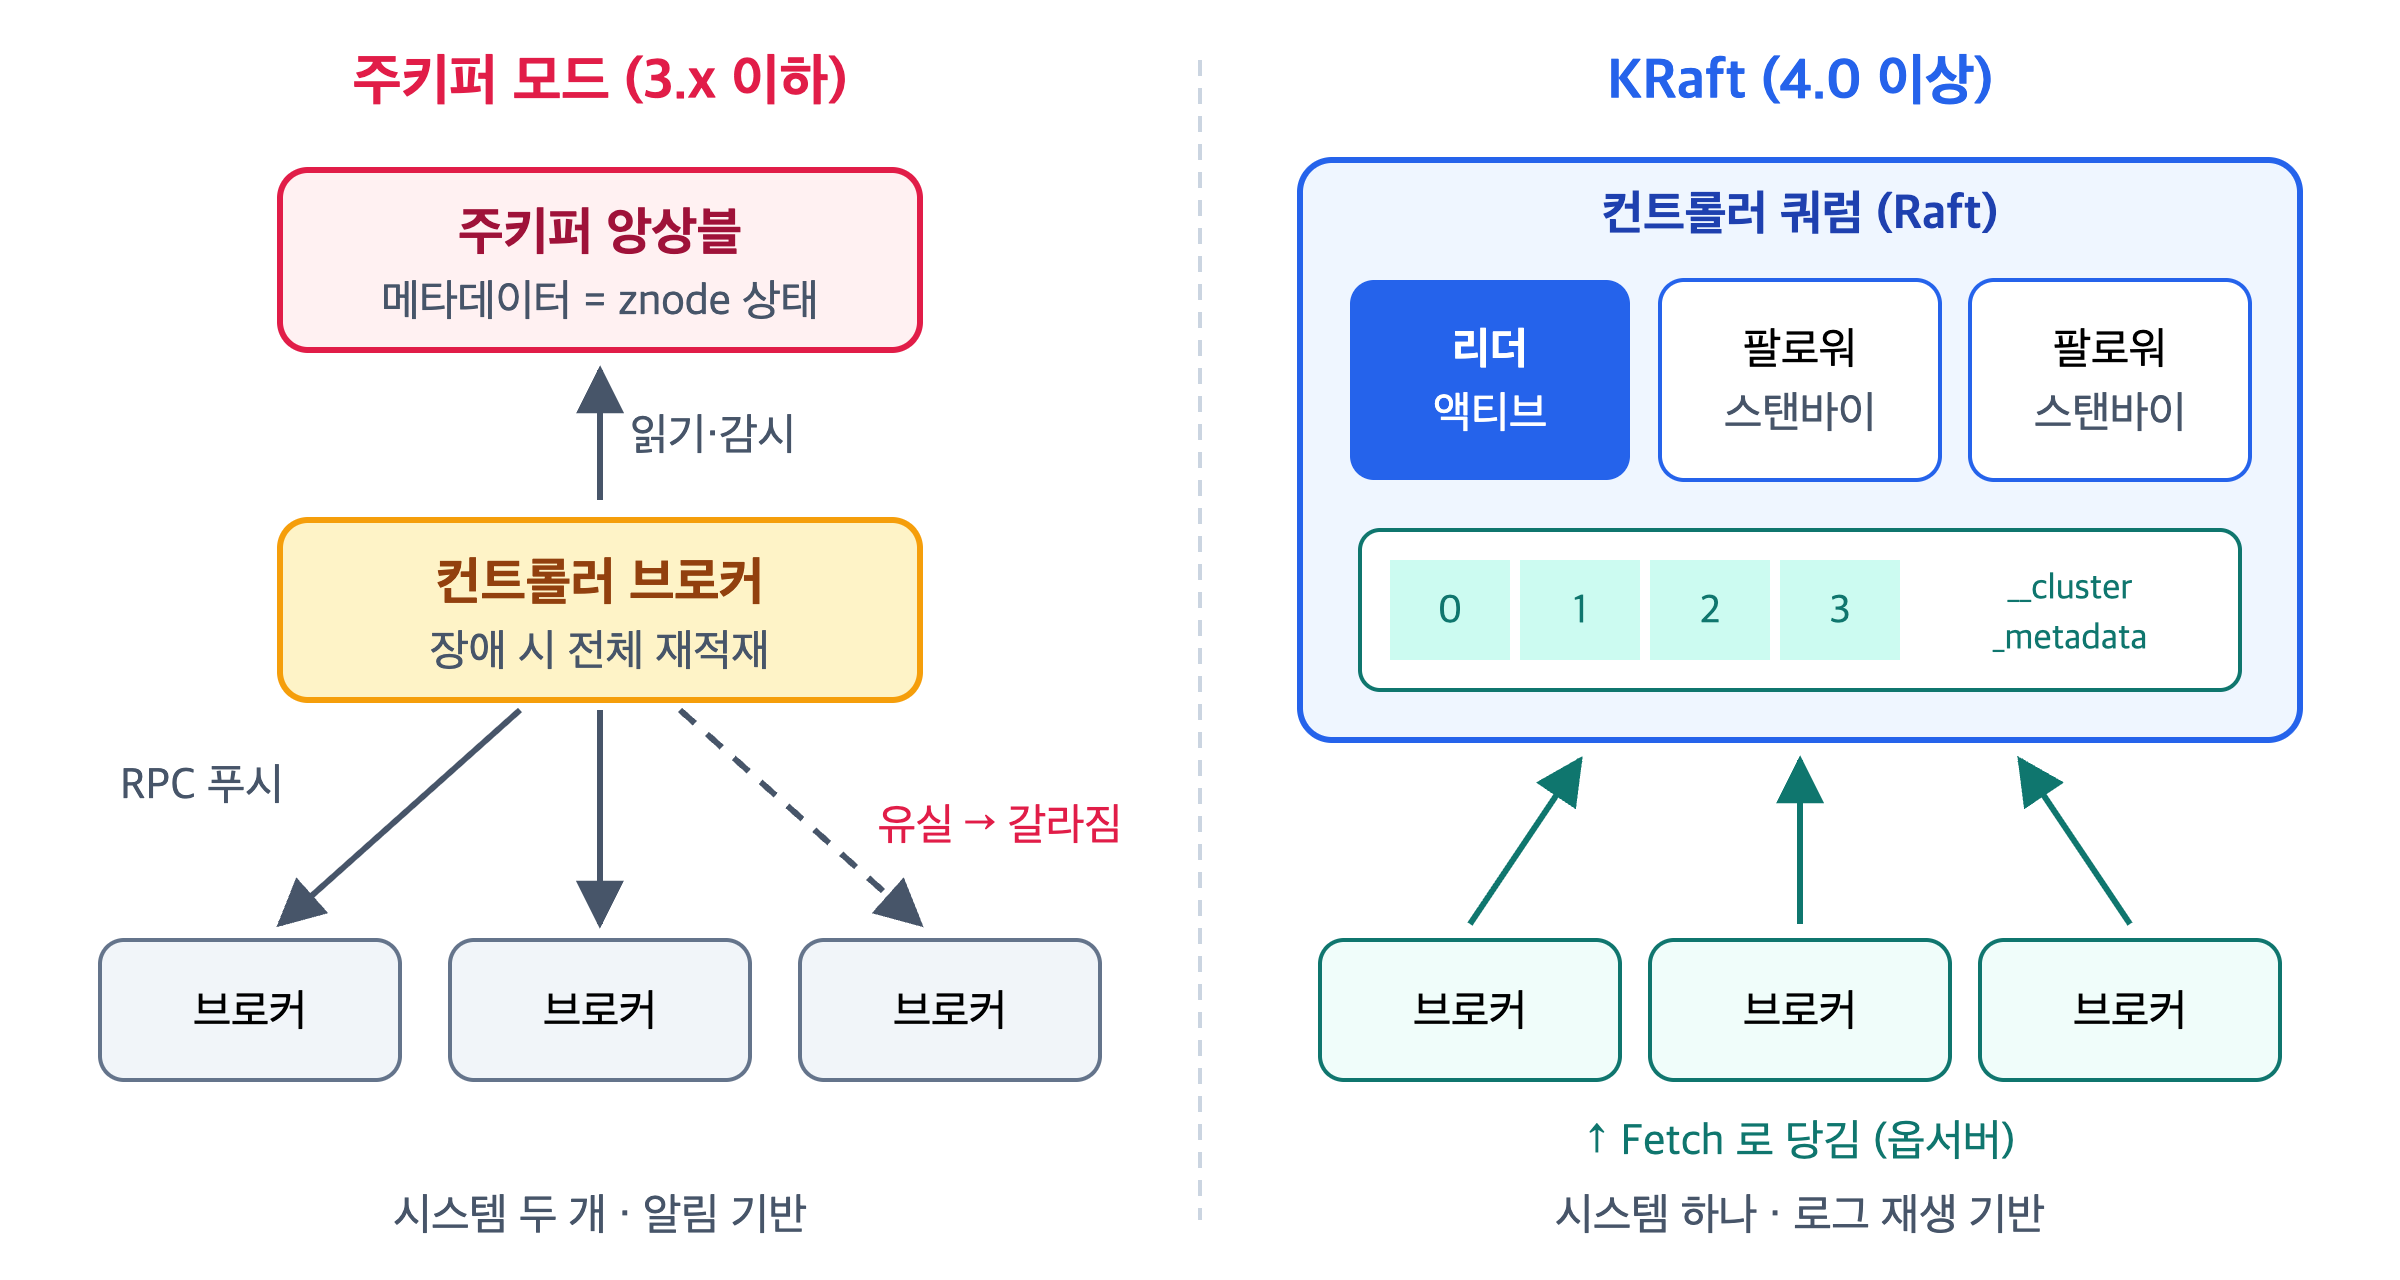
주키퍼 시절 카프카에는 브로커 중 하나가 '컨트롤러'를 맡았습니다. 컨트롤러는 주키퍼에 있는 토픽·파티션·ISR 정보를 읽고, 바뀐 내용을 다른 브로커에 RPC로 밀어 넣었습니다. KIP-500은 이 구조의 문제를 이렇게 짚습니다.
- 상태가 갈라집니다. 컨트롤러가 보낸 변경 알림이 일부 브로커에만 도착하면 브로커마다 다른 메타데이터를 들게 됩니다. KIP-500은 이 상태를 "divergent state"라고 부릅니다. 컨트롤러가 주키퍼의 상태를 따라갈 믿을 만한 방법도 없어서, 변경을 "몇 초 동안" 모를 때가 있다고 적었습니다.
- 장애 조치가 느립니다. 컨트롤러가 바뀌면 새 컨트롤러는 주키퍼에서 전체 메타데이터를 다시 읽어야 합니다. 파티션이 많을수록 이 시간이 길어집니다.
- 시스템이 두 개입니다. 설정, 모니터링, 보안 모델이 각각 따로 있습니다. 운영할 것이 두 배이고, 설정을 잘못할 여지도 그만큼 늘어납니다.
KIP-500이 내놓은 답은 단순합니다. 메타데이터를 카프카 로그로 만들자. 모든 변경을 하나의 순서로 로그에 쌓으면, 브로커는 알림을 기다릴 필요 없이 자기 오프셋 다음부터 로그를 읽어 재생하면 됩니다. 어디까지 읽었는지가 오프셋 숫자 하나로 남으니, 상태가 갈라졌는지도 숫자를 비교해서 바로 압니다.

2. 구성 요소: 누가 무엇을 하나
KRaft 클러스터의 서버는 process.roles 값으로 역할을 정합니다. controller, broker, broker,controller 셋 중 하나이고, 마지막 값은 둘을 겸하는 '결합(combined) 모드'입니다.
| 역할 | Raft에서의 위치 | 하는 일 |
|---|---|---|
| 액티브 컨트롤러 | 리더(Leader) | 메타데이터 변경 요청을 받아 로그에 쓰고 커밋 |
| 대기 컨트롤러 | 팔로워(Voter) | 리더 로그를 복제하는 핫 스탠바이, 선거에서 투표 |
| 브로커 | 옵서버(Observer) | 메타데이터 로그를 가져가 적용, 투표권 없음 |
메타데이터 로그는 __cluster_metadata라는 파티션 하나입니다. 디스크에서도 __cluster_metadata-0 디렉터리로 보입니다. 이 로그를 리더로 맡은 컨트롤러가 곧 액티브 컨트롤러입니다(KIP-500: "The leader of the metadata log is called the active controller").
로그에 쌓이는 것은 메타데이터 레코드입니다. KIP-631은 RegisterBrokerRecord, TopicRecord, PartitionRecord, PartitionChangeRecord, FenceBrokerRecord, UnfenceBrokerRecord, ConfigRecord 같은 타입을 정의합니다. 토픽을 만들면 TopicRecord 하나와 파티션 수만큼의 PartitionRecord가 쌓입니다. 리더가 바뀌거나 ISR이 줄면 PartitionChangeRecord가 쌓입니다. 메타데이터 전체는 이 레코드들을 처음부터 재생한 결과입니다.
3. 내부 동작 ① — 토픽 하나가 클러스터에 퍼지기까지
kafka-topics.sh --create --topic orders --partitions 3을 실행했을 때의 흐름입니다.
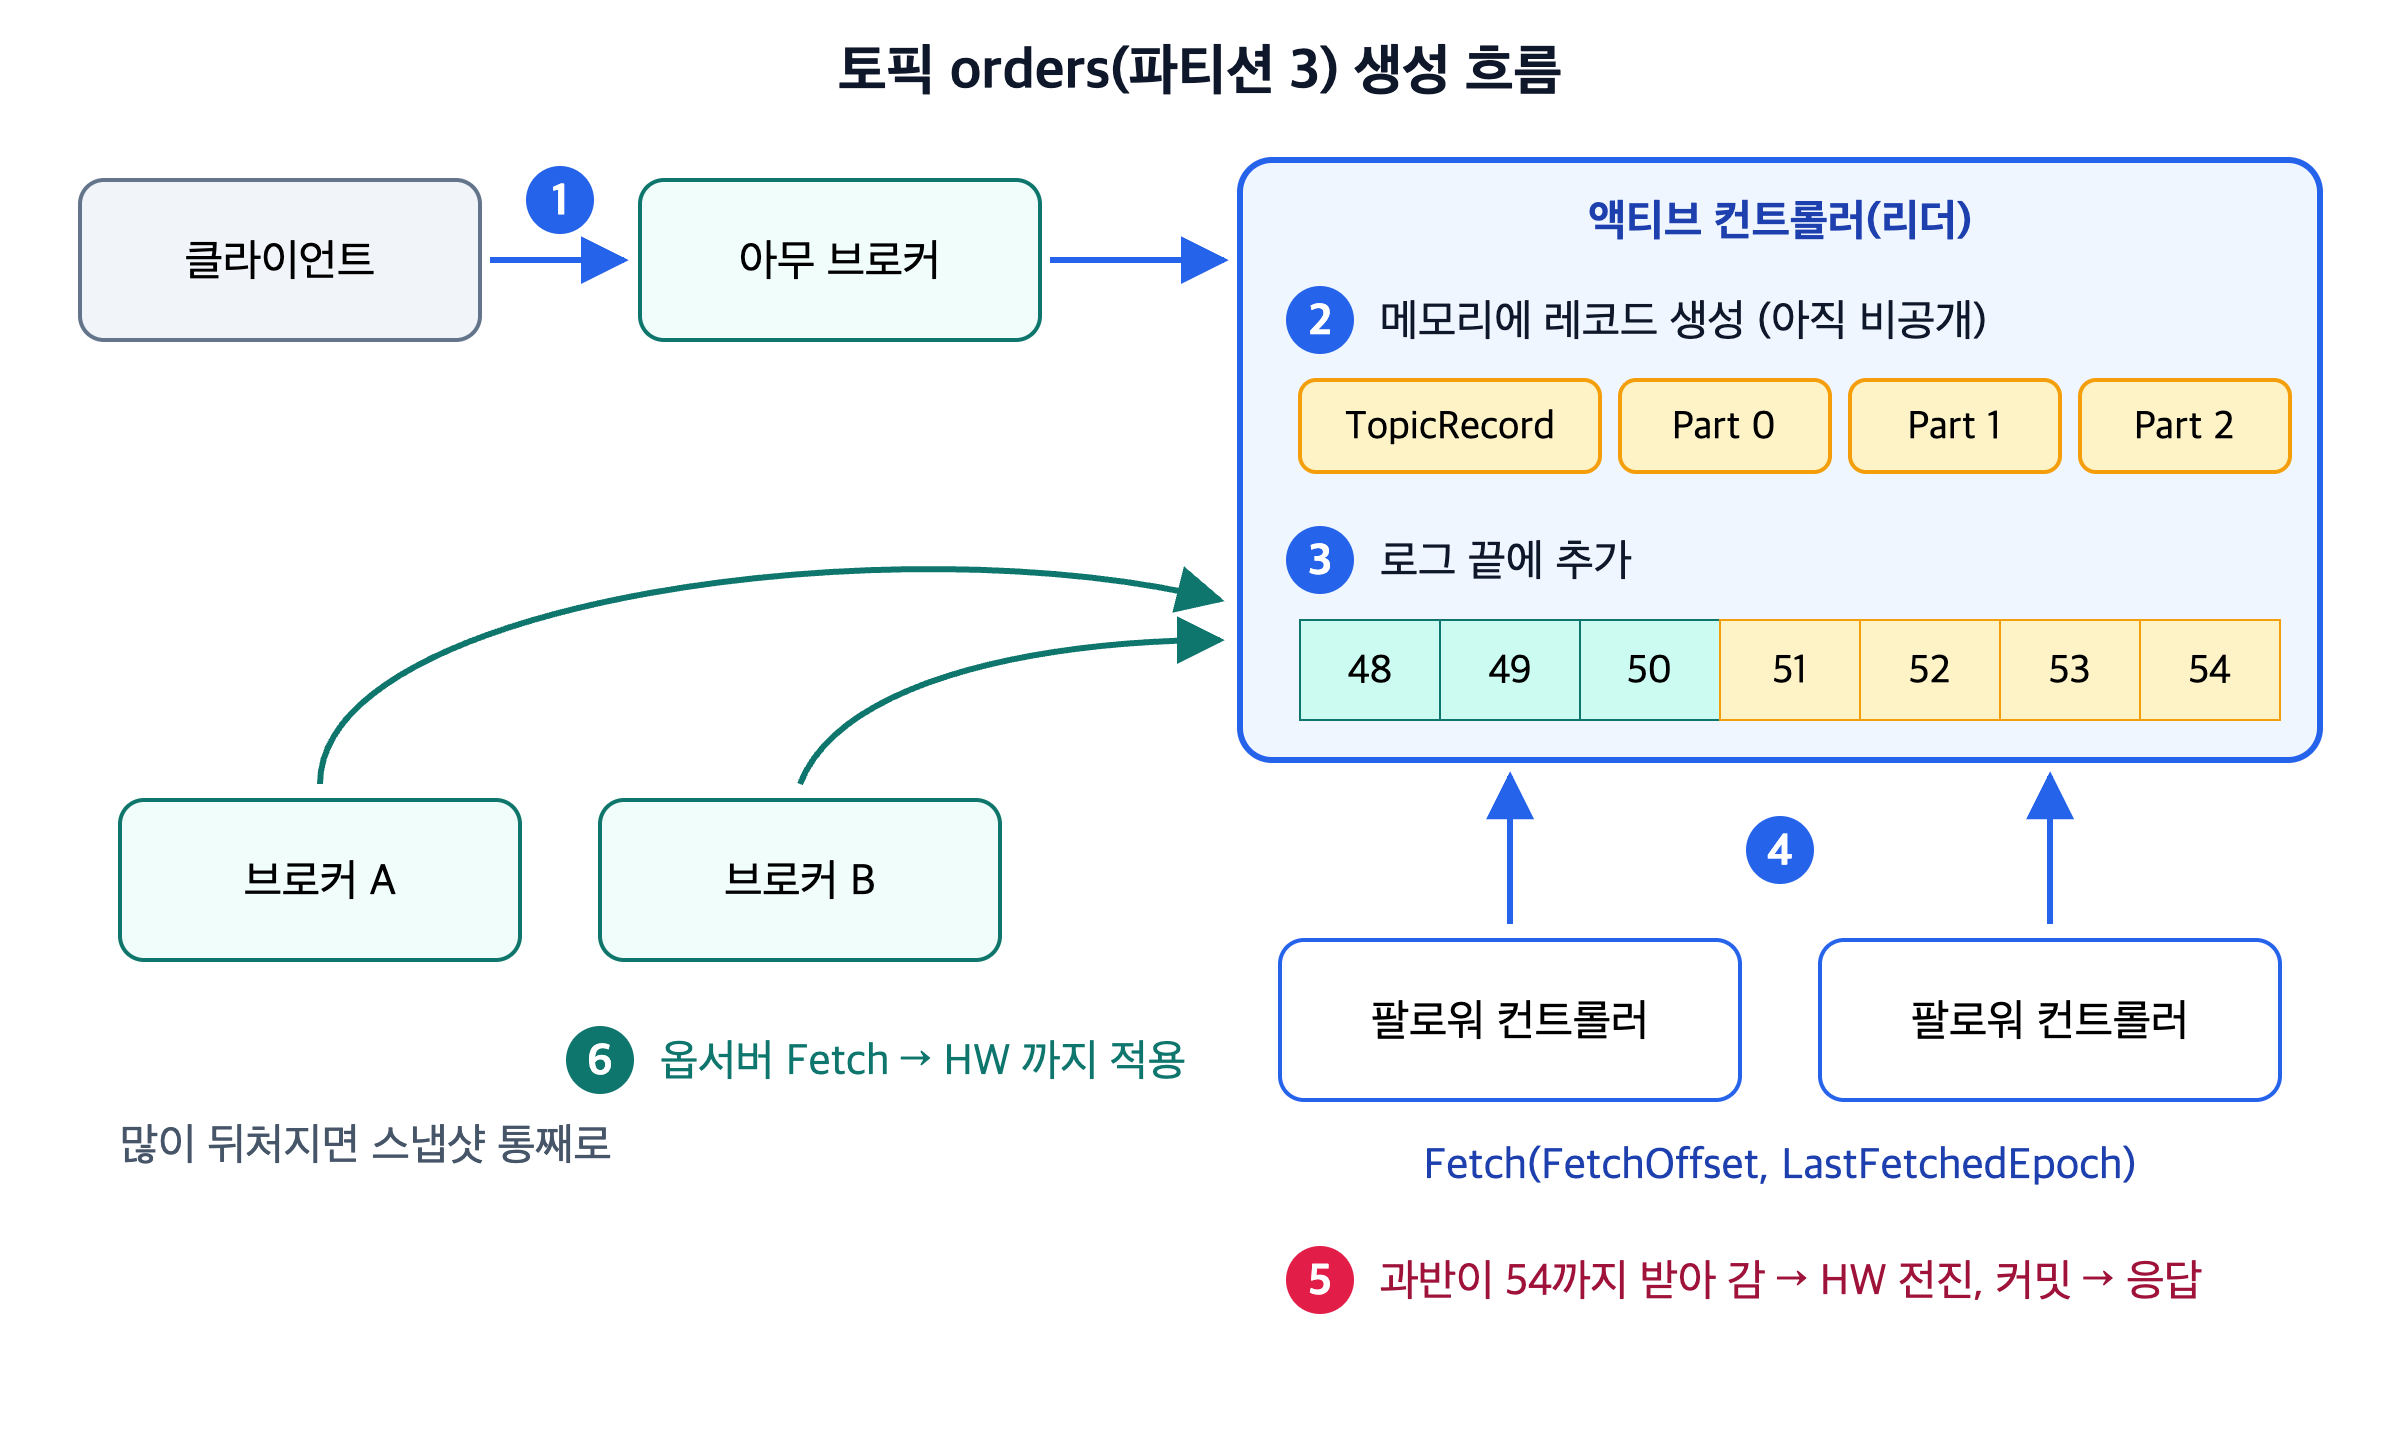
- 요청 도착. 클라이언트는 아무 브로커에나 CreateTopics를 보냅니다. 브로커는 이 요청을 액티브 컨트롤러로 넘깁니다.
- 레코드 생성. 컨트롤러는 파티션 배치를 정하고
TopicRecord1개와PartitionRecord3개를 만듭니다. 이 레코드들은 아직 메모리에만 있습니다. KIP-631은 커밋되지 않은 변경을 메모리에 두되, 영속화될 때까지 바깥에 보이지 않게 한다고 적습니다. - 로그에 추가. 리더 컨트롤러가 레코드를 자기
__cluster_metadata로그 끝에 씁니다. - 팔로워가 가져감. 원래 Raft는 리더가 팔로워에게 로그를 밀어 넣습니다(push). KRaft는 반대로 팔로워가 Fetch 요청으로 가져갑니다(pull). 카프카의 파티션 복제와 같은 방식입니다. Fetch에는
FetchOffset과LastFetchedEpoch가 실립니다. - 하이 워터마크 전진. 투표자 과반이 어떤 오프셋까지 가져갔다는 사실이 Fetch로 확인되면, 리더는 하이 워터마크(HW)를 그 오프셋까지 올립니다. HW 아래에 있는 레코드가 '커밋된' 메타데이터입니다. 이때 컨트롤러가 클라이언트에게 성공을 돌려줍니다.
- 브로커 반영. 브로커는 옵서버로서 같은 Fetch로 로그를 가져가 HW까지 적용합니다. 이제
orders파티션의 리더 브로커가 자기 역할을 알게 됩니다. 한참 뒤처진 브로커에게는 레코드를 하나씩 주는 대신 스냅샷을 통째로 내려 줍니다.
이 흐름 덕분에 브로커마다 메타데이터가 갈라지는 일이 줄어듭니다. 모든 브로커가 같은 로그를 같은 순서로 재생하기 때문입니다. 두 브로커의 메타데이터가 다르다면 둘이 적용한 오프셋이 다를 뿐이고, 기다리면 따라잡습니다.
Pull 방식의 대가: 로그가 갈라졌을 때
pull 방식에서는 일관성 검사를 리더가 맡습니다. 팔로워가 보낸 FetchOffset과 LastFetchedEpoch가 리더 로그와 맞지 않으면, 리더는 빈 응답에 DivergingEpoch(epoch, EndOffset)를 담아 돌려줍니다. 팔로워는 그 지점 이후를 잘라 내고(truncate) 다시 가져갑니다. 예전 리더 시절에 쓰였지만 커밋되지 못한 레코드를 이렇게 정리합니다. KIP-595는 pull 방식의 단점도 함께 적었습니다. 커밋 판단에 Fetch 한 바퀴를 기다려야 하므로 지연이 더 생길 수 있습니다.
하트비트와 펜싱
브로커는 시작할 때 컨트롤러에 BrokerRegistration을 보냅니다. 컨트롤러는 RegisterBrokerRecord를 로그에 쓰고 브로커 에포크를 줍니다. KIP-631은 이 에포크를 "로그의 다음 오프셋을 기준으로" 정한다고 설명합니다. 그래서 같은 브로커 ID가 재시작해도 에포크는 항상 커집니다.
등록한 뒤에는 broker.heartbeat.interval.ms(기본 2초)마다 BrokerHeartbeat를 보냅니다. broker.session.timeout.ms(기본 9초) 동안 하트비트가 없으면 컨트롤러는 그 브로커를 펜싱(fenced) 상태로 돌립니다. 펜싱된 브로커는 클라이언트가 받는 메타데이터에서 빠집니다. 브로커가 메타데이터를 따라잡지 못하면 클러스터 구성원으로 남을 수 없다는 것이 KIP-500의 원칙입니다.
4. 내부 동작 ② — 액티브 컨트롤러가 죽으면
리더 선출도 Raft 그대로입니다. 여기에 카프카식 이름과 몇 가지 장치가 붙습니다.
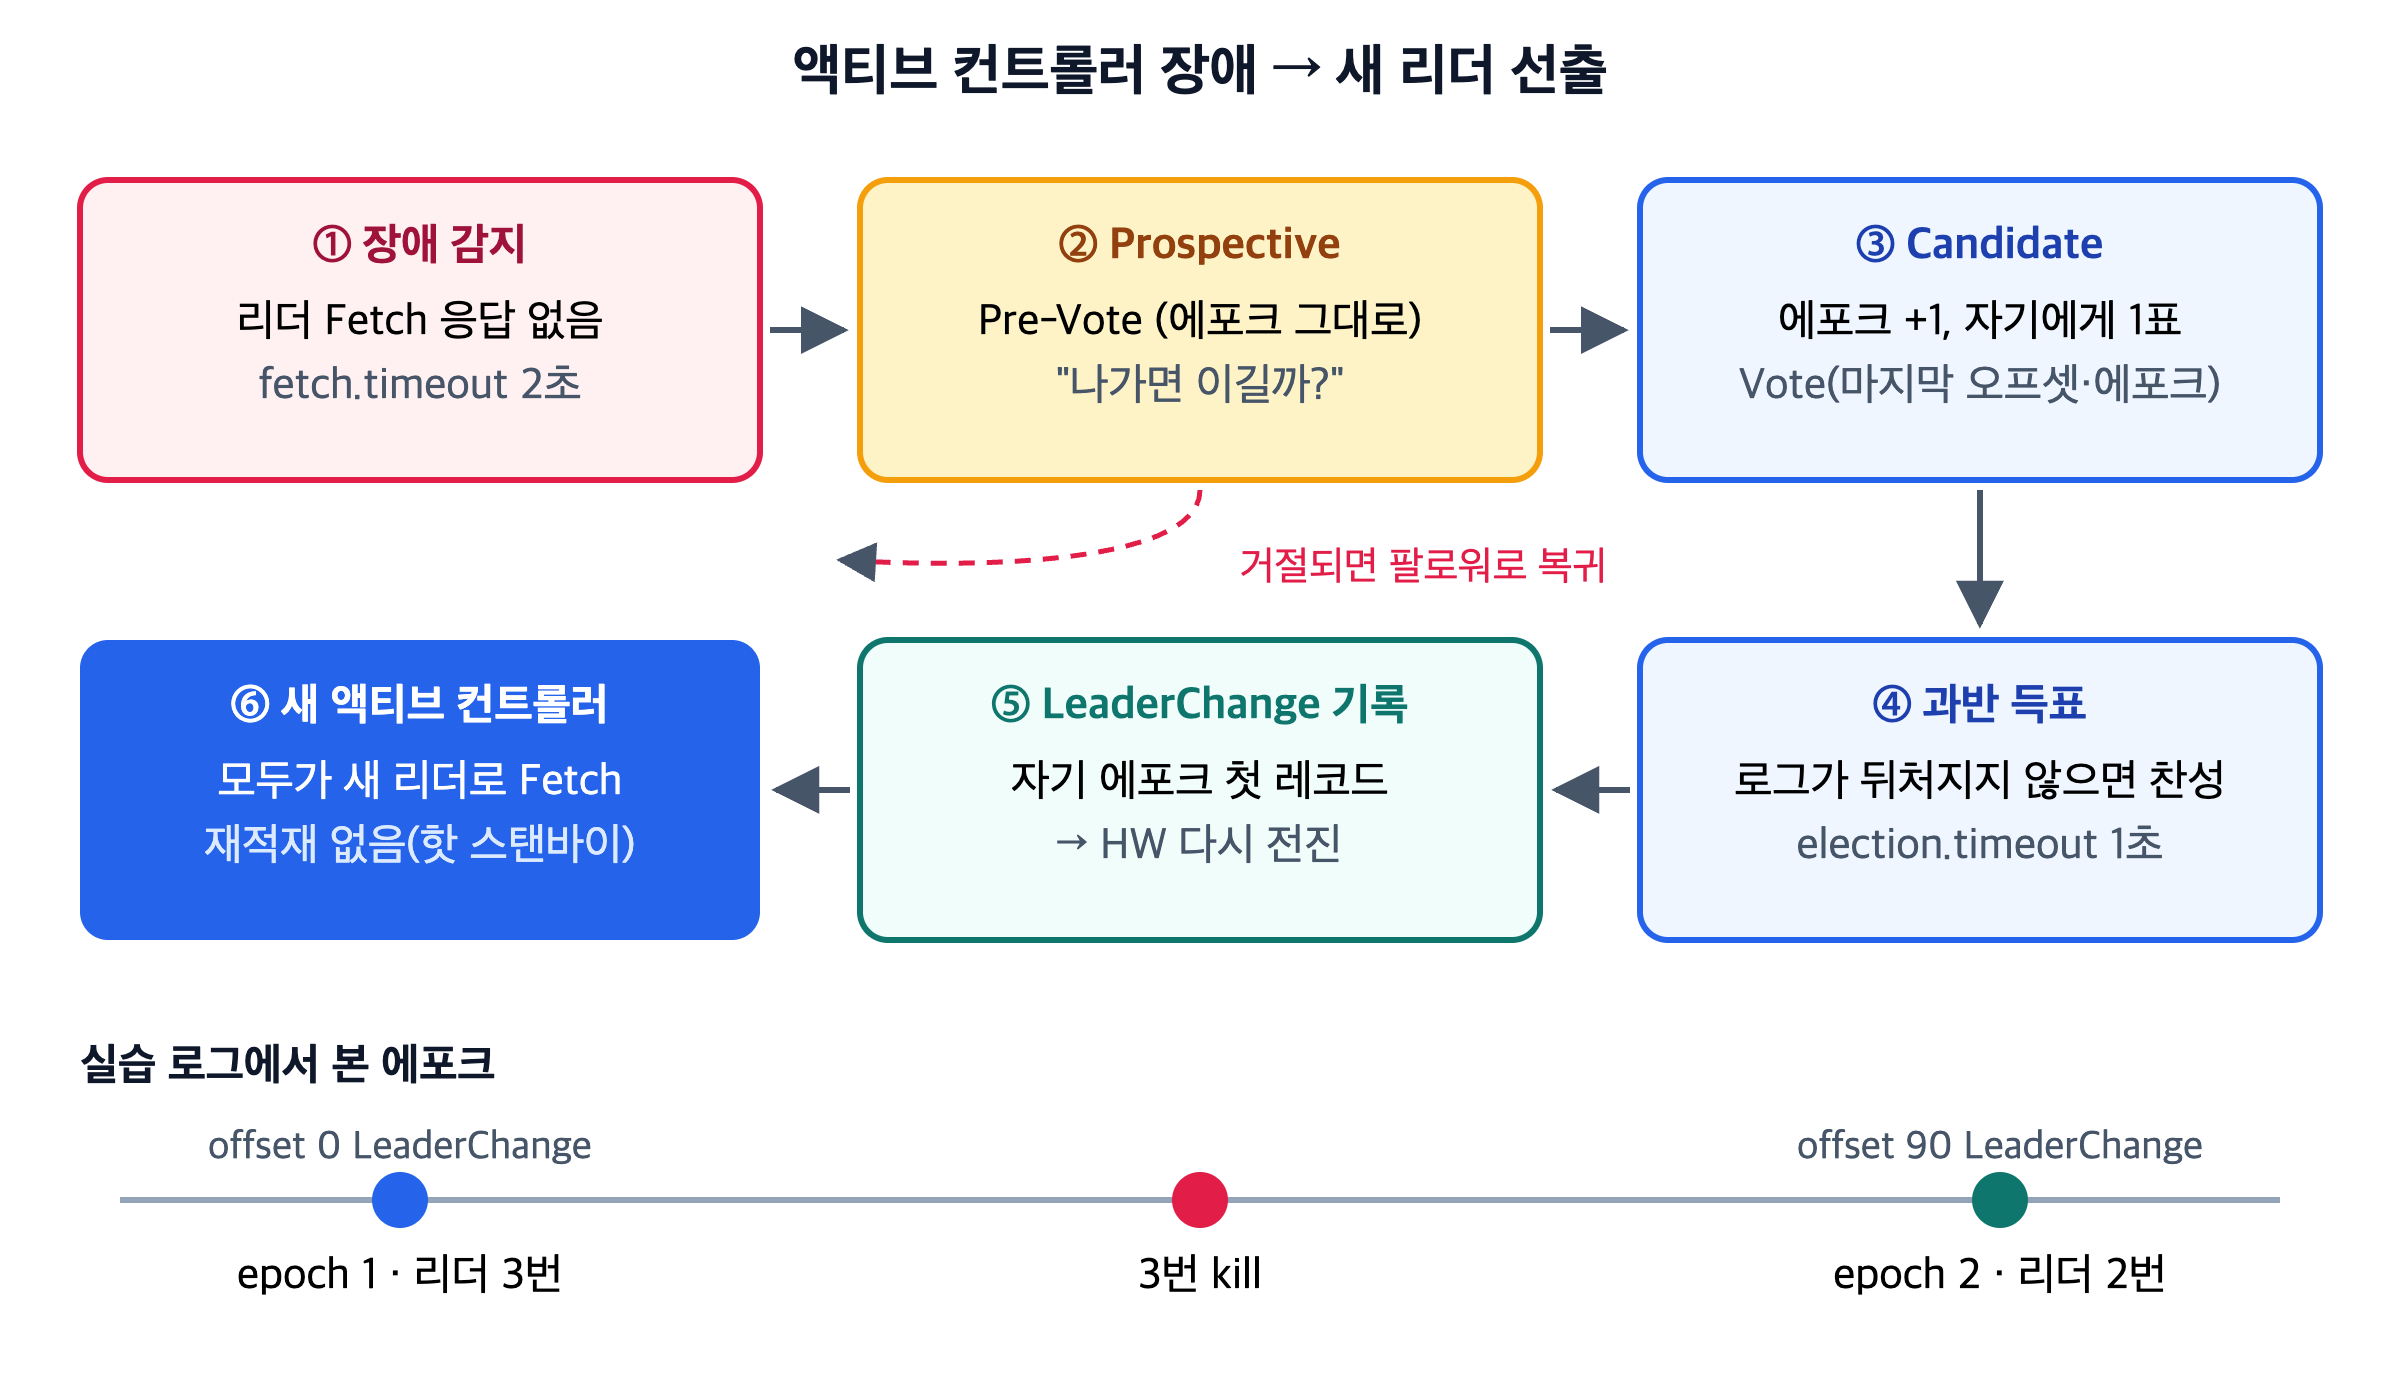
- 장애 감지. 팔로워는
controller.quorum.fetch.timeout.ms(기본 2초) 동안 리더로부터 성공적인 Fetch 응답을 받지 못하면 리더가 죽었다고 판단합니다. 리더도 같은 시간 동안 과반에게서 Fetch를 받지 못하면 스스로 물러납니다. 네트워크에서 고립된 리더가 혼자 리더 행세를 하지 못하게 하는 장치입니다. - 사전 투표(Pre-Vote). 바로 에포크를 올리지 않고 먼저
Prospective상태가 되어 "내가 나가면 이길까?"를 물어봅니다. KIP-996에서 들어온 장치입니다. 리더에게서 최근에 Fetch를 성공한 팔로워는 이 요청을 거절합니다. 잠깐 끊겼다 돌아온 노드가 에포크만 올려 멀쩡한 리더를 끌어내리는 일을 막습니다. - 후보 등록. 사전 투표에서 이길 수 있다고 확인되면
Candidate가 됩니다. 에포크(Raft의 term)를 1 올리고 자기에게 한 표를 던진 뒤, 다른 투표자에게 Vote 요청을 보냅니다. 요청에는 자기 로그의 마지막 오프셋과 에포크가 실립니다. - 투표. 받는 쪽은 후보의 로그가 자기 로그보다 뒤처지지 않을 때만 찬성합니다. 커밋된 레코드는 과반이 갖고 있으므로, 과반의 찬성을 받은 후보는 커밋된 레코드를 모두 갖고 있습니다.
controller.quorum.election.timeout.ms(기본 1초) 안에 과반을 얻지 못하면 무작위 백오프(controller.quorum.election.backoff.max.ms, 기본 1초) 뒤 다시 선거를 엽니다. - 취임 레코드. 이긴 후보는 즉시
LeaderChange컨트롤 레코드를 자기 로그에 씁니다. Raft에서 새 리더는 자기 에포크의 엔트리가 커밋되기 전까지 HW를 올리지 않습니다. 빈 레코드라도 하나 써야 HW가 움직이므로, 취임 직후 이 레코드를 씁니다. - 새 액티브 컨트롤러. 나머지 컨트롤러와 브로커는 새 리더에게 Fetch를 보내기 시작합니다. 새 리더는 이미 같은 로그를 메모리에 재생해 둔 핫 스탠바이였습니다. 그래서 주키퍼 시절처럼 메타데이터 전체를 다시 읽는 단계가 없습니다.
로그가 무한히 자라지 않게: 스냅샷과 NO_OP
메타데이터 로그는 계속 쌓이므로 주기적으로 압축해야 합니다. 각 컨트롤러와 브로커는 HW까지의 상태를 스냅샷으로 떠서 오프셋-에포크.checkpoint 파일로 저장합니다. 기본값으로는 마지막 스냅샷 뒤에 쌓인 로그가 20MiB(metadata.log.max.record.bytes.between.snapshots=20971520)를 넘으면 새 스냅샷을 만듭니다. 스냅샷은 노드마다 로컬이라 오프셋이 서로 달라도 됩니다.
또 하나 눈에 띄는 것은 NO_OP_RECORD입니다. 액티브 컨트롤러는 변경이 없어도 metadata.max.idle.interval.ms(기본 500ms)마다 빈 레코드를 씁니다. 실습 로그를 덤프해 보면 레코드 대부분이 이것입니다.
5. 직접 해 보기 — 컨트롤러 3대, 브로커 1대, 리더 죽이기
자바 17 이상과 카프카 4.3.1 바이너리만 있으면 됩니다. 아래 스크립트는 공식 문서의 --initial-controllers 방식으로 동적 쿼럼을 만듭니다.
#!/usr/bin/env bash
# up.sh — 카프카 압축을 푼 디렉터리에서 실행
set -euo pipefail
D=/tmp/kraft-demo; rm -rf $D; mkdir -p $D
CLUSTER_ID="$(bin/kafka-storage.sh random-uuid)"
for i in 1 2 3; do eval "U$i=$(bin/kafka-storage.sh random-uuid)"; done
INIT="1@localhost:19093:$U1,2@localhost:19094:$U2,3@localhost:19095:$U3"
BOOT="localhost:19093,localhost:19094,localhost:19095"

for i in 1 2 3; do
  p=$((19092+i))
  cat > $D/c$i.properties <<P
process.roles=controller
node.id=$i
listeners=CONTROLLER://localhost:$p
advertised.listeners=CONTROLLER://localhost:$p
controller.listener.names=CONTROLLER
controller.quorum.bootstrap.servers=$BOOT
log.dirs=$D/c$i
P
  bin/kafka-storage.sh format --cluster-id $CLUSTER_ID \
    --initial-controllers "$INIT" --config $D/c$i.properties
done

cat > $D/b.properties <<P
process.roles=broker
node.id=100
listeners=PLAINTEXT://localhost:19092
advertised.listeners=PLAINTEXT://localhost:19092
controller.listener.names=CONTROLLER
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
controller.quorum.bootstrap.servers=$BOOT
offsets.topic.replication.factor=1
log.dirs=$D/b
P
bin/kafka-storage.sh format --cluster-id $CLUSTER_ID \
  --no-initial-controllers --config $D/b.properties

for n in c1 c2 c3 b; do
  nohup bin/kafka-server-start.sh $D/$n.properties > $D/$n.out 2>&1 &
  echo $! > $D/$n.pid
done
20초쯤 뒤 쿼럼 상태를 봅니다. 아래는 실제로 실행한 출력에서 일부를 줄인 것입니다.
$ bin/kafka-topics.sh --bootstrap-server localhost:19092 --create --topic orders --partitions 3
Created topic orders.

$ bin/kafka-metadata-quorum.sh --bootstrap-server localhost:19092 describe --replication
NodeId  LogEndOffset  Lag  Status
3       71            0    Leader
1       71            0    Follower
2       71            0    Follower
100     71            0    Observer
브로커(100)는 Observer로 나옵니다. 투표권 없이 로그만 가져간다는 뜻입니다. 이제 리더(3번)를 죽입니다.
$ kill $(cat /tmp/kraft-demo/c3.pid); sleep 6
$ bin/kafka-metadata-quorum.sh --bootstrap-server localhost:19092 describe --status
LeaderId:               2
LeaderEpoch:            2
HighWatermark:          107

$ bin/kafka-topics.sh --bootstrap-server localhost:19092 --create --topic payments --partitions 1
Created topic payments.
에포크가 1에서 2로 오르고, 남은 두 대 중 2번이 리더가 됐습니다. 세 대 중 한 대가 빠져도 과반(2)이 남으므로 토픽 생성이 계속 됩니다. 1번 컨트롤러 로그(c1.out)를 보면 ProspectiveState로 갔다가 preVote=true인 Vote 요청이 오가는 줄이 찍혀 있습니다. 4.3.1에서 사전 투표가 실제로 동작한다는 뜻입니다.
메타데이터 로그를 그대로 디코딩해 보면 앞에서 설명한 레코드가 보입니다.
$ bin/kafka-dump-log.sh --cluster-metadata-decoder \
    --files /tmp/kraft-demo/c1/__cluster_metadata-0/00000000000000000000.log \
  | grep -E 'TOPIC_RECORD|LeaderChange'
... LeaderChange: {"leaderId":3,"voters":[...],"grantingVoters":[{"voterId":3},{"voterId":2}]}
... {"type":"TOPIC_RECORD","data":{"name":"orders","topicId":"wWmbTE7eQNSYFVaTA63ebQ"}}
... LeaderChange: {"leaderId":2,"voters":[...],"grantingVoters":[{"voterId":2},{"voterId":1}]}
... {"type":"TOPIC_RECORD","data":{"name":"payments","topicId":"W25KHirrTdeHtFf0ieaJAA"}}
새 리더가 들어설 때마다 LeaderChange가 먼저 찍히고, 누가 찬성표를 던졌는지(grantingVoters)도 남습니다. 같은 로그에서 브로커 등록 레코드를 보면 "brokerEpoch":17처럼 브로커 에포크가 로그 오프셋 기준으로 붙어 있습니다. 실습이 끝나면 kill $(cat /tmp/kraft-demo/*.pid)로 정리합니다.
6. 비교: 주키퍼 모드와 KRaft, 그리고 설정값
| 항목 | 주키퍼 모드(3.x 이하) | KRaft(4.0 이상은 이것만) |
|---|---|---|
| 메타데이터 저장 위치 | 주키퍼 znode | __cluster_metadata 로그 |
| 변경 전달 | 컨트롤러가 브로커로 RPC 푸시 | 브로커가 로그를 Fetch로 당김 |
| 컨트롤러 장애 조치 | 새 컨트롤러가 주키퍼에서 전체 재적재 | 핫 스탠바이가 바로 이어받음 |
| 일관성 확인 | 알림 유실 시 갈라질 수 있음 | 적용한 오프셋으로 비교 |
| 운영 대상 | 카프카 + 주키퍼 두 시스템 | 카프카 하나 |
| 전환 경로 | — | 브리지 릴리스 3.9에서 마이그레이션 |
선거와 브로커 생존 판정에 관련된 설정의 기본값(4.3 문서 기준)입니다.
| 설정 | 기본값 | 의미 |
|---|---|---|
controller.quorum.fetch.timeout.ms |
2000 | 리더 Fetch가 이 시간 끊기면 선거 시작, 리더는 과반 Fetch가 끊기면 사임 |
controller.quorum.election.timeout.ms |
1000 | 후보가 과반을 기다리는 최대 시간 |
controller.quorum.election.backoff.max.ms |
1000 | 선거가 엇갈릴 때 재시도 백오프 상한 |
broker.heartbeat.interval.ms |
2000 | 브로커 하트비트 주기 |
broker.session.timeout.ms |
9000 | 하트비트가 없으면 펜싱되는 시간 |
metadata.max.idle.interval.ms |
500 | NO_OP 레코드 주기 |
쿼럼 크기별로 견딜 수 있는 장애 수입니다. 공식 문서는 N대의 동시 장애를 견디려면 컨트롤러가 2N+1대 필요하다고 적습니다.
| 컨트롤러 수 | 과반 | 견디는 동시 장애 |
|---|---|---|
| 1 | 1 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
7. 흔한 오해와 실수
"컨트롤러를 4대 두면 3대보다 안전하다." 아닙니다. 4대의 과반은 3이므로 견디는 장애는 3대일 때와 같은 1대입니다. 반면 커밋하려면 3대의 확인이 필요하니 쓰기가 더 무거워지고, 고장 날 기계만 하나 늘어납니다. 공식 문서도 3대나 5대를 권합니다.
"작은 운영 환경이니 결합 모드로 충분하다." 공식 문서는 결합 모드를 개발 환경용으로 보고, 중요한 배포 환경에서는 피하라고 적습니다. 결합 모드에서는 컨트롤러만 따로 재시작하거나 늘릴 수 없습니다. 브로커에 부하가 걸리면 같은 프로세스의 컨트롤러도 영향을 받습니다. 그러다 Fetch가 2초 끊기면 선거가 열립니다.
"메타데이터 디렉터리가 꼬였으면 지우고 다시 포맷하면 된다." 위험합니다. KRaft가 저장소 자동 포맷을 없앤 이유가 바로 이것입니다. 문서는 과반의 컨트롤러가 빈 로그 디렉터리로 시작하면 커밋된 데이터가 없는 노드가 리더로 뽑힐 수 있다고 경고합니다. Raft의 안전성은 "커밋된 레코드는 과반이 갖고 있다"는 전제에 기댑니다. 디스크를 지우는 순간 이 전제가 깨집니다. 컨트롤러를 교체할 때는 --no-initial-controllers로 새 노드를 포맷하고, kafka-metadata-quorum.sh add-controller/remove-controller로 구성원을 바꿉니다.
"controller.quorum.voters만 맞춰 두면 컨트롤러를 언제든 바꿀 수 있다." 이 키로 만든 클러스터는 정적 쿼럼입니다. 정적 쿼럼에서는 컨트롤러를 온라인으로 더하거나 뺄 수 없습니다. 동적 쿼럼(KIP-853)은 kraft.version=1부터 지원하며, 4.1부터는 정적 쿼럼을 동적으로 업그레이드할 수 있습니다. 동적 쿼럼에서는 controller.quorum.voters를 비우고 controller.quorum.bootstrap.servers를 씁니다. 어느 쪽인지는 kafka-features.sh describe에서 kraft.version이 0인지 1인지로 확인합니다.
"브로커는 컨트롤러 투표에 참여한다." 브로커는 옵서버입니다. 로그를 받아 갈 뿐 투표하지 않습니다. 브로커를 100대로 늘려도 합의에 필요한 과반은 컨트롤러 수로만 정해집니다.
8. 정리
- KRaft는 메타데이터를
__cluster_metadata로그로 만들고, 컨트롤러 쿼럼이 Raft로 합의해 그 로그의 리더(액티브 컨트롤러)를 정합니다. - 변경은 리더가 쓰고, 팔로워와 브로커가 Fetch로 당겨 가며, 과반이 받아 간 지점(HW)에서 커밋됩니다. 장애 시에는 사전 투표, 에포크 증가, 과반 득표,
LeaderChange순으로 새 리더가 섭니다. - 운영에서는 컨트롤러를 3대나 5대 두고, 결합 모드와 재포맷을 피하고, 동적 쿼럼으로 구성원을 바꿉니다.
smith lab 에서 이어서 보기
smith lab(smithlab.co.kr)은 설치·로그인 없이 브라우저에서 바로 쓰는 개발자 도구와 실무 글을 모아 둔 곳입니다. 개발 글 모음도 함께 보세요.
참고 자료
- KIP-500: Replace ZooKeeper with a Self-Managed Metadata Quorum
- KIP-595: A Raft Protocol for the Metadata Quorum
- KIP-631: The Quorum-based Kafka Controller
- KIP-853: KRaft Controller Membership Changes
- KIP-996: Pre-Vote
- Apache Kafka 4.3 문서 — KRaft 운영
- Apache Kafka 4.3 문서 — 브로커 설정
- Apache Kafka 4.0.0 릴리스 공지 (2025-03-18)
- In Search of an Understandable Consensus Algorithm (Raft 논문)
'Develop > [Kafka]' 카테고리의 다른 글
| 카프카 파티션과 오프셋 원리 — 세그먼트·인덱스·하이 워터마크 (0) | 2026.10.26 |
|---|---|
| CDC 원리 — Debezium 이 WAL 을 카프카로 흘리는 법 (0) | 2026.10.26 |
| 카프카 Exactly-once 원리 — 멱등 프로듀서·트랜잭션·LSO (0) | 2026.10.25 |
| 카프카 컨슈머 그룹 리밸런싱은 왜 멈춤을 만드나 — KIP-848 (0) | 2026.10.13 |
| [Kafka] 파티셔너 (0) | 2023.08.31 |


