주문 서비스가 주문을 저장합니다. 검색 인덱스도 갱신해야 하고, 정산 서비스에도 알려야 하고, 캐시도 지워야 합니다. 가장 쉬운 방법은 코드에서 DB 에 쓰고 바로 카프카에도 보내는 것입니다. 이것을 이중 쓰기(dual write)라고 부릅니다. 그리고 이 방법은 언젠가 반드시 어긋납니다.
DB 커밋은 성공했는데 카프카 전송 직전에 프로세스가 죽으면 이벤트가 사라집니다. 순서를 바꿔 카프카에 먼저 보내면, 이번에는 DB 롤백 뒤에 유령 이벤트가 남습니다. 두 시스템을 한 트랜잭션으로 묶을 수 없으니 생기는 문제입니다.
CDC(Change Data Capture)는 질문을 바꿉니다. "애플리케이션이 이벤트를 보낸다"가 아니라 "DB 가 이미 기록한 변경 로그를 읽어서 흘린다"입니다. DB 는 원래 모든 커밋을 로그에 남깁니다. 그 로그를 따라 읽으면 커밋된 변경만, 커밋된 순서대로 얻습니다. 이 글은 PostgreSQL 과 Debezium 을 예로, 변경 한 건이 WAL 에서 카프카 토픽까지 가는 길을 단계별로 풉니다.
CDC 가 푸는 문제 — 왜 로그를 읽나
CDC 를 구현하는 방법은 크게 셋입니다.
첫째, 폴링입니다. updated_at > 마지막 조회 시각 으로 주기적으로 SELECT 합니다. 단순하지만 지운 행은 보이지 않습니다. 행이 사라졌으니 조회될 것이 없습니다. 두 번 바뀐 행은 마지막 상태만 보입니다. 조회 주기만큼 늦고, 조회 자체가 DB 에 부하를 줍니다.
둘째, 트리거입니다. 테이블에 트리거를 걸어 변경을 별도 테이블에 복사합니다. 삭제도 잡히지만 쓰기마다 추가 쓰기가 붙습니다. 애플리케이션 트랜잭션이 그만큼 느려집니다.
셋째, 로그 기반입니다. DB 가 내구성을 위해 이미 쓰고 있는 트랜잭션 로그를 읽습니다. PostgreSQL 은 WAL(Write-Ahead Log), MySQL 은 binlog 입니다. 추가 쓰기가 없고, 삭제·중간 상태·트랜잭션 경계까지 모두 남아 있습니다. Debezium 이 택한 방식이 이것입니다.
| 방식 | 삭제 감지 | 중간 상태 | 원본 DB 부담 | 지연 | 스키마 변경 필요 |
|---|---|---|---|---|---|
폴링 (updated_at) |
못 함 (소프트 삭제 필요) | 마지막 값만 | 주기적 SELECT | 폴링 주기만큼 | 타임스탬프 컬럼 |
| 트리거 | 됨 | 모두 | 쓰기마다 추가 쓰기 | 낮음 | 트리거·로그 테이블 |
| 로그 기반 (Debezium) | 됨 | 모두 | 로그 읽기 (슬롯 관리 필요) | 낮음 | 없음 (DB 설정만) |
로그 기반에도 대가가 있습니다. 로그 형식은 DB 마다 다르고, 로그 보존을 DB 와 협상해야 합니다. 이 협상이 PostgreSQL 에서는 복제 슬롯이고, 운영 사고의 대부분이 여기서 납니다. 뒤에서 자세히 봅니다.
내부 동작 원리 — 변경 한 건의 여정
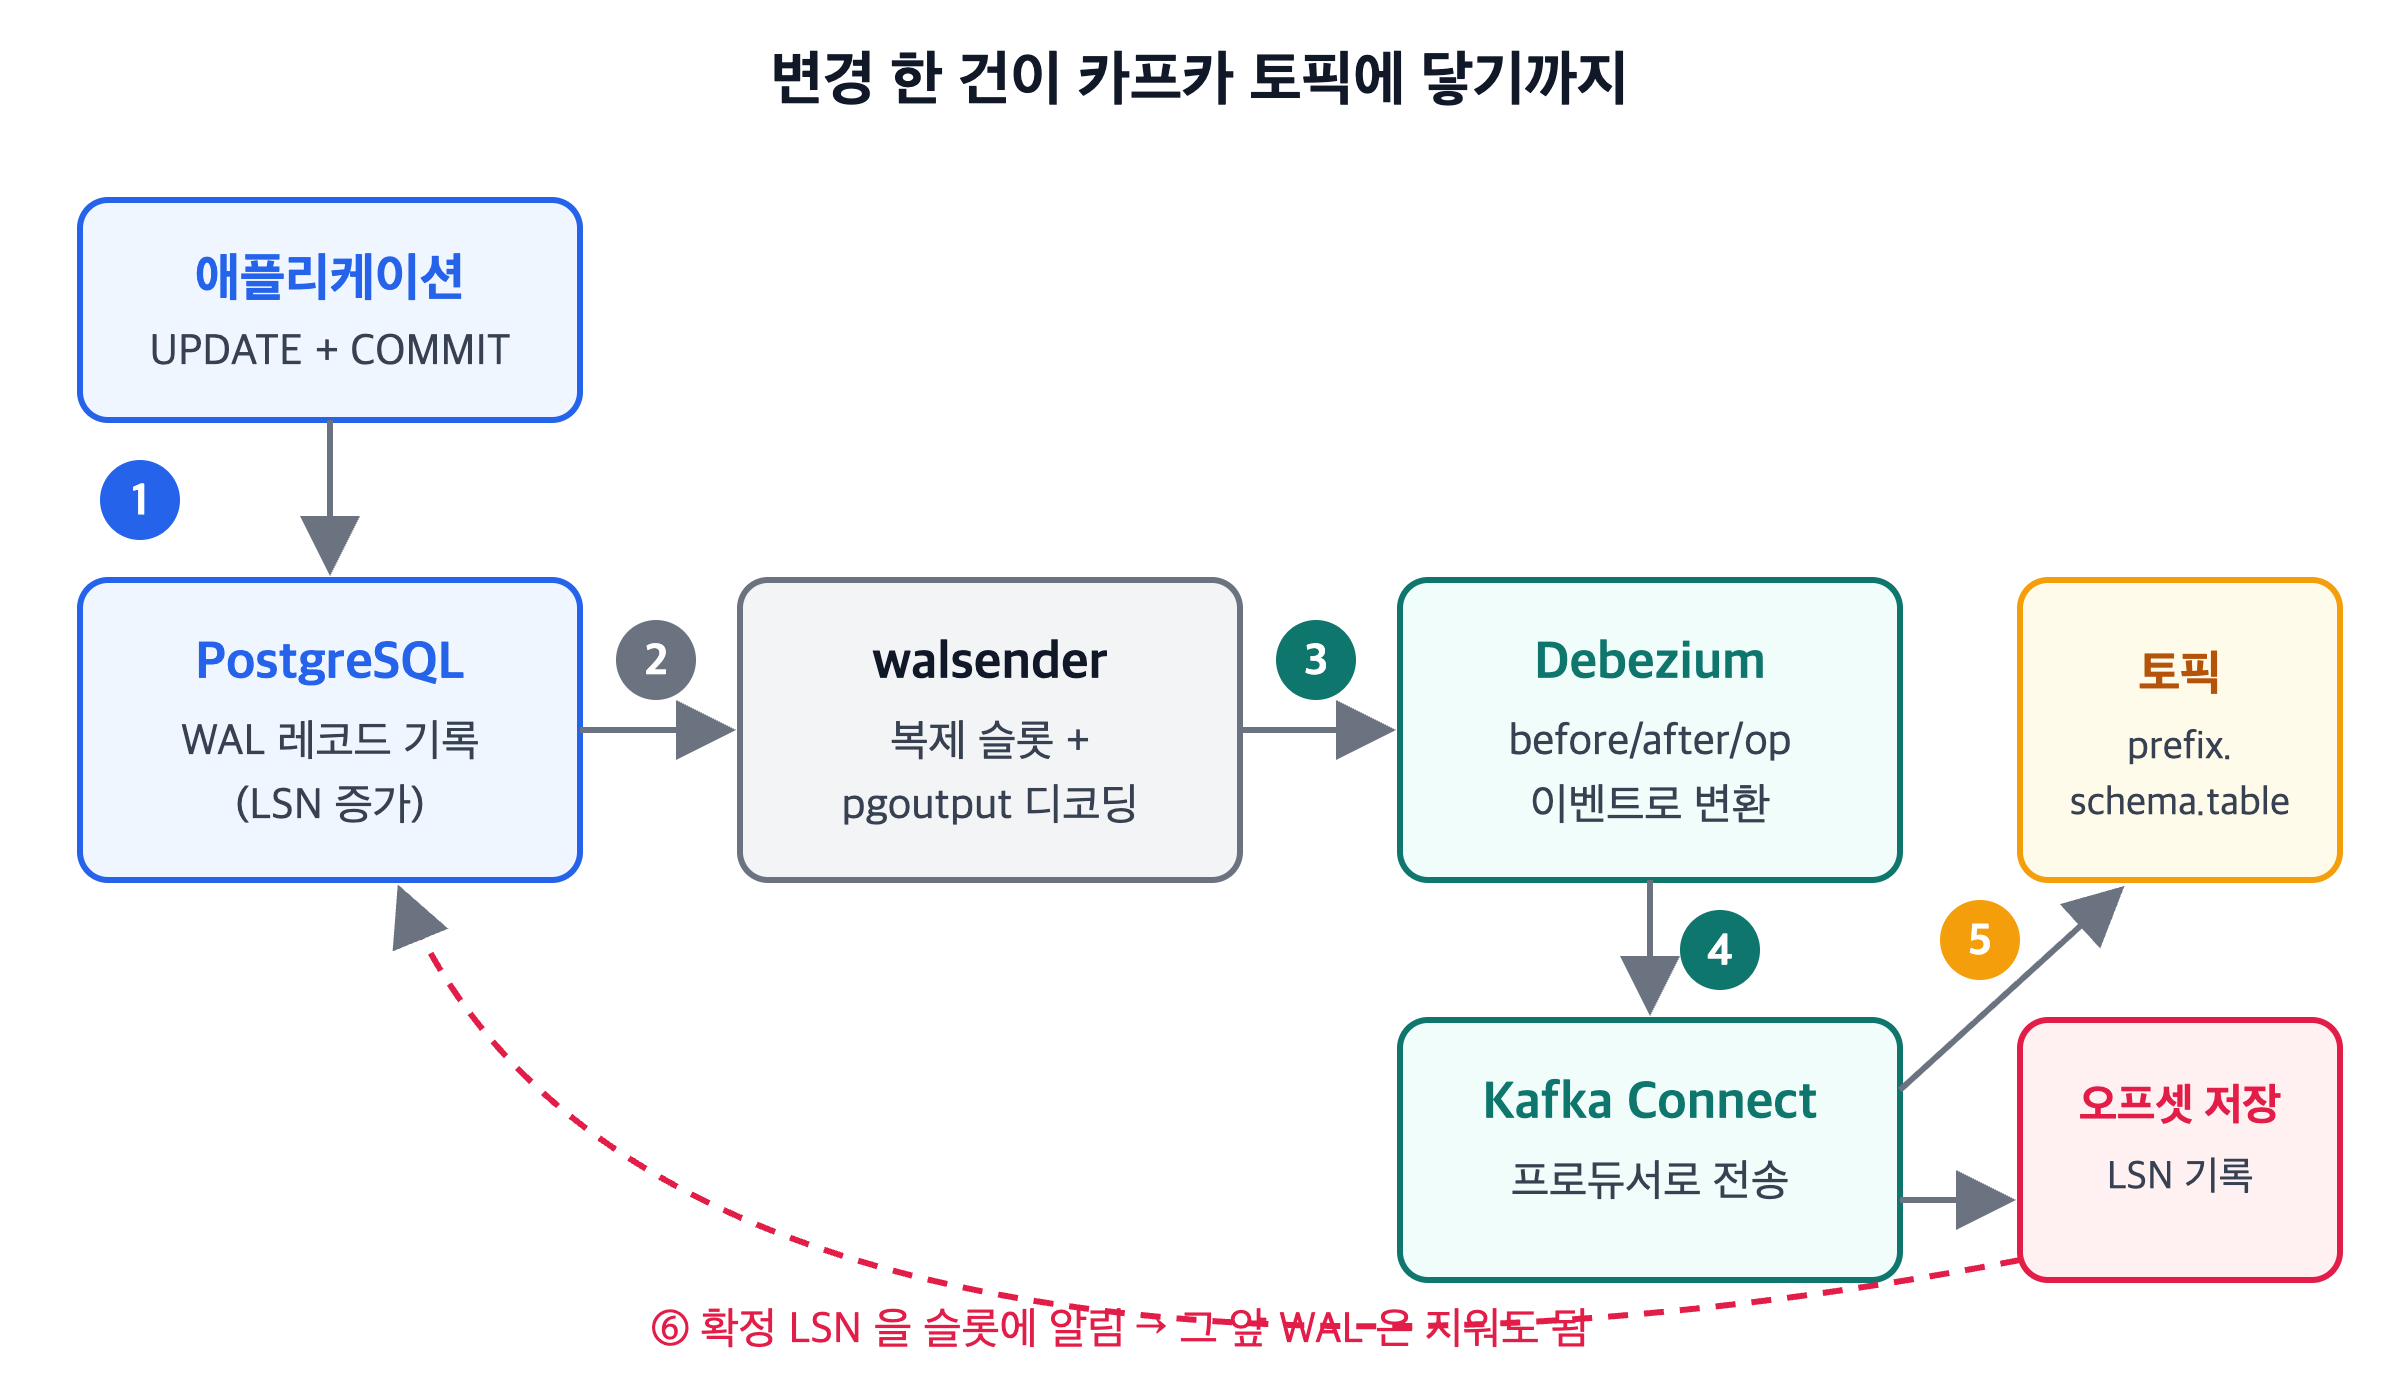
① 커밋이 WAL 에 남는다
애플리케이션이 UPDATE orders SET status='PAID' WHERE id=42 를 실행하고 커밋합니다. PostgreSQL 은 데이터 파일을 고치기 전에 이 변경을 WAL 에 먼저 씁니다. WAL 의 각 위치는 LSN(Log Sequence Number)이라는 단조 증가 주소로 가리킵니다. 0/16B1970 같은 형태입니다.
WAL 은 원래 장애 복구와 물리 복제용입니다. 그래서 "어느 페이지의 어느 바이트가 바뀌었다"는 저장 수준의 기록입니다. 이것만으로는 "orders 테이블의 id=42 행이 이렇게 바뀌었다"를 알 수 없습니다. 이 기록을 행 단위로 다시 해석하려면 PostgreSQL 설정 wal_level = logical 이 필요합니다. 이 값이어야 논리 해석에 필요한 정보가 WAL 에 추가로 남습니다.
② 복제 슬롯과 출력 플러그인이 해석한다
PostgreSQL 공식 문서는 논리적 디코딩(logical decoding)을 "저장 수준의 변경을 기술하는 WAL 내용을 튜플 스트림이나 SQL 문 같은 애플리케이션용 형태로 디코딩하는 것"으로 설명합니다.
여기에 두 부품이 들어갑니다.
- 복제 슬롯(replication slot): 소비자 하나의 읽기 위치입니다. 문서 표현으로는 "원본 서버에서 일어난 순서대로 재생할 수 있는 변경 스트림"입니다. 슬롯은 연결과 무관하게 남고, 크래시에도 안전합니다. 한 슬롯은 한 데이터베이스의 변경만 내보내고, 한 번에 한 수신자만 읽을 수 있습니다.
- 출력 플러그인(output plugin): WAL 의 내부 표현을 소비자가 원하는 형식으로 바꿉니다. Debezium 은
decoderbufs와pgoutput을 지원합니다.pgoutput은 PostgreSQL 에 내장돼 있어 추가 설치가 필요 없습니다. 참고로 Debezium 의plugin.name기본값은decoderbufs이므로, 관리형 DB 에서는 대개pgoutput을 명시해야 합니다.
pgoutput 을 쓰면 퍼블리케이션(publication)도 필요합니다. 어떤 테이블의 변경을 내보낼지 정하는 목록입니다. Debezium 은 기본 이름 dbz_publication 으로 이것을 만들 수 있습니다.
실제 전송은 walsender 프로세스가 맡습니다. Debezium 이 복제 프로토콜로 접속하면 walsender 가 슬롯 위치부터 WAL 을 읽고, 출력 플러그인을 거쳐 행 단위 변경을 흘려 보냅니다. 중요한 점은 커밋된 트랜잭션만, 커밋 순서대로 나온다는 것입니다. 롤백된 변경은 소비자에게 가지 않습니다. 이중 쓰기의 유령 이벤트 문제가 여기서 사라집니다.
③ Debezium 이 변경 이벤트로 바꾼다
Debezium PostgreSQL 커넥터는 받은 변경을 키와 값으로 된 이벤트로 바꿉니다. 키는 기본적으로 테이블의 기본 키입니다. 값은 다음 필드로 이뤄집니다.
| 필드 | 뜻 |
|---|---|
before |
변경 전 행. 채워지는 정도는 테이블의 REPLICA IDENTITY 에 따라 다름 |
after |
변경 후 행. 삭제면 null |
op |
c 생성, u 수정, d 삭제, r 스냅숏 읽기 |
source |
커넥터 이름, DB·스키마·테이블, lsn, txId, 스냅숏 여부 등 메타데이터 |
ts_ms |
커넥터가 이벤트를 처리한 시각 |
id=42 의 UPDATE 는 대략 이런 값이 됩니다.
{
  "before": null,
  "after":  { "id": 42, "status": "PAID", "amount": 15000 },
  "source": { "connector": "postgresql", "schema": "public", "table": "orders",
              "lsn": 24023128, "txId": 555, "snapshot": "false" },
  "op": "u",
  "ts_ms": 1761210000000
}
before 가 null 인 이유는 테이블의 복제 식별자(replica identity)가 기본값 DEFAULT 이기 때문입니다. 이 설정에서는 기본 키가 바뀌지 않은 UPDATE 에 이전 값이 실리지 않습니다. 이 값이 WAL 에 "이전 값"을 얼마나 남길지를 정합니다.
| REPLICA IDENTITY | before 에 남는 것 |
비고 |
|---|---|---|
DEFAULT |
DELETE 는 기본 키, UPDATE 는 기본 키가 바뀐 경우만 | 기본 키가 없으면 UPDATE·DELETE 이벤트가 안 나옴 |
NOTHING |
없음 | |
FULL |
모든 컬럼 | WAL 이 그만큼 커짐 |
INDEX |
지정한 인덱스의 컬럼 |
삭제는 한 건이 아니라 두 건으로 나갑니다. 먼저 op: "d" 이벤트, 이어서 같은 키에 값이 null 인 툼스톤(tombstone) 이벤트입니다. 카프카 로그 컴팩션이 이 키를 지워도 된다는 신호입니다. tombstones.on.delete 기본값이 true 라서 따로 끄지 않으면 늘 나옵니다.
④ Kafka Connect 가 토픽에 쓴다
Debezium 은 보통 Kafka Connect 위에서 소스 커넥터로 돕니다. Kafka Connect 는 카프카 브로커와 별개로 도는 서비스이고, 커넥터가 만든 레코드를 받아 카프카에 씁니다.
토픽은 테이블마다 하나입니다. Debezium 문서는 "기본적으로 한 테이블의 변경은 그 테이블 이름에 해당하는 토픽에 쓰인다"고 합니다. 이름 앞에는 topic.prefix 가 붙어 shop.public.orders 같은 형태가 됩니다. 메시지 키가 기본 키이므로 같은 행의 변경은 같은 파티션에 들어가고, 그 안에서 순서가 유지됩니다.
카프카 없이 쓰는 길도 있습니다. Debezium Server 는 Kinesis·Pub/Sub·Pulsar 같은 곳으로 직접 보내는 독립 실행 앱이고, Debezium Engine 은 자바 애플리케이션 안에 라이브러리로 넣는 방식입니다.
⑤ 오프셋을 기록하고 ⑥ 슬롯에 확정 위치를 알린다
Debezium 문서에 따르면 PostgreSQL 커넥터의 오프셋은 각 이벤트에 기록된 LSN 입니다. Kafka Connect 는 이 오프셋을 주기적으로 저장합니다. 재시작하면 마지막으로 저장한 LSN 부터 다시 읽습니다.
동시에 커넥터는 "여기까지 처리했다"는 위치를 PostgreSQL 에 알려 줍니다. 슬롯의 confirmed_flush_lsn 이 앞으로 나가고, 그보다 오래된 WAL 은 그제야 지울 수 있게 됩니다. 이 되먹임이 끊기면 무슨 일이 생기는지가 오해 절의 핵심입니다.
처음 붙일 때 — 스냅숏과 스트리밍 이어 붙이기
WAL 은 영원히 남지 않습니다. 커넥터를 처음 붙이는 시점에 이미 있던 행은 로그에 없을 수 있습니다. 그래서 Debezium 은 먼저 스냅숏을 뜹니다.
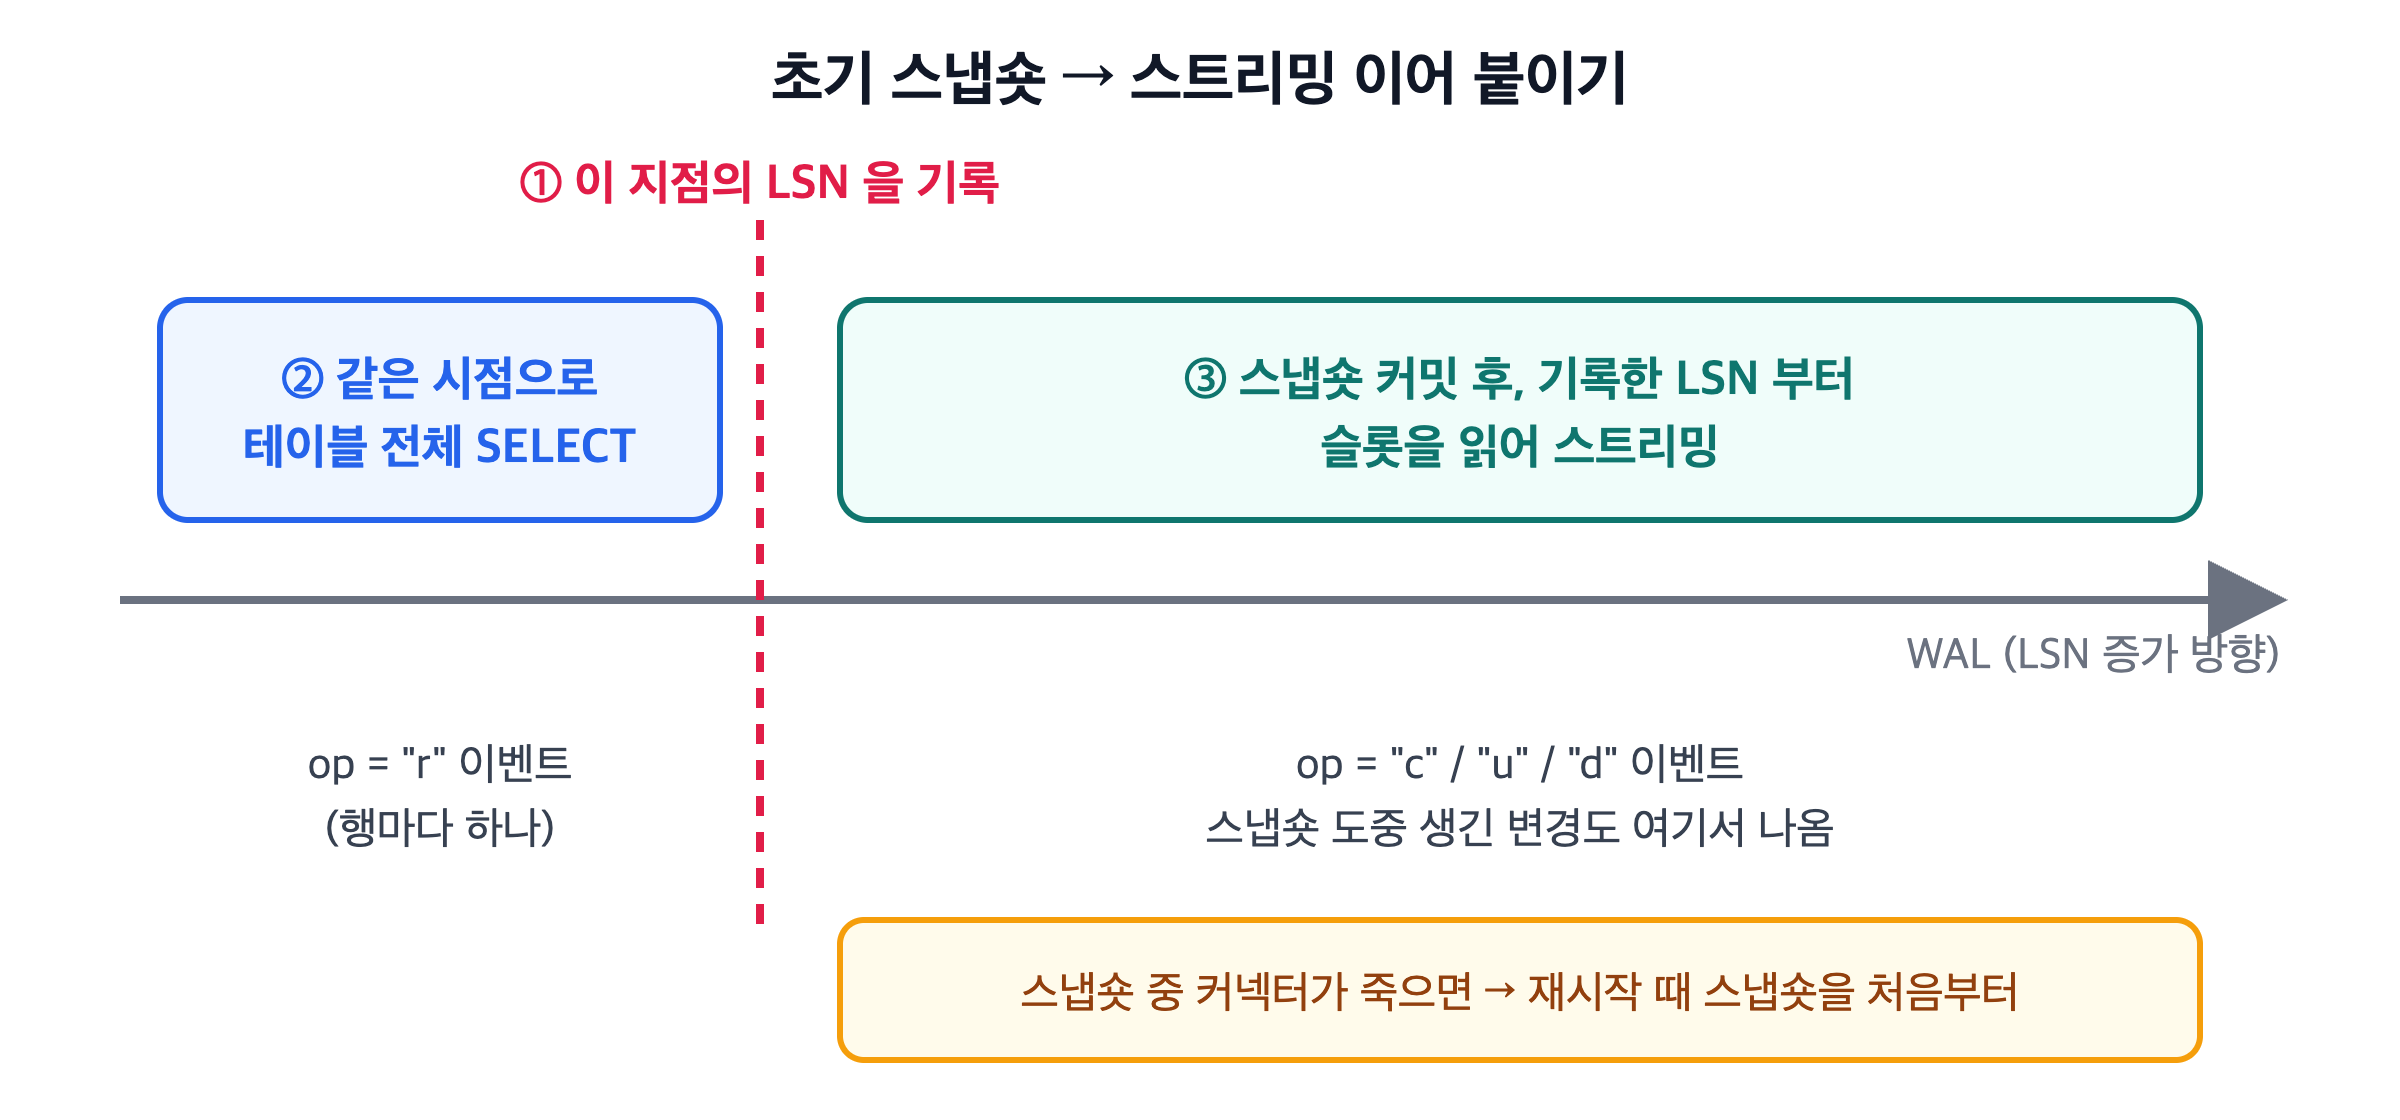
기본 모드 initial 의 순서는 이렇습니다.
- 트랜잭션을 엽니다.
- 현재 트랜잭션 로그 위치(LSN)를 읽어 둡니다.
- 대상 테이블을 전부 읽습니다. 행마다
op: "r"이벤트를 냅니다. - 트랜잭션을 커밋하고 스냅숏 완료를 오프셋에 기록합니다.
- 2단계에서 기록한 위치부터 슬롯을 읽어 스트리밍합니다.
3단계 동안 들어온 변경은 5단계에서 나옵니다. 그래서 빠지는 변경이 없습니다. 다만 스냅숏 도중 커넥터가 멈추면, 재시작할 때 스냅숏을 처음부터 다시 합니다. 큰 테이블이면 이 비용이 큽니다.
initial 외에 always, initial_only, no_data, when_needed, configuration_based, custom 모드가 있습니다. 기존 데이터가 필요 없고 지금부터의 변경만 원하면 no_data 를 씁니다.
직접 해 보기
1. 카프카 없이 논리적 디코딩만 보기
PostgreSQL 에 내장된 test_decoding 플러그인으로 슬롯이 어떻게 동작하는지 바로 볼 수 있습니다. 도커만 있으면 됩니다.
docker run -d --name pg-cdc -e POSTGRES_PASSWORD=pw -p 5432:5432 \
  postgres:18 -c wal_level=logical
docker exec -it pg-cdc psql -U postgres
SELECT * FROM pg_create_logical_replication_slot('demo_slot', 'test_decoding');

CREATE TABLE orders(id serial PRIMARY KEY, status text);

BEGIN;
INSERT INTO orders(status) VALUES ('NEW');
UPDATE orders SET status = 'PAID' WHERE id = 1;
COMMIT;

BEGIN;
INSERT INTO orders(status) VALUES ('GHOST');
ROLLBACK;

-- 읽되 소비하지 않음: 몇 번을 불러도 같은 결과
SELECT lsn, xid, data FROM pg_logical_slot_peek_changes('demo_slot', NULL, NULL);
결과는 이런 모양입니다(LSN·xid 값은 환경마다 다릅니다).
    lsn    | xid |                          data
-----------+-----+----------------------------------------------------------
 0/1A2A010 | 749 | BEGIN 749
 0/1A2B2F8 | 749 | COMMIT 749
 0/1A2B3C0 | 750 | BEGIN 750
 0/1A2B3C0 | 750 | table public.orders: INSERT: id[integer]:1 status[text]:'NEW'
 0/1A2B4F8 | 750 | table public.orders: UPDATE: id[integer]:1 status[text]:'PAID'
 0/1A2B5A0 | 750 | COMMIT 750
볼 점이 셋입니다. CREATE TABLE 은 내용 없이 BEGIN·COMMIT 만 나옵니다. 공식 문서도 "DDL 은 복제되지 않는다"고 적고 있습니다. 롤백한 GHOST 도 나오지 않습니다. INSERT 와 UPDATE 는 같은 xid 아래 BEGIN·COMMIT 으로 묶여 나옵니다.
이제 소비해 봅니다.
SELECT count(*) FROM pg_logical_slot_get_changes('demo_slot', NULL, NULL);  -- 6
SELECT count(*) FROM pg_logical_slot_get_changes('demo_slot', NULL, NULL);  -- 0

SELECT slot_name, active, restart_lsn, confirmed_flush_lsn FROM pg_replication_slots;
SELECT pg_drop_replication_slot('demo_slot');
get 으로 읽으면 슬롯 위치가 앞으로 나가서 두 번째 호출은 비어 있습니다. Debezium 이 하는 일도 본질적으로 같습니다. 복제 프로토콜로 계속 받아 가며 위치를 확정할 뿐입니다. 마지막 줄의 슬롯 삭제는 꼭 하세요. 이유는 아래 오해 절에 있습니다.
2. Debezium 커넥터 등록
Kafka Connect 가 떠 있고 Debezium PostgreSQL 커넥터 플러그인이 설치돼 있다면, REST API 로 커넥터를 등록합니다.
curl -X POST http://localhost:8083/connectors \
  -H 'Content-Type: application/json' \
  -d '{
    "name": "shop-connector",
    "config": {
      "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
      "plugin.name": "pgoutput",
      "database.hostname": "pg-cdc",
      "database.port": "5432",
      "database.user": "postgres",
      "database.password": "pw",
      "database.dbname": "postgres",
      "topic.prefix": "shop",
      "table.include.list": "public.orders",
      "slot.name": "shop_slot",
      "publication.autocreate.mode": "filtered"
    }
  }'
publication.autocreate.mode 를 filtered 로 두면 table.include.list 에 있는 테이블만 퍼블리케이션에 넣습니다. 등록하면 커넥터가 슬롯을 만들고, orders 를 스냅숏한 뒤, shop.public.orders 토픽으로 변경을 흘립니다. 커넥터마다 slot.name 은 서로 달라야 합니다. 한 슬롯은 한 번에 한 수신자만 읽을 수 있기 때문입니다.
흔한 오해와 실수
"커넥터를 잠깐 꺼 둬도 괜찮다" — 슬롯이 디스크를 채운다
가장 흔한 사고입니다. 슬롯은 소비자가 연결돼 있지 않아도 남습니다. 그리고 소비자가 확정하지 않은 위치 이후의 WAL 을 지우지 못하게 막습니다.

PostgreSQL 문서는 이렇게 경고합니다. 슬롯은 연결이 없어도 필요한 자원의 삭제를 막고, 그 결과 WAL 과 시스템 카탈로그 행을 VACUUM 이 지우지 못해 저장 공간을 차지하며, 극단적인 경우 트랜잭션 ID 랩어라운드를 막으려고 DB 가 멈출 수 있다고 합니다. 그래서 "더 필요 없는 슬롯은 지워야 한다"고 적습니다.
커넥터를 지웠는데 슬롯을 남겨 두면 이 상태가 영원히 계속됩니다. 대응은 셋입니다.
- 커넥터를 내릴 때
pg_drop_replication_slot()으로 슬롯도 지웁니다. max_slot_wal_keep_size로 슬롯이 붙잡을 WAL 의 상한을 둡니다. 기본값-1은 무제한입니다. 상한을 넘으면 그 슬롯을 쓰는 소비자는 필요한 WAL 이 지워져 이어 읽지 못할 수 있습니다. 디스크를 지키는 대신 CDC 를 다시 스냅숏부터 시작해야 할 수 있다는 뜻입니다.- PostgreSQL 18 문서에는
idle_replication_slot_timeout도 있습니다. 일정 시간 쓰이지 않은 슬롯을 체크포인트 때 무효화합니다. 기본값0은 꺼짐입니다.
pg_replication_slots 뷰의 active, restart_lsn 을 모니터링 대상에 넣어 두는 것이 가장 확실합니다.
"커넥터는 잘 도는데 WAL 이 계속 쌓인다" — 조용한 테이블
커넥터가 살아 있어도 WAL 이 쌓일 수 있습니다. DB 전체에는 쓰기가 많은데 캡처 대상 테이블에는 변경이 거의 없는 경우입니다. 커넥터가 보낼 이벤트가 없으니 확정 위치도 앞으로 나가지 않습니다. Debezium 문서는 이 상황을 주기적 하트비트 이벤트로 해결하라고 안내합니다. heartbeat.interval.ms 를 설정하면 됩니다. 기본값은 0, 즉 하트비트를 보내지 않습니다.
"CDC 면 이벤트가 정확히 한 번 온다" — 아닙니다
Debezium FAQ 는 정상 동작과 정상 종료에서는 이벤트를 정확히 한 번 본다고 합니다. 하지만 커넥터가 크래시하면 마지막으로 기록된 오프셋부터 다시 읽으므로 일부 이벤트가 다시 기록되고, 그 중복은 소비자에게 그대로 보인다고 적습니다. PostgreSQL 문서도 크래시 뒤에는 슬롯이 최근 변경을 다시 내보낼 수 있으니 소비자가 중복을 처리해야 한다고 합니다.
그래서 소비자는 멱등하게 짭니다. 기본 키 기준 upsert, 또는 source.lsn 을 행별로 저장해 두고 그보다 작거나 같은 이벤트는 버리는 식입니다.
"before 가 비어 있다", "UPDATE 이벤트가 안 온다"
REPLICA IDENTITY DEFAULT 에서는 DELETE 의 before 에 기본 키만 들어가고, 기본 키를 건드리지 않은 UPDATE 는 before 가 비어 있습니다. 변경 전 값 전체가 필요하면 ALTER TABLE orders REPLICA IDENTITY FULL; 이 필요합니다. 기본 키가 없는 테이블은 DEFAULT 상태에서 UPDATE·DELETE 이벤트 자체가 나오지 않습니다. 감사(audit) 용도로 CDC 를 붙였는데 이걸 놓치면 기록이 비어 있게 됩니다.
"삭제 이벤트에서 소비자가 NPE 로 죽는다"
삭제 뒤에 오는 툼스톤은 값이 null 입니다. 값이 늘 있다고 가정한 소비자는 여기서 죽습니다. 컴팩션 토픽이 아니라면 tombstones.on.delete=false 로 끄거나, 소비자에서 null 값을 건너뛰게 합니다.
"테이블 사이 순서도 지켜진다" — 토픽이 다르면 아닙니다
같은 행의 변경은 같은 키, 같은 파티션이라 순서가 유지됩니다. 하지만 orders 와 payments 는 다른 토픽입니다. 소비자가 두 토픽을 읽을 때 원본 커밋 순서대로 받는다는 보장은 없습니다. 여러 테이블에 걸친 사건을 순서대로 내보내야 한다면 아웃박스 패턴을 씁니다.
아웃박스 패턴 — CDC 로 이중 쓰기를 끝내는 법
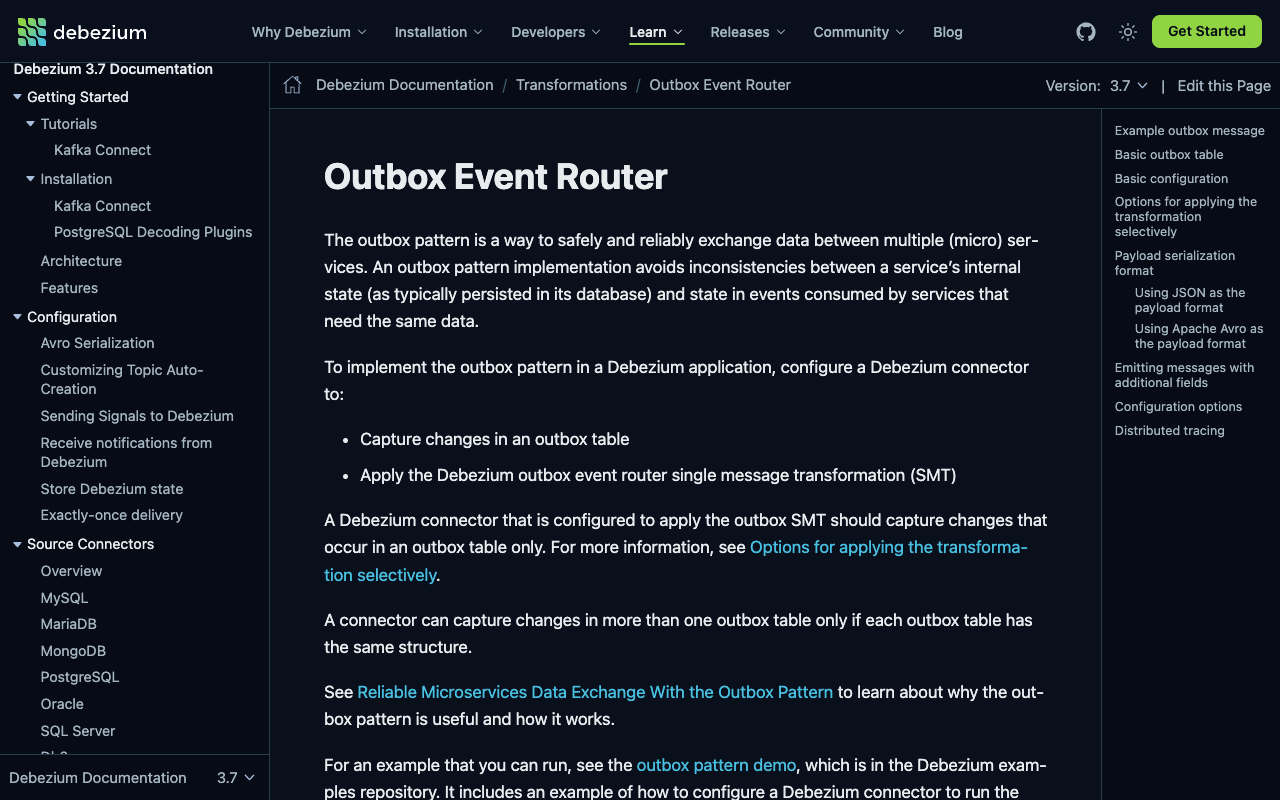
테이블 변경을 그대로 흘리면 내부 스키마가 외부 계약이 됩니다. 컬럼 이름 하나 바꿔도 소비자가 깨집니다. 아웃박스 패턴은 비즈니스 테이블과 같은 트랜잭션에서 outbox 테이블에 "발행할 이벤트"를 INSERT 하고, CDC 는 이 테이블만 캡처하는 방식입니다.
같은 DB 트랜잭션이므로 주문 저장과 이벤트 기록은 함께 커밋되거나 함께 롤백됩니다. 처음 말한 이중 쓰기 문제가 구조적으로 사라집니다.
Debezium 은 이를 위한 변환(SMT)인 outbox event router 를 제공합니다. 기본 테이블 구조는 id, aggregatetype, aggregateid, type, payload 컬럼입니다. aggregatetype 값으로 토픽을 정하는데, 기본 규칙이 outbox.event.${routedByValue} 라서 aggregatetype='order' 면 outbox.event.order 토픽으로 갑니다. aggregateid 는 메시지 키가 되므로 같은 주문의 이벤트는 같은 파티션에서 순서를 지킵니다.
정리
- CDC 는 애플리케이션이 이벤트를 따로 보내지 않고, DB 가 이미 쓴 트랜잭션 로그(WAL)를 복제 슬롯으로 읽어 커밋된 변경만 순서대로 카프카에 흘립니다.
- Debezium 은 스냅숏 시점 LSN 을 기록해 두고 스냅숏 뒤 그 지점부터 스트리밍하며, 오프셋(LSN)과 슬롯 확정 위치로 재시작 지점을 맞춥니다.
- 운영의 핵심은 세 가지입니다. 버려진 슬롯이 WAL 을 붙잡지 않게 하고, 중복을 견디는 멱등 소비자를 짜고,
REPLICA IDENTITY·툼스톤 동작을 알고 쓰는 것입니다.
smith lab 에서 이어서 보기
smith lab(smithlab.co.kr)은 설치·로그인 없이 브라우저에서 바로 쓰는 개발자 도구와 실무 글을 모아 둔 곳입니다. 개발 글 모음도 함께 보세요.
참고 자료
'Develop > [Kafka]' 카테고리의 다른 글
| 카프카 KRaft 원리 — 주키퍼 없는 메타데이터 합의 (0) | 2026.10.27 |
|---|---|
| 카프카 파티션과 오프셋 원리 — 세그먼트·인덱스·하이 워터마크 (0) | 2026.10.26 |
| 카프카 Exactly-once 원리 — 멱등 프로듀서·트랜잭션·LSO (0) | 2026.10.25 |
| 카프카 컨슈머 그룹 리밸런싱은 왜 멈춤을 만드나 — KIP-848 (0) | 2026.10.13 |
| [Kafka] 파티셔너 (0) | 2023.08.31 |


