"카프카는 정확히 한 번 전송을 지원한다." 이 문장을 그대로 믿고 설정 하나만 켰다가, 결제 알림이 두 번 나가는 장애를 겪는 팀이 꽤 있습니다. 카프카의 Exactly-once 는 마법 스위치가 아닙니다. 멱등 프로듀서, 트랜잭션 코디네이터, 로그에 박히는 커밋 마커, 컨슈머의 격리 수준이 맞물려 돌아가는 프로토콜입니다. 이 글은 그 톱니바퀴가 요청 단위로 어떻게 맞물리는지 순서대로 풉니다. 근거는 KIP-98(설계 원문)과 Apache Kafka 4.3 공식 설정 문서입니다.
1. 왜 생겼나 — 재시도가 중복을 만든다
분산 시스템에서 메시지 전달 보장은 보통 세 갈래로 나눕니다.
- 최대 한 번(at-most-once): 실패하면 다시 보내지 않습니다. 유실될 수 있습니다.
- 최소 한 번(at-least-once): 응답이 없으면 다시 보냅니다. 중복될 수 있습니다.
- 정확히 한 번(exactly-once): 유실도 중복도 없습니다.
카프카 프로듀서는 기본적으로 재시도를 합니다. 문제는 "응답이 안 왔다"가 "기록이 안 됐다"를 뜻하지 않는다는 점입니다. 브로커는 배치를 로그에 잘 썼는데 응답 패킷만 네트워크에서 사라질 수 있습니다. 프로듀서는 실패로 보고 같은 배치를 다시 보냅니다. 로그에는 같은 메시지가 두 번 쌓입니다.
컨슈머 쪽에도 같은 구멍이 있습니다. 전형적인 "읽고 → 가공하고 → 다른 토픽에 쓰는(consume-transform-produce)" 애플리케이션을 생각해 봅시다. 출력 토픽에 쓰기는 끝났는데 입력 오프셋을 커밋하기 직전에 프로세스가 죽으면, 재시작한 인스턴스는 같은 입력을 다시 읽고 다시 씁니다. 출력 쓰기와 오프셋 커밋이 하나의 원자적 단위가 아니기 때문입니다.
카프카는 이 두 문제를 각각 다른 장치로 막습니다.
| 문제 | 원인 | 카프카의 장치 | 도입 |
|---|---|---|---|
| 프로듀서 재시도로 인한 중복 | 응답 유실 후 재전송 | 멱등 프로듀서(PID + 시퀀스 번호) | 0.11.0.0 |
| 쓰기와 오프셋 커밋 사이 장애 | 둘이 따로 커밋됨 | 트랜잭션(여러 파티션 + 오프셋을 원자적으로) | 0.11.0.0 |
| 죽은 줄 알았던 옛 인스턴스의 쓰기 | 좀비 프로듀서 | transactional.id + 에포크 펜싱 |
0.11.0.0 |
| 컨슈머 그룹 리밸런스와 펜싱의 충돌 | 입력 파티션이 인스턴스 사이를 옮겨 다님 | 그룹 메타데이터 기반 펜싱(KIP-447) | 2.6.0 |
| 멈춰 버린 트랜잭션·늦게 도착한 쓰기 | 트랜잭션 경계가 흐릿함 | 서버 측 방어(KIP-890) 2단계 | 4.0 |
공식 문서의 설계 장(Message Delivery Semantics)은 0.11.0.0 부터 멱등 전송과 트랜잭션을 지원한다고 적고 있습니다. 동시에 한 줄을 덧붙입니다. 카프카 밖의 다른 저장소까지 정확히 한 번을 보장하려면 그 시스템의 협조가 필요하다는 것입니다. 이 단서가 뒤에 나올 "흔한 오해" 절의 핵심입니다.
2. 내부 동작 원리
2-1. 멱등 프로듀서 — 브로커가 중복을 알아보는 법
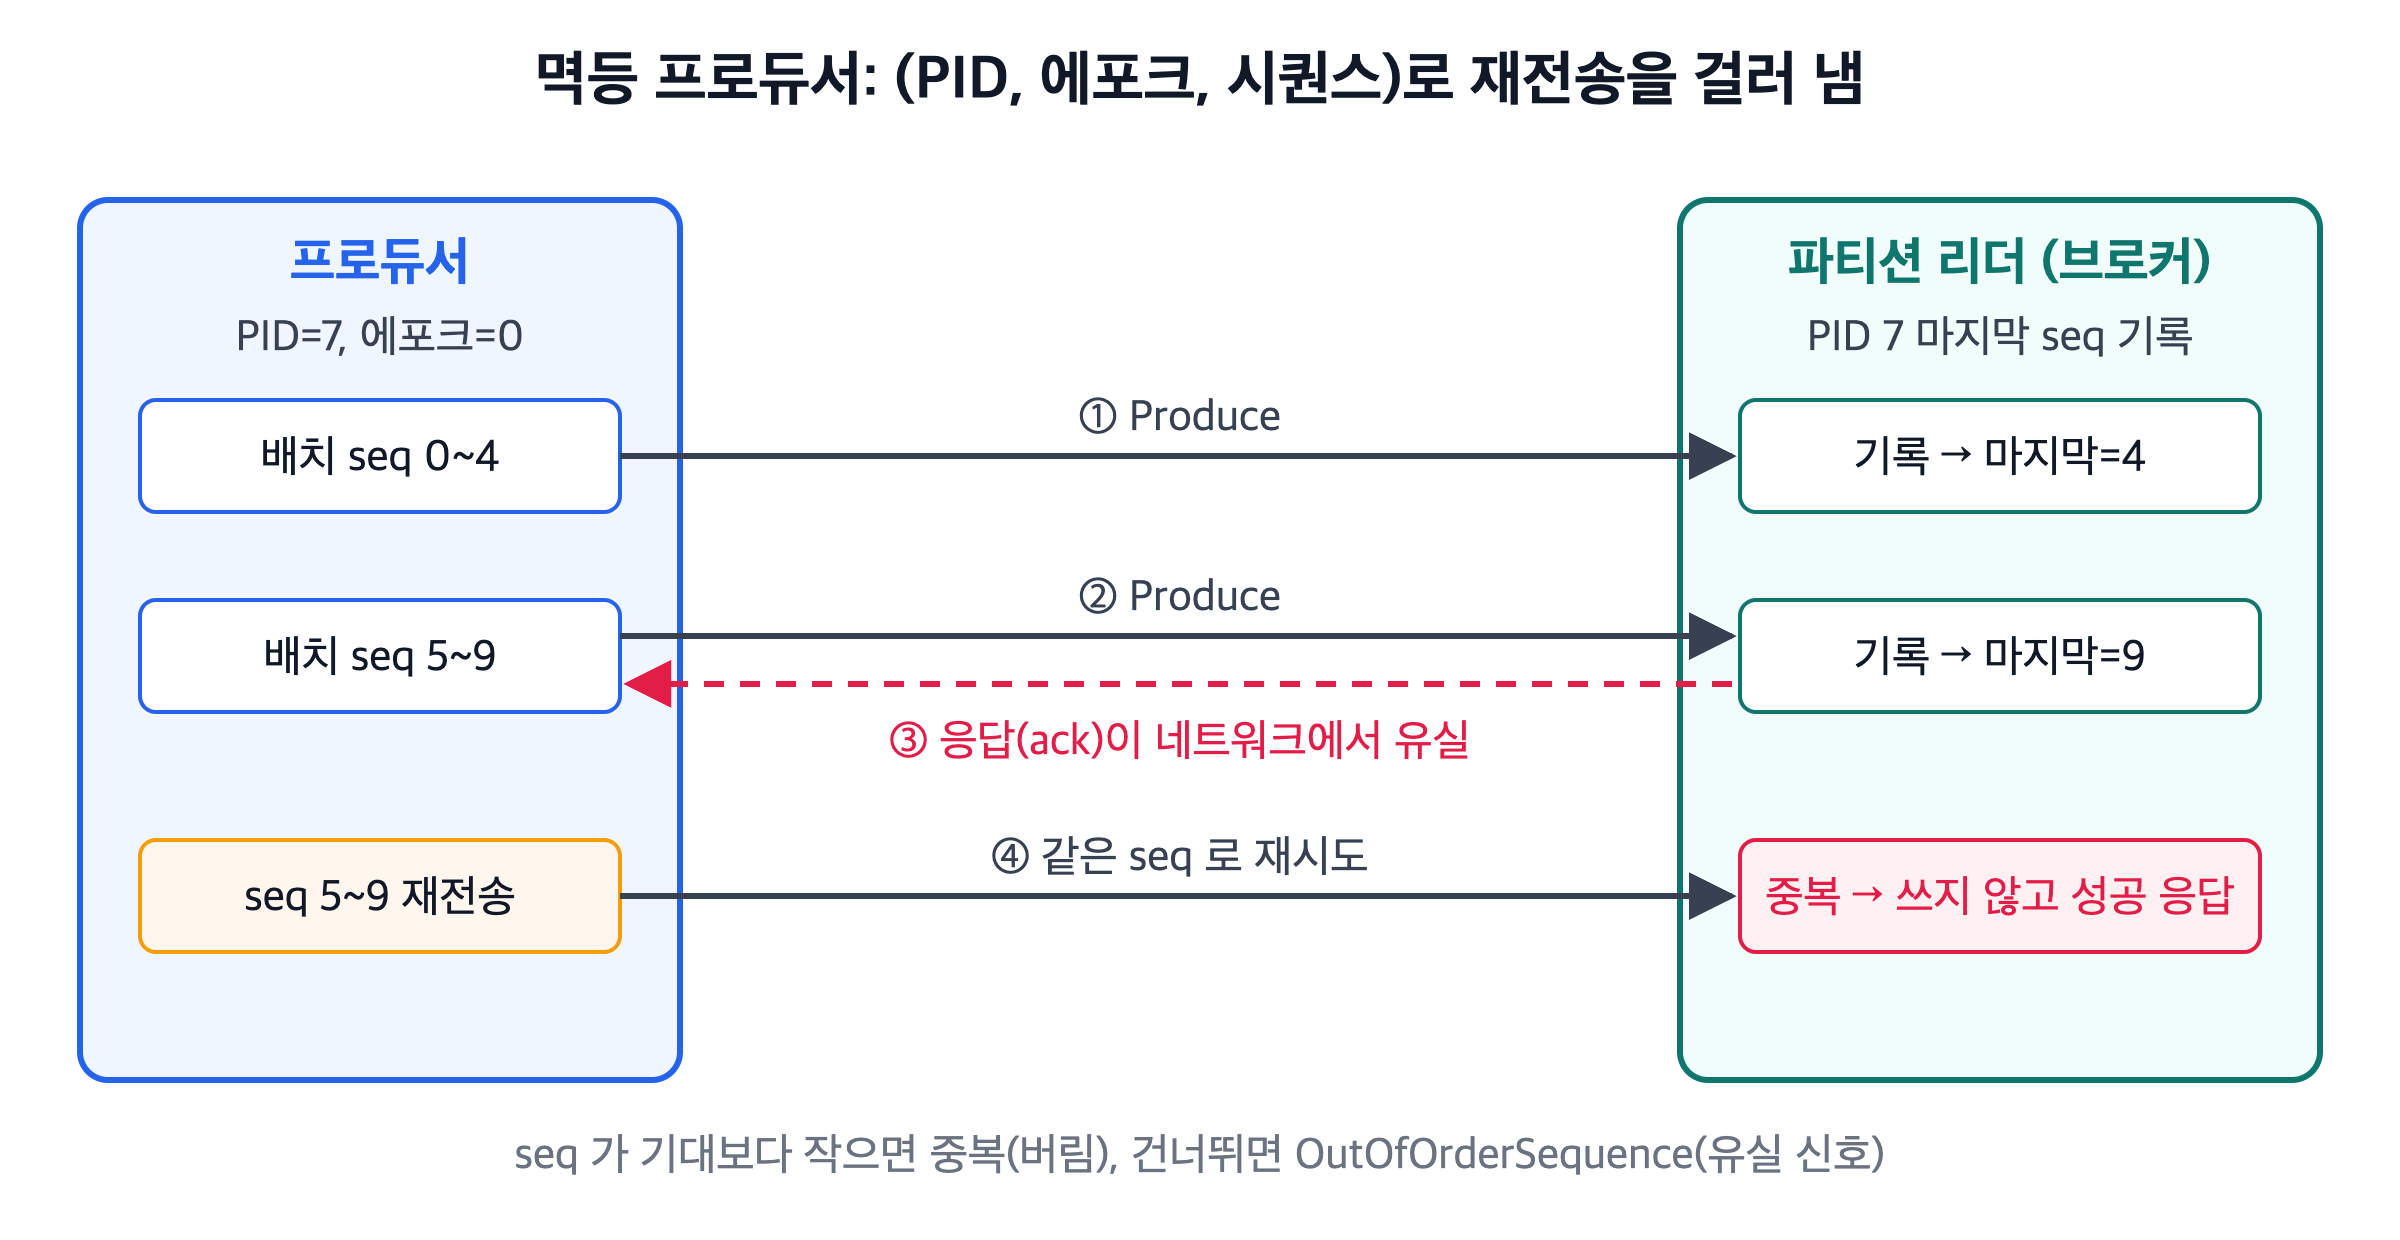
멱등 프로듀서는 세 개의 값으로 자신을 식별합니다.
- PID(Producer ID): 프로듀서가 처음 뜰 때 브로커에게서 받는 정수입니다.
- 에포크(epoch): 같은 PID 를 이어받은 세대 번호입니다. 펜싱에 쓰입니다.
- 시퀀스 번호: 파티션마다 0 부터 1씩 늘어나는 번호입니다. 배치 헤더에 첫 시퀀스가 실립니다.
파티션 리더 브로커는 PID 별로 "마지막으로 받은 시퀀스"를 기억합니다. 새 배치가 오면 셋 중 하나로 판정합니다.
- 기대한 다음 번호면 로그에 씁니다.
- 이미 받은 번호(작은 번호)면 중복입니다. 로그에 쓰지 않고 성공을 돌려줍니다. 프로듀서 입장에서는 재시도가 성공한 것처럼 보입니다.
- 번호가 건너뛰었으면(큰 번호) 중간 배치가 사라졌다는 뜻입니다.
OutOfOrderSequenceException이 납니다. KIP-98 은 이 경우를 데이터 유실 신호로 보고 치명적 오류로 다룹니다.
이 판정 덕분에 max.in.flight.requests.per.connection 이 1보다 커도 순서가 지켜집니다. 앞 배치가 실패하고 뒤 배치가 먼저 도착하면 시퀀스가 어긋나 거절되고, 프로듀서가 다시 순서대로 보냅니다. 공식 문서는 멱등성을 켜려면 이 값이 5 이하여야 한다고 못 박습니다.
Kafka 4.3 프로듀서 설정 문서 기준으로 멱등성은 이미 기본값입니다. 문서 문장은 "충돌하는 설정이 없으면 멱등성이 기본으로 켜진다"입니다. 관련 설정은 아래와 같습니다.
| 설정 | 기본값 | 멱등성과의 관계 |
|---|---|---|
enable.idempotence |
true |
충돌 설정이 있으면 조용히 꺼짐. 명시적으로 true 면 ConfigException |
acks |
all |
멱등성은 all 을 요구 |
retries |
2147483647 |
0 보다 커야 함 |
max.in.flight.requests.per.connection |
5 |
5 이하여야 함 |
transactional.id |
null |
지정하면 멱등성이 함께 켜짐. 없으면 트랜잭션 불가 |
transaction.timeout.ms |
60000 |
열린 트랜잭션을 코디네이터가 중단시키는 시간 |
여기서 한계가 하나 보입니다. PID 는 프로듀서 세션마다 새로 받습니다. 프로세스가 재시작하면 새 PID 로 시작하므로, 재시작 전에 보낸 배치와 재시작 후의 배치는 브로커가 같은 것으로 알아볼 수 없습니다. 멱등 프로듀서는 "한 세션, 한 파티션 안의 재시도 중복"만 막습니다. 세션과 파티션을 넘어서는 보장이 트랜잭션의 몫입니다.
2-2. 트랜잭션 — 한 번의 커밋이 흐르는 8단계
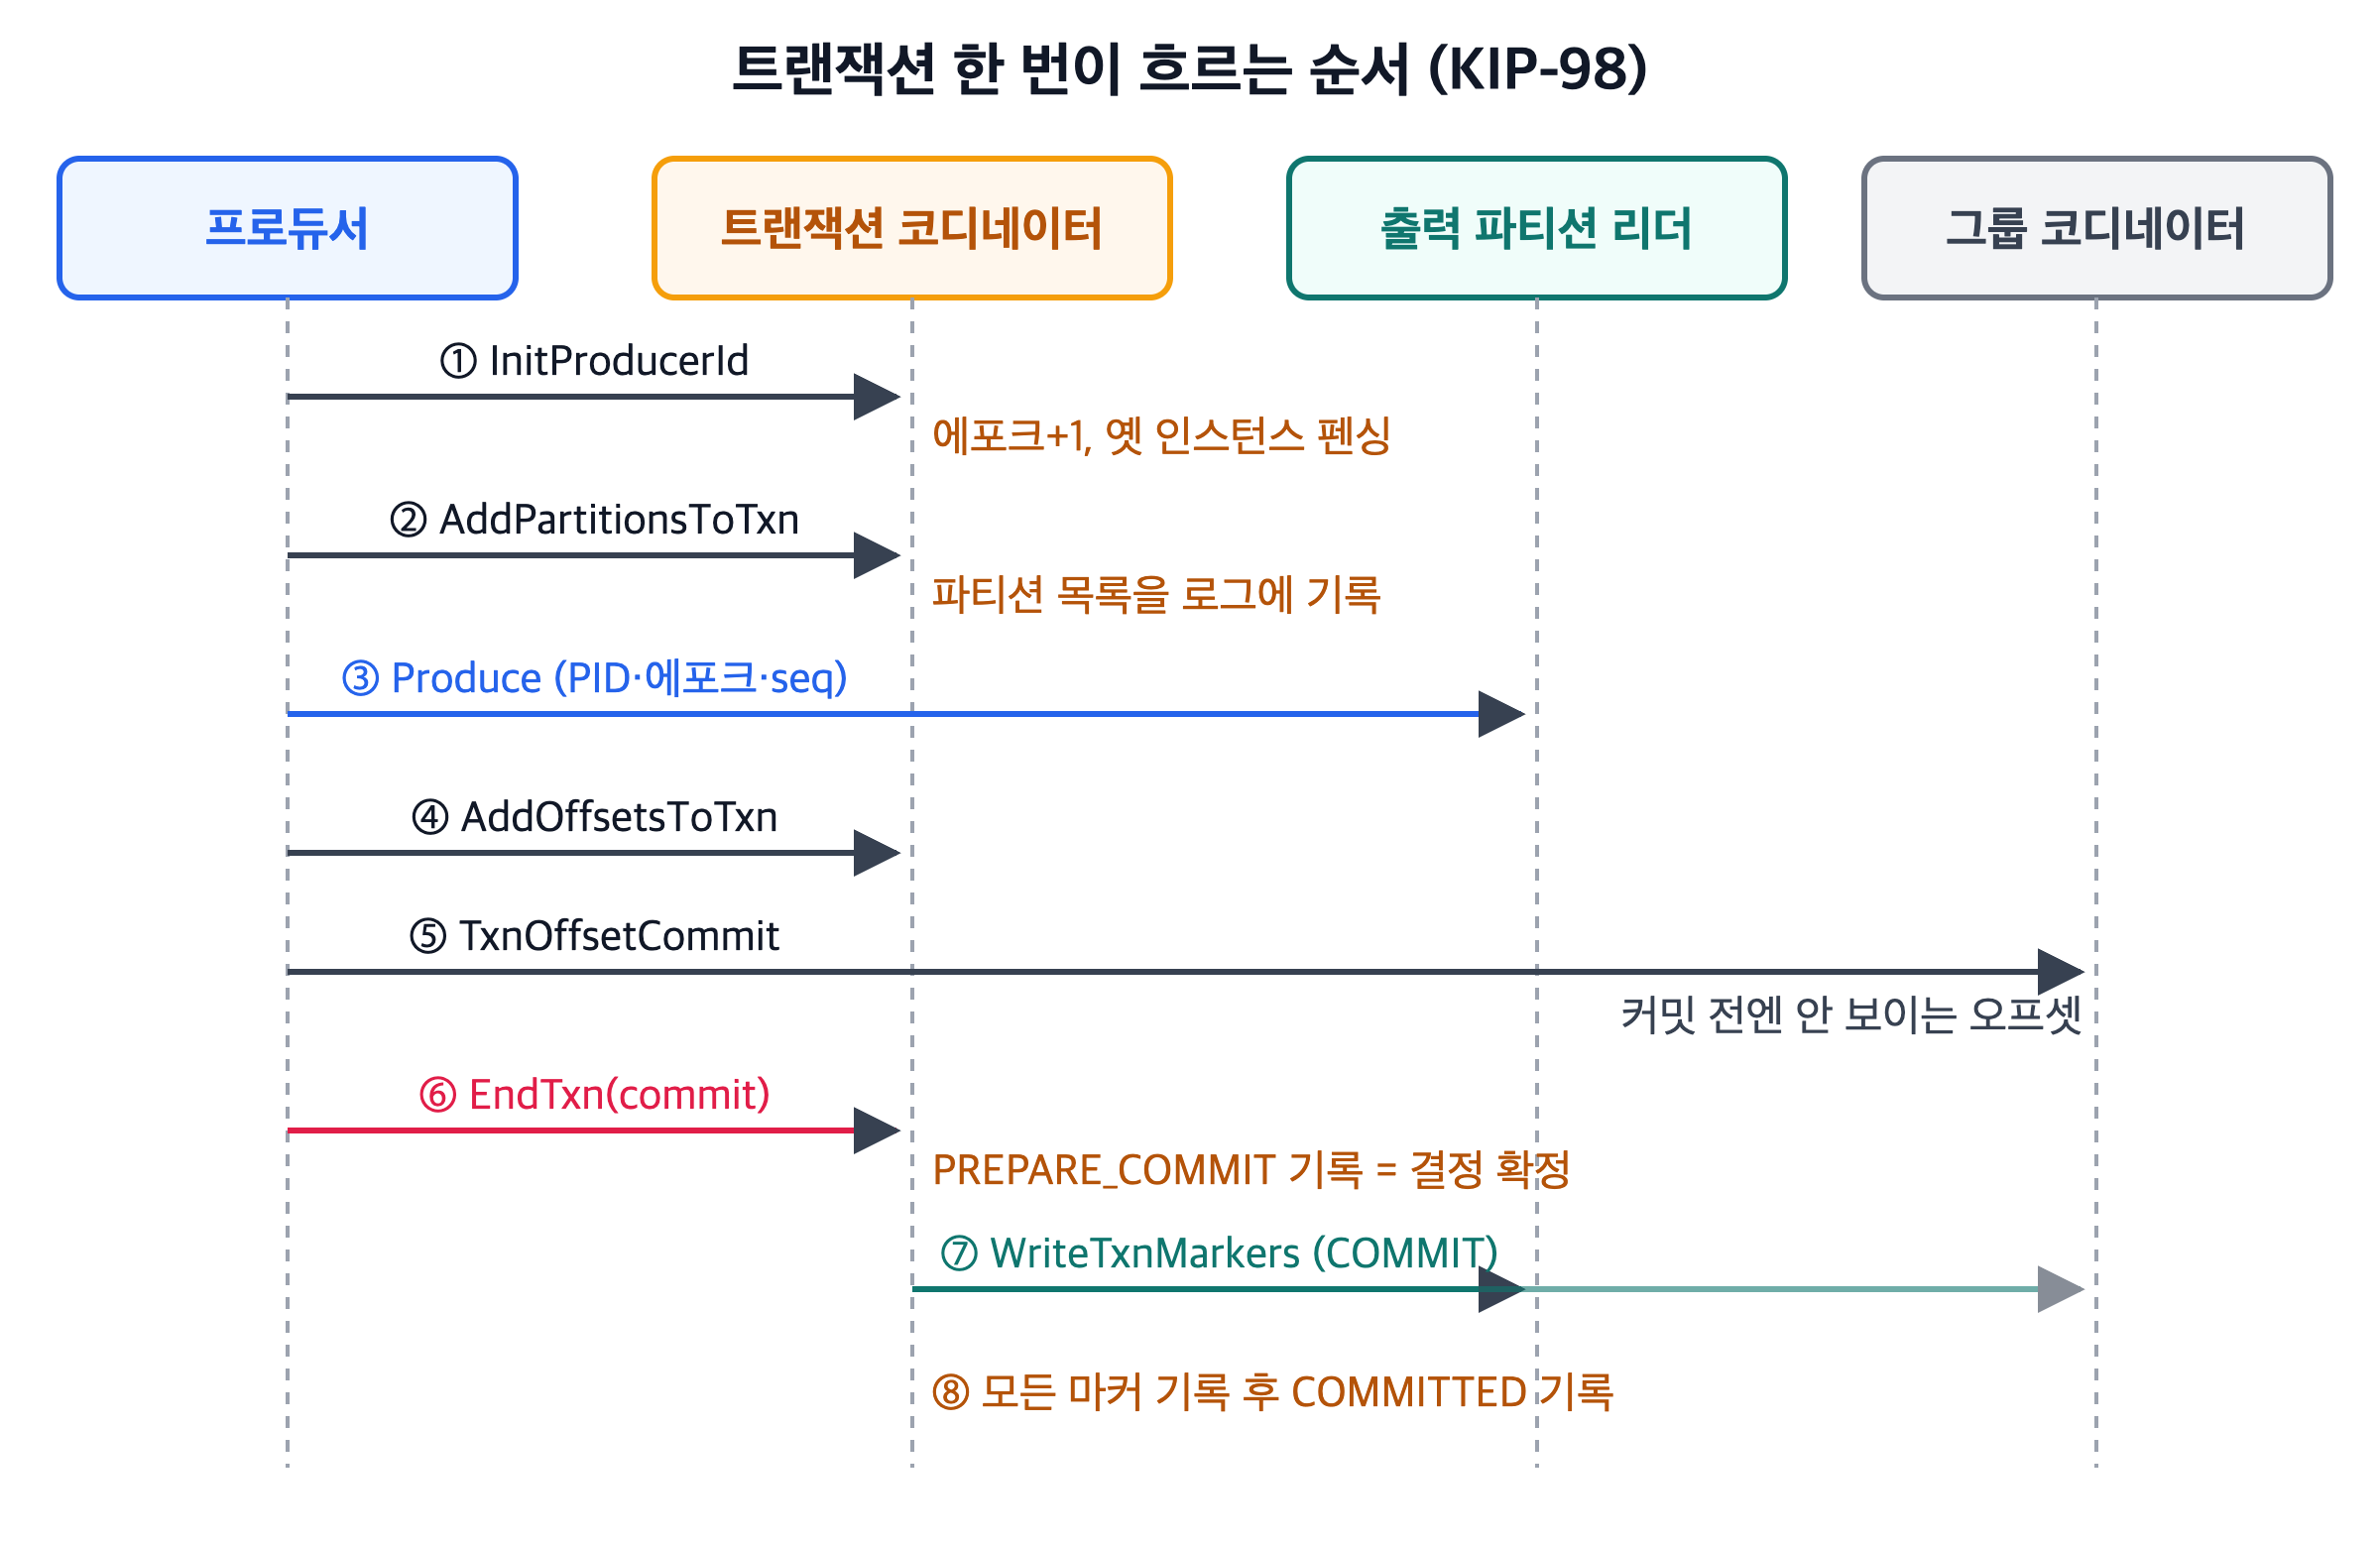
트랜잭션에는 새 참여자가 등장합니다. 트랜잭션 코디네이터입니다. 별도 서버가 아니라 브로커 안에서 도는 모듈입니다. 코디네이터는 상태를 내부 토픽인 트랜잭션 로그(__transaction_state)에 기록합니다. 이 토픽의 기본 파티션 수는 50, 복제 계수는 3, 최소 ISR 은 2 입니다(transaction.state.log.* 브로커 설정). transactional.id 의 해시로 파티션 하나가 정해지고, 그 파티션의 리더 브로커가 해당 프로듀서의 코디네이터가 됩니다.
KIP-98 이 정의한 순서를 그대로 따라가 봅니다.
- FindCoordinator: 프로듀서가 아무 브로커에게나 "내
transactional.id의 코디네이터가 누구냐"고 묻습니다. - InitProducerId: 코디네이터가
transactional.id에 묶인 PID 를 돌려주고 에포크를 1 올립니다. 같은 id 로 이전에 열려 있던 트랜잭션이 있으면 이 시점에 마무리(중단)합니다. 이것이 좀비 펜싱의 출발점입니다. - beginTransaction(): 클라이언트 내부 상태만 바뀝니다. 코디네이터는 아직 모릅니다.
- AddPartitionsToTxn: 트랜잭션 안에서 어떤 파티션에 처음 쓰기 직전에, 그 파티션을 코디네이터에 등록합니다. 코디네이터는 목록을 트랜잭션 로그에 남깁니다. 나중에 커밋 마커를 어디에 찍어야 할지 알기 위해서입니다. 첫 파티션이 등록될 때 트랜잭션 타이머가 시작됩니다.
- Produce: 실제 데이터를 파티션 리더에 보냅니다. 배치에는 PID·에포크·시퀀스와 함께 "트랜잭션 배치"라는 표시가 붙습니다. 데이터는 이 순간 이미 로그에 기록됩니다. 커밋을 기다렸다가 쓰는 게 아닙니다.
- AddOffsetsToTxn → TxnOffsetCommit:
sendOffsetsToTransaction()을 부르면, 먼저 코디네이터에__consumer_offsets파티션을 등록하고, 이어서 그룹 코디네이터에 입력 오프셋을 보냅니다. 이 오프셋은 기록되지만 트랜잭션이 커밋되기 전에는 유효한 커밋 오프셋으로 취급되지 않습니다. - EndTxn:
commitTransaction()이 코디네이터에 커밋을 요청합니다. 코디네이터는 먼저 트랜잭션 로그에PREPARE_COMMIT을 씁니다. 이 기록이 복제되는 순간 결과가 확정됩니다. 이후 코디네이터가 죽어도 새 코디네이터가 로그를 읽고 남은 일을 이어 갑니다. - WriteTxnMarkers: 코디네이터가 등록된 모든 파티션 리더에게 COMMIT 컨트롤 마커를 쓰게 합니다.
__consumer_offsets에도 마커가 찍히며 그 순간 오프셋이 반영됩니다. 마커가 전부 기록되면 코디네이터는COMMITTED를 남기고 트랜잭션을 끝냅니다.
중단(abort)도 같은 길을 갑니다. PREPARE_ABORT 를 쓰고 ABORT 마커를 찍습니다. 데이터는 지우지 않습니다. 로그는 추가만 하는 구조라서, 중단된 데이터는 그대로 남고 "읽을 때 건너뛰는" 방식으로 처리됩니다.
결국 카프카 트랜잭션은 2단계 커밋과 닮았습니다. 트랜잭션 로그의 PREPARE_* 기록이 결정 지점이고, 마커 쓰기가 반영 단계입니다. 차이는 참여자가 각자 투표하지 않는다는 점입니다. 데이터는 이미 다 써 놨으니 코디네이터 혼자 결정하고 통보합니다.
2-3. 펜싱 — 좀비 프로듀서를 막는 에포크
GC 가 길게 멈춘 인스턴스 A 를 오케스트레이터가 죽은 것으로 보고 B 를 띄웠다고 합시다. A 와 B 는 같은 transactional.id 를 씁니다. B 가 InitProducerId 를 부르면 에포크가 올라갑니다. 잠에서 깬 A 가 옛 에포크로 쓰기나 커밋을 시도하면 코디네이터와 브로커가 거절합니다. A 는 ProducerFencedException 을 받습니다. 프로듀서 Javadoc 은 이 예외를 "같은 transactional.id 를 가진 다른 프로듀서가 살아 있다"는 치명적 오류로 규정하고, 할 수 있는 일은 close() 뿐이라고 적습니다.
KIP-447 은 여기에 컨슈머 그룹 정보를 더했습니다. 과거에는 펜싱이 transactional.id 에만 의존했기 때문에, 입력 파티션마다 고정된 프로듀서를 둬야 했습니다. 카프카 스트림즈가 태스크마다 프로듀서를 만들던 이유입니다. 2.6.0 부터는 sendOffsetsToTransaction(offsets, consumer.groupMetadata()) 로 그룹의 세대(generation) 정보를 함께 보냅니다. 그룹 코디네이터는 이전 세대의 오프셋 커밋을 거절해 리밸런스 이전의 좀비를 막습니다. 스트림즈의 exactly_once_v2 가 스레드당 프로듀서 하나로 줄어든 배경입니다.
KIP-890(4.0 릴리스 노트에 "2단계 완료"로 기재)은 남은 틈을 메웠습니다. 커밋·중단 마커가 찍힐 때마다 에포크를 올려 트랜잭션 하나하나를 (PID, 에포크)로 구분합니다. 앞 트랜잭션의 늦게 도착한 쓰기가 다음 트랜잭션에 섞이는 일을 막기 위해서입니다. 또 브로커가 쓰기를 받기 전에 그 파티션이 진행 중인 트랜잭션에 실제로 등록돼 있는지 확인합니다. 새 프로토콜에서는 클라이언트가 AddPartitionsToTxn 을 따로 보내지 않고 브로커가 첫 쓰기 때 알아서 등록합니다.
2-4. 읽는 쪽 — LSO 와 read_committed
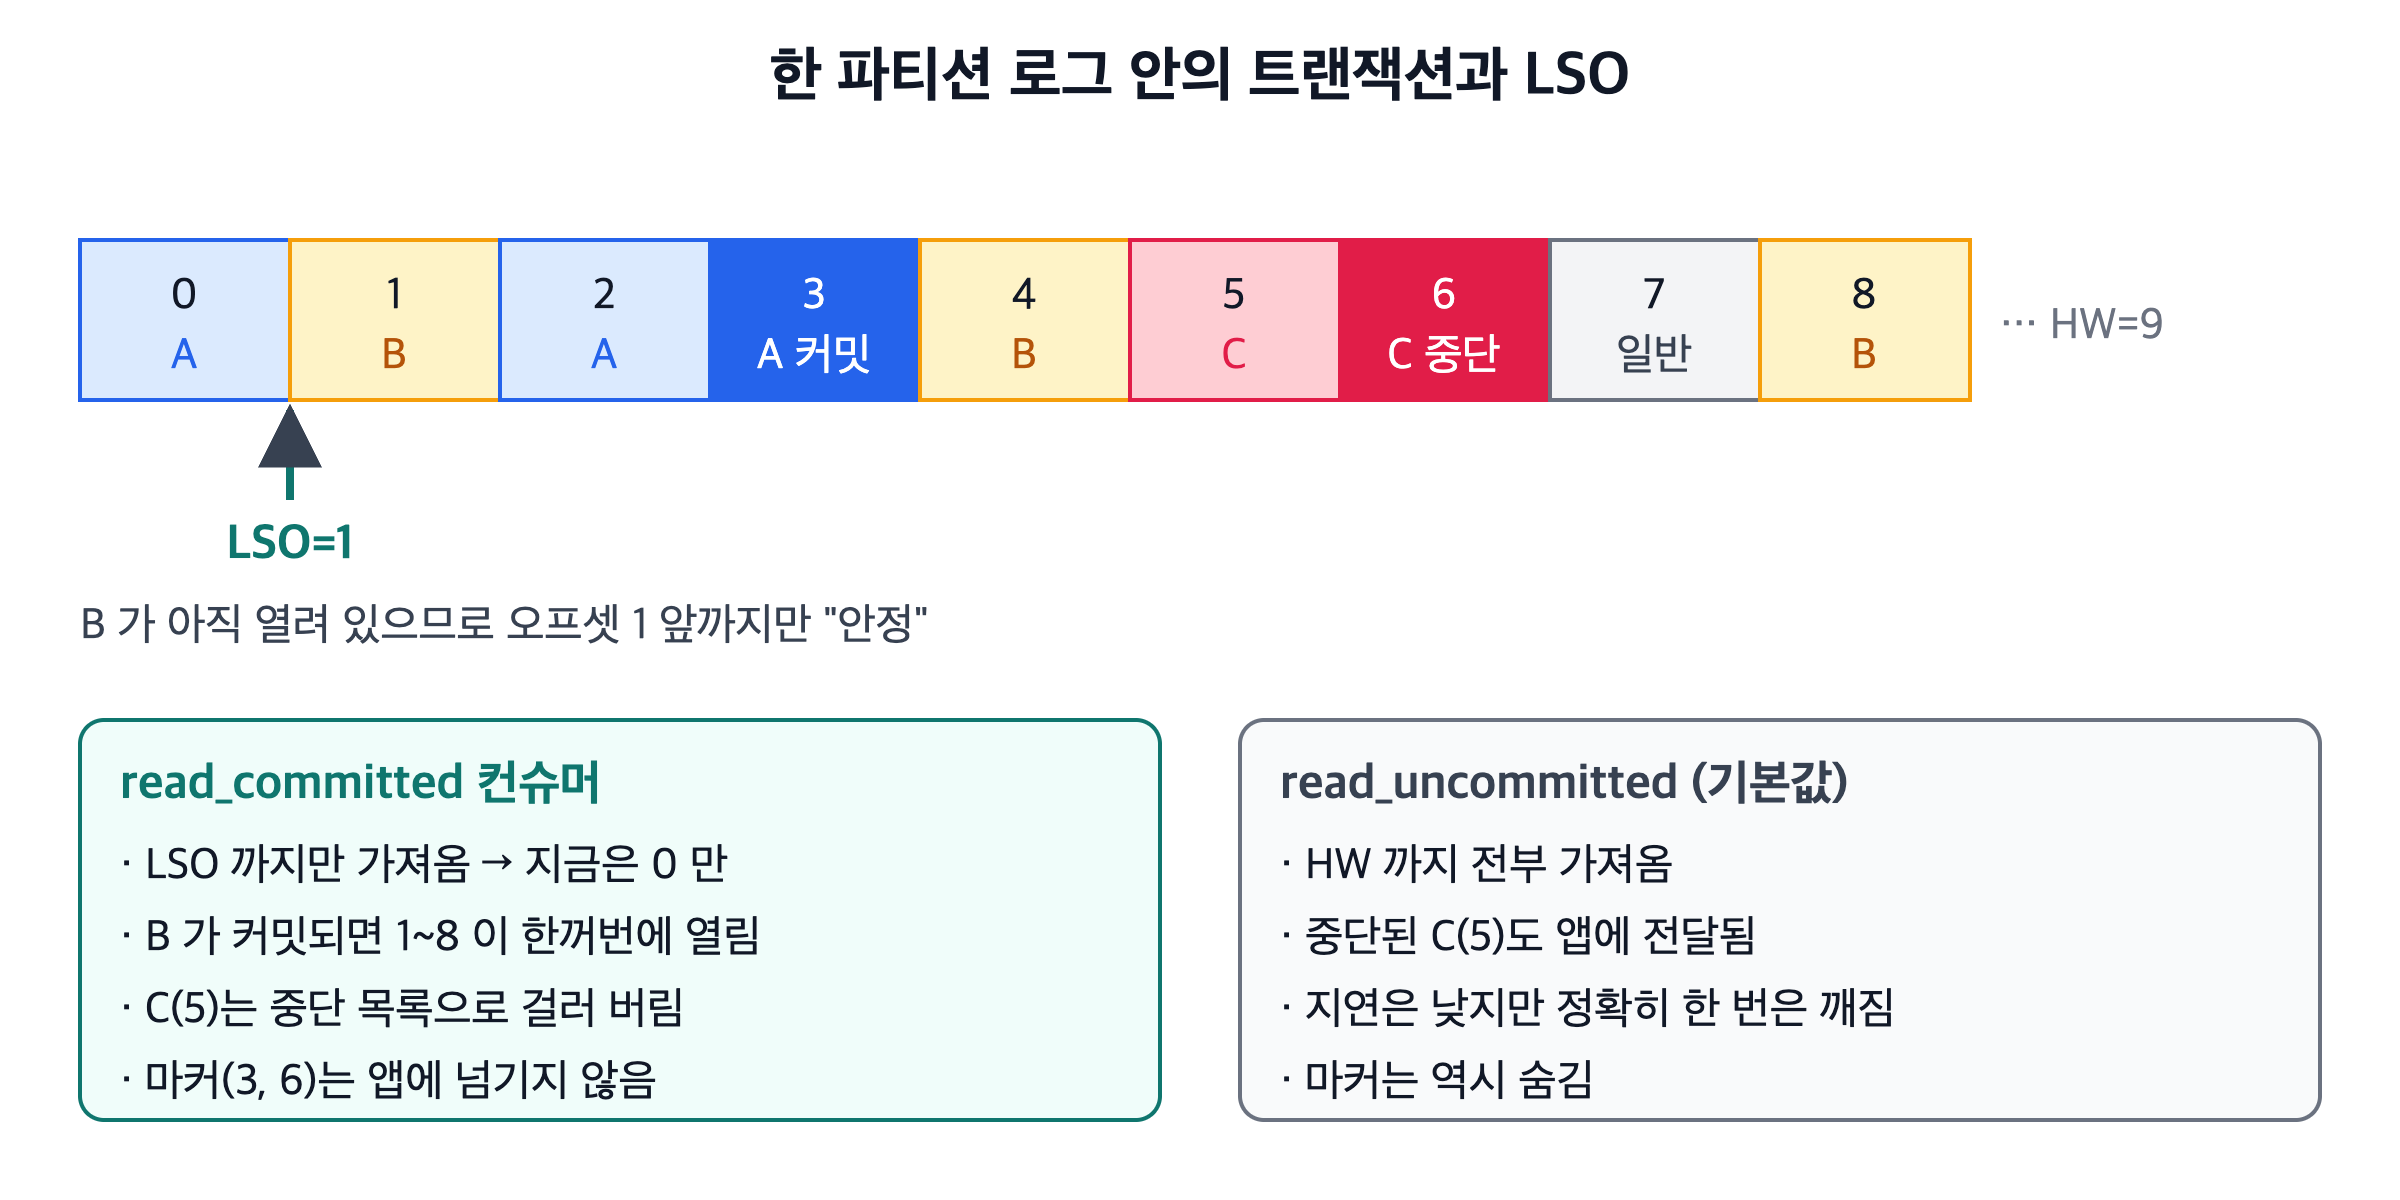
데이터가 커밋 전에 로그에 들어가 있다는 사실이 중요합니다. 그래서 읽는 쪽이 협조해야 합니다. 컨슈머의 isolation.level 이 그 스위치입니다.
read_uncommitted(기본값): 하이 워터마크(HW)까지 전부 읽습니다. 중단된 트랜잭션의 데이터도 애플리케이션에 넘어갑니다.read_committed: **LSO(Last Stable Offset)**까지만 읽습니다. LSO 는 "아직 끝나지 않은 트랜잭션 중 가장 앞선 것의 첫 오프셋"입니다. 열린 트랜잭션이 없으면 HW 와 같습니다.
위 그림에서 트랜잭션 B 는 오프셋 1 에서 시작해 아직 열려 있습니다. 그러므로 LSO 는 1 이고, read_committed 컨슈머는 오프셋 0 만 받습니다. 오프셋 2·3 의 A 는 이미 커밋됐고 오프셋 7 은 트랜잭션도 아닌 일반 메시지지만, B 보다 뒤에 있으니 함께 기다립니다. 파티션 내 순서를 지키려면 그럴 수밖에 없습니다.
중단된 트랜잭션은 어떻게 걸러 낼까요. KIP-98 에 따르면 브로커는 Fetch 응답에 해당 구간의 중단된 트랜잭션 목록([PID, 첫 오프셋])을 함께 실어 보냅니다. 브로커는 이를 위해 세그먼트마다 중단 트랜잭션 인덱스를 따로 유지합니다. 컨슈머는 이 목록을 보고 C 의 오프셋 5 를 버립니다. 커밋·중단 마커(오프셋 3, 6) 자체는 어느 격리 수준에서도 애플리케이션에 전달되지 않습니다. 그래서 read_committed 로 읽으면 오프셋 번호가 중간중간 비어 보입니다. 정상입니다.
3. 직접 해 보기
3-1. 브로커 띄우기
공식 빠른 시작에 있는 단일 노드 KRaft 이미지를 씁니다. 이 이미지의 기본 설정은 단일 노드용이라 트랜잭션 로그 복제 계수가 1 로 잡혀 있어 트랜잭션이 그대로 돕니다.
docker run -d --name kafka -p 9092:9092 apache/kafka:4.0.0

docker exec kafka /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 \
  --create --topic orders --partitions 1
docker exec kafka /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 \
  --create --topic orders-enriched --partitions 1
3-2. consume-transform-produce 최소 예제
kafka-clients 4.x 하나만 의존성으로 두면 돌아갑니다. orders 를 읽어 대문자로 바꿔 orders-enriched 에 쓰고, 입력 오프셋을 같은 트랜잭션으로 커밋합니다.
import java.time.Duration;
import java.util.*;
import org.apache.kafka.clients.consumer.*;
import org.apache.kafka.clients.producer.*;
import org.apache.kafka.common.KafkaException;
import org.apache.kafka.common.TopicPartition;
import org.apache.kafka.common.errors.*;
import org.apache.kafka.common.serialization.*;

public class EosApp {
    public static void main(String[] args) {
        Properties c = new Properties();
        c.put("bootstrap.servers", "localhost:9092");
        c.put("group.id", "enricher");
        c.put("enable.auto.commit", "false");          // 오프셋은 트랜잭션이 커밋한다
        c.put("isolation.level", "read_committed");    // 상류도 트랜잭션이면 필수
        c.put("auto.offset.reset", "earliest");
        KafkaConsumer<String, String> consumer =
            new KafkaConsumer<>(c, new StringDeserializer(), new StringDeserializer());

        Properties p = new Properties();
        p.put("bootstrap.servers", "localhost:9092");
        p.put("transactional.id", "enricher-0");       // 인스턴스마다 고정·고유
        KafkaProducer<String, String> producer =
            new KafkaProducer<>(p, new StringSerializer(), new StringSerializer());

        producer.initTransactions();                   // InitProducerId: 에포크 +1
        consumer.subscribe(List.of("orders"));

        while (true) {
            ConsumerRecords<String, String> records = consumer.poll(Duration.ofSeconds(1));
            if (records.isEmpty()) continue;
            try {
                producer.beginTransaction();
                Map<TopicPartition, OffsetAndMetadata> offsets = new HashMap<>();
                for (ConsumerRecord<String, String> r : records) {
                    producer.send(new ProducerRecord<>("orders-enriched", r.key(), r.value().toUpperCase()));
                    offsets.put(new TopicPartition(r.topic(), r.partition()),
                                new OffsetAndMetadata(r.offset() + 1));
                }
                producer.sendOffsetsToTransaction(offsets, consumer.groupMetadata());
                producer.commitTransaction();          // EndTxn → 마커
            } catch (ProducerFencedException | OutOfOrderSequenceException | AuthorizationException e) {
                producer.close();                      // 회복 불가: 종료
                break;
            } catch (KafkaException e) {
                producer.abortTransaction();           // 그 밖의 오류: 중단 후 재시도
                // 마지막 커밋 위치로 되감아야 같은 입력을 다시 처리한다
                for (TopicPartition tp : records.partitions()) {
                    OffsetAndMetadata committed = consumer.committed(Set.of(tp)).get(tp);
                    consumer.seek(tp, committed == null ? 0 : committed.offset());
                }
            }
        }
        consumer.close();
    }
}
예외 처리 모양은 KafkaProducer Javadoc 의 트랜잭션 예제를 따랐습니다. abortTransaction() 뒤에 되감기를 넣은 이유가 있습니다. 컨슈머의 메모리 위치는 이미 다음 레코드로 넘어가 있어서, 되감지 않으면 중단된 묶음을 건너뛰고 맙니다.
3-3. 격리 수준 차이 눈으로 보기
트랜잭션을 연 채로 커밋하지 않는 상황을 만들면 차이가 바로 보입니다. 위 코드의 commitTransaction() 앞에 Thread.sleep(30_000) 을 넣고 돌린 뒤, 그 30초 동안 두 터미널에서 읽어 봅니다.
# 터미널 1: 커밋 전 데이터도 보인다
docker exec kafka /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 \
  --topic orders-enriched --from-beginning --isolation-level read_uncommitted

# 터미널 2: 커밋되는 순간 한꺼번에 나온다
docker exec kafka /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 \
  --topic orders-enriched --from-beginning --isolation-level read_committed
입력은 kafka-console-producer.sh --topic orders 로 몇 줄 넣으면 됩니다. 터미널 1 에는 즉시 찍히고, 터미널 2 에는 30초 뒤 커밋 시점에 묶음으로 찍힙니다. LSO 가 앞으로 밀리는 순간입니다.
4. 흔한 오해와 실수
오해 1. "카프카 EOS 면 DB 에도 정확히 한 번 써진다." 아닙니다. 트랜잭션이 원자적으로 묶는 대상은 카프카 파티션과 __consumer_offsets 뿐입니다. 루프 안에서 DB 에 INSERT 하거나 HTTP 로 알림을 보내면, 트랜잭션이 중단되고 재처리될 때 그 부수 효과는 되돌려지지 않고 한 번 더 일어납니다. 공식 문서도 외부 시스템까지의 정확히 한 번은 그 시스템의 협조가 필요하다고 적습니다. 실무 해법은 둘입니다. 외부 쓰기를 멱등하게 만들거나(고유 키로 upsert), 오프셋을 같은 DB 트랜잭션에 함께 저장하는 것입니다.
오해 2. "프로듀서만 트랜잭션으로 바꾸면 된다." 컨슈머 기본값은 read_uncommitted 입니다. 하류 컨슈머가 이 값을 그대로 두면 중단된 트랜잭션의 데이터까지 읽습니다. 정확히 한 번은 쓰는 쪽과 읽는 쪽이 함께 설정해야 성립합니다.
오해 3. "멱등성만 켜면 재시작해도 중복이 없다." 멱등성은 PID 단위입니다. 재시작하면 PID 가 바뀌므로 재시작 전후의 중복은 못 막습니다. 또 acks=1 처럼 충돌하는 값을 지정하면 멱등성이 조용히 꺼집니다. 확실히 하려면 enable.idempotence=true 를 명시하세요. 충돌이 있으면 그때는 ConfigException 으로 바로 드러납니다.
실수 4. transactional.id 를 무작위로 만든다. 매번 UUID.randomUUID() 를 쓰면 재시작한 인스턴스가 옛 인스턴스를 펜싱하지 못합니다. 옛 인스턴스가 남긴 열린 트랜잭션도 transaction.timeout.ms(기본 60초)가 지나야 중단됩니다. 반대로 두 인스턴스가 같은 id 를 쓰면 서로를 계속 펜싱합니다. id 는 "인스턴스의 논리적 자리"마다 고정하고, 동시에 둘이 쓰지 않게 하세요.
실수 5. 긴 트랜잭션이 read_committed 컨슈머를 멈춘다. LSO 는 가장 오래 열린 트랜잭션에 묶입니다. 프로듀서 하나가 트랜잭션을 길게 열어 두면, 같은 파티션의 다른 커밋된 데이터와 일반 메시지까지 read_committed 컨슈머에게 막힙니다. 컨슈머 랙이 갑자기 튀는데 처리량은 정상이라면 열린 트랜잭션을 의심하세요. KIP-890 이 "LSO 가 갱신되지 않는 매달린 트랜잭션"을 첫 번째 문제로 꼽은 이유입니다. 트랜잭션은 짧게 자주 커밋하는 편이 낫습니다. 스트림즈가 exactly_once_v2 일 때 commit.interval.ms 기본값을 30초에서 100ms 로 낮추는 것도 같은 맥락입니다.
실수 6. 브로커가 셋 미만인 개발 클러스터. 트랜잭션 로그의 기본 복제 계수는 3, 최소 ISR 은 2 입니다. 브로커 하나로 띄운 클러스터에서 이 값을 낮추지 않으면 트랜잭션 초기화가 진행되지 않습니다. 스트림즈 문서도 정확히 한 번 처리에는 기본적으로 브로커 세 대 이상이 필요하다고 적고 있습니다.
5. 설정 조합별 보장 비교
| 조합 | 프로듀서 재시도 중복 | 쓰기-오프셋 원자성 | 중단 데이터 노출 | 외부 DB 부수 효과 |
|---|---|---|---|---|
enable.idempotence=false + 자동 커밋 |
생김 | 없음 | 해당 없음 | 중복 가능 |
| 멱등성만(기본값) | 세션·파티션 안에서 막음 | 없음 | 해당 없음 | 중복 가능 |
트랜잭션 + read_uncommitted 하류 |
막음 | 있음 | 노출됨 | 중복 가능 |
트랜잭션 + read_committed 하류 |
막음 | 있음 | 숨김 | 중복 가능 |
| 위 + 외부 쓰기를 멱등 upsert | 막음 | 있음 | 숨김 | 결과적으로 한 번 |
마지막 열이 이 글의 요점입니다. 카프카가 책임지는 경계는 카프카 안쪽까지입니다.
6. 정리
- 멱등 프로듀서는 (PID, 에포크, 파티션별 시퀀스)로 한 세션 안의 재시도 중복을 브로커가 걸러 내게 합니다.
- 트랜잭션은 데이터를 먼저 다 써 두고, 코디네이터가
PREPARE_COMMIT기록으로 결정한 뒤 각 파티션에 커밋 마커를 찍습니다.transactional.id와 에포크가 좀비를 펜싱합니다. - 읽는 쪽은
read_committed로 LSO 까지만 읽어야 하고, 카프카 밖의 부수 효과는 여전히 멱등하게 따로 설계해야 합니다.
smith lab 에서 이어서 보기
smith lab(smithlab.co.kr)은 설치·로그인 없이 브라우저에서 바로 쓰는 개발자 도구와 실무 글을 모아 둔 곳입니다. 개발 글 모음도 함께 보세요.
참고 자료
- KIP-98: Exactly Once Delivery and Transactional Messaging
- KIP-447: Producer scalability for exactly once semantics
- KIP-890: Transactions Server-Side Defense
- Apache Kafka 4.3 Design — Message Delivery Semantics
- Apache Kafka 4.3 Producer Configs
- Apache Kafka 4.3 Consumer Configs
- Apache Kafka 4.3 Broker Configs
- Apache Kafka 4.3 Kafka Streams Configs
- KafkaProducer Javadoc (4.3)
- Apache Kafka 4.0.0 릴리스 공지
'Develop > [Kafka]' 카테고리의 다른 글
| 카프카 파티션과 오프셋 원리 — 세그먼트·인덱스·하이 워터마크 (0) | 2026.10.26 |
|---|---|
| CDC 원리 — Debezium 이 WAL 을 카프카로 흘리는 법 (0) | 2026.10.26 |
| 카프카 컨슈머 그룹 리밸런싱은 왜 멈춤을 만드나 — KIP-848 (0) | 2026.10.13 |
| [Kafka] 파티셔너 (0) | 2023.08.31 |
| [Kafka] 프로듀서 (0) | 2023.08.31 |


