카프카를 쓰다 보면 오프셋이라는 숫자가 계속 나옵니다. 컨슈머 랙, 커밋 오프셋, auto.offset.reset, 하이 워터마크 모두 이 숫자를 가리킵니다. 오프셋을 "메시지 번호" 정도로만 알고 넘어가면 장애가 났을 때 길을 잃습니다. 같은 메시지가 두 번 처리되는 이유, 보존 기간이 지났는데 디스크가 안 줄어드는 이유, 파티션을 늘린 뒤 순서가 어긋나는 이유는 모두 파티션이 디스크에 어떻게 저장되는지에서 나옵니다.
기준은 Apache Kafka 4.3 공식 문서와 apache/kafka 저장소의 storage 모듈 소스입니다.
카프카가 풀려던 문제 — 큐가 아니라 로그
전통적인 메시지 큐는 브로커가 메시지마다 상태를 들고 있습니다. 보냈는지, 확인(ack)을 받았는지, 지워도 되는지를 기록합니다. 카프카 설계 문서는 이 방식의 문제를 두 가지로 짚습니다. 첫째, 컨슈머가 처리를 마치고 ack 를 보내기 전에 죽으면 메시지가 두 번 소비됩니다. 둘째, 브로커가 메시지마다 "잠금"과 "소비 완료" 같은 상태를 따로 관리해야 해서 느립니다.
카프카는 다른 길을 택했습니다. 토픽을 완전히 순서가 정해진 파티션 여러 개로 나누고, 한 컨슈머 그룹 안에서는 파티션 하나를 컨슈머 하나만 읽게 합니다. 그러면 "어디까지 읽었나"는 파티션마다 정수 하나, 즉 다음에 읽을 메시지의 오프셋으로 줄어듭니다. 메시지마다 상태를 둘 필요가 없습니다. 브로커는 메시지를 지우지 않고 끝에 덧붙이기만 합니다. 지우는 일은 시간이나 크기 기준으로 나중에 한꺼번에 합니다.
이 구조는 디스크에도 유리합니다. 설계 문서는 6개의 7200rpm SATA 디스크를 RAID-5 로 묶은 JBOD 구성에서 순차 쓰기는 약 600MB/s 지만 랜덤 쓰기는 약 100kB/s 로, 6000배 넘게 차이 난다고 적습니다. 카프카는 끝에 붙이기만 하는 로그를 써서 디스크를 항상 순차로 씁니다. 캐시도 따로 만들지 않고 OS 페이지 캐시에 맡깁니다.
파티션은 디렉터리, 세그먼트는 파일
공식 문서의 설명은 단순합니다. 파티션이 두 개인 토픽 my-topic 은 디스크에서 my-topic-0, my-topic-1 두 디렉터리가 됩니다. 각 디렉터리는 세그먼트라는 파일 묶음으로 나뉩니다. 세그먼트 파일 이름은 그 파일에 든 첫 메시지의 오프셋입니다. 그래서 첫 파일은 00000000000000000000.log 입니다.
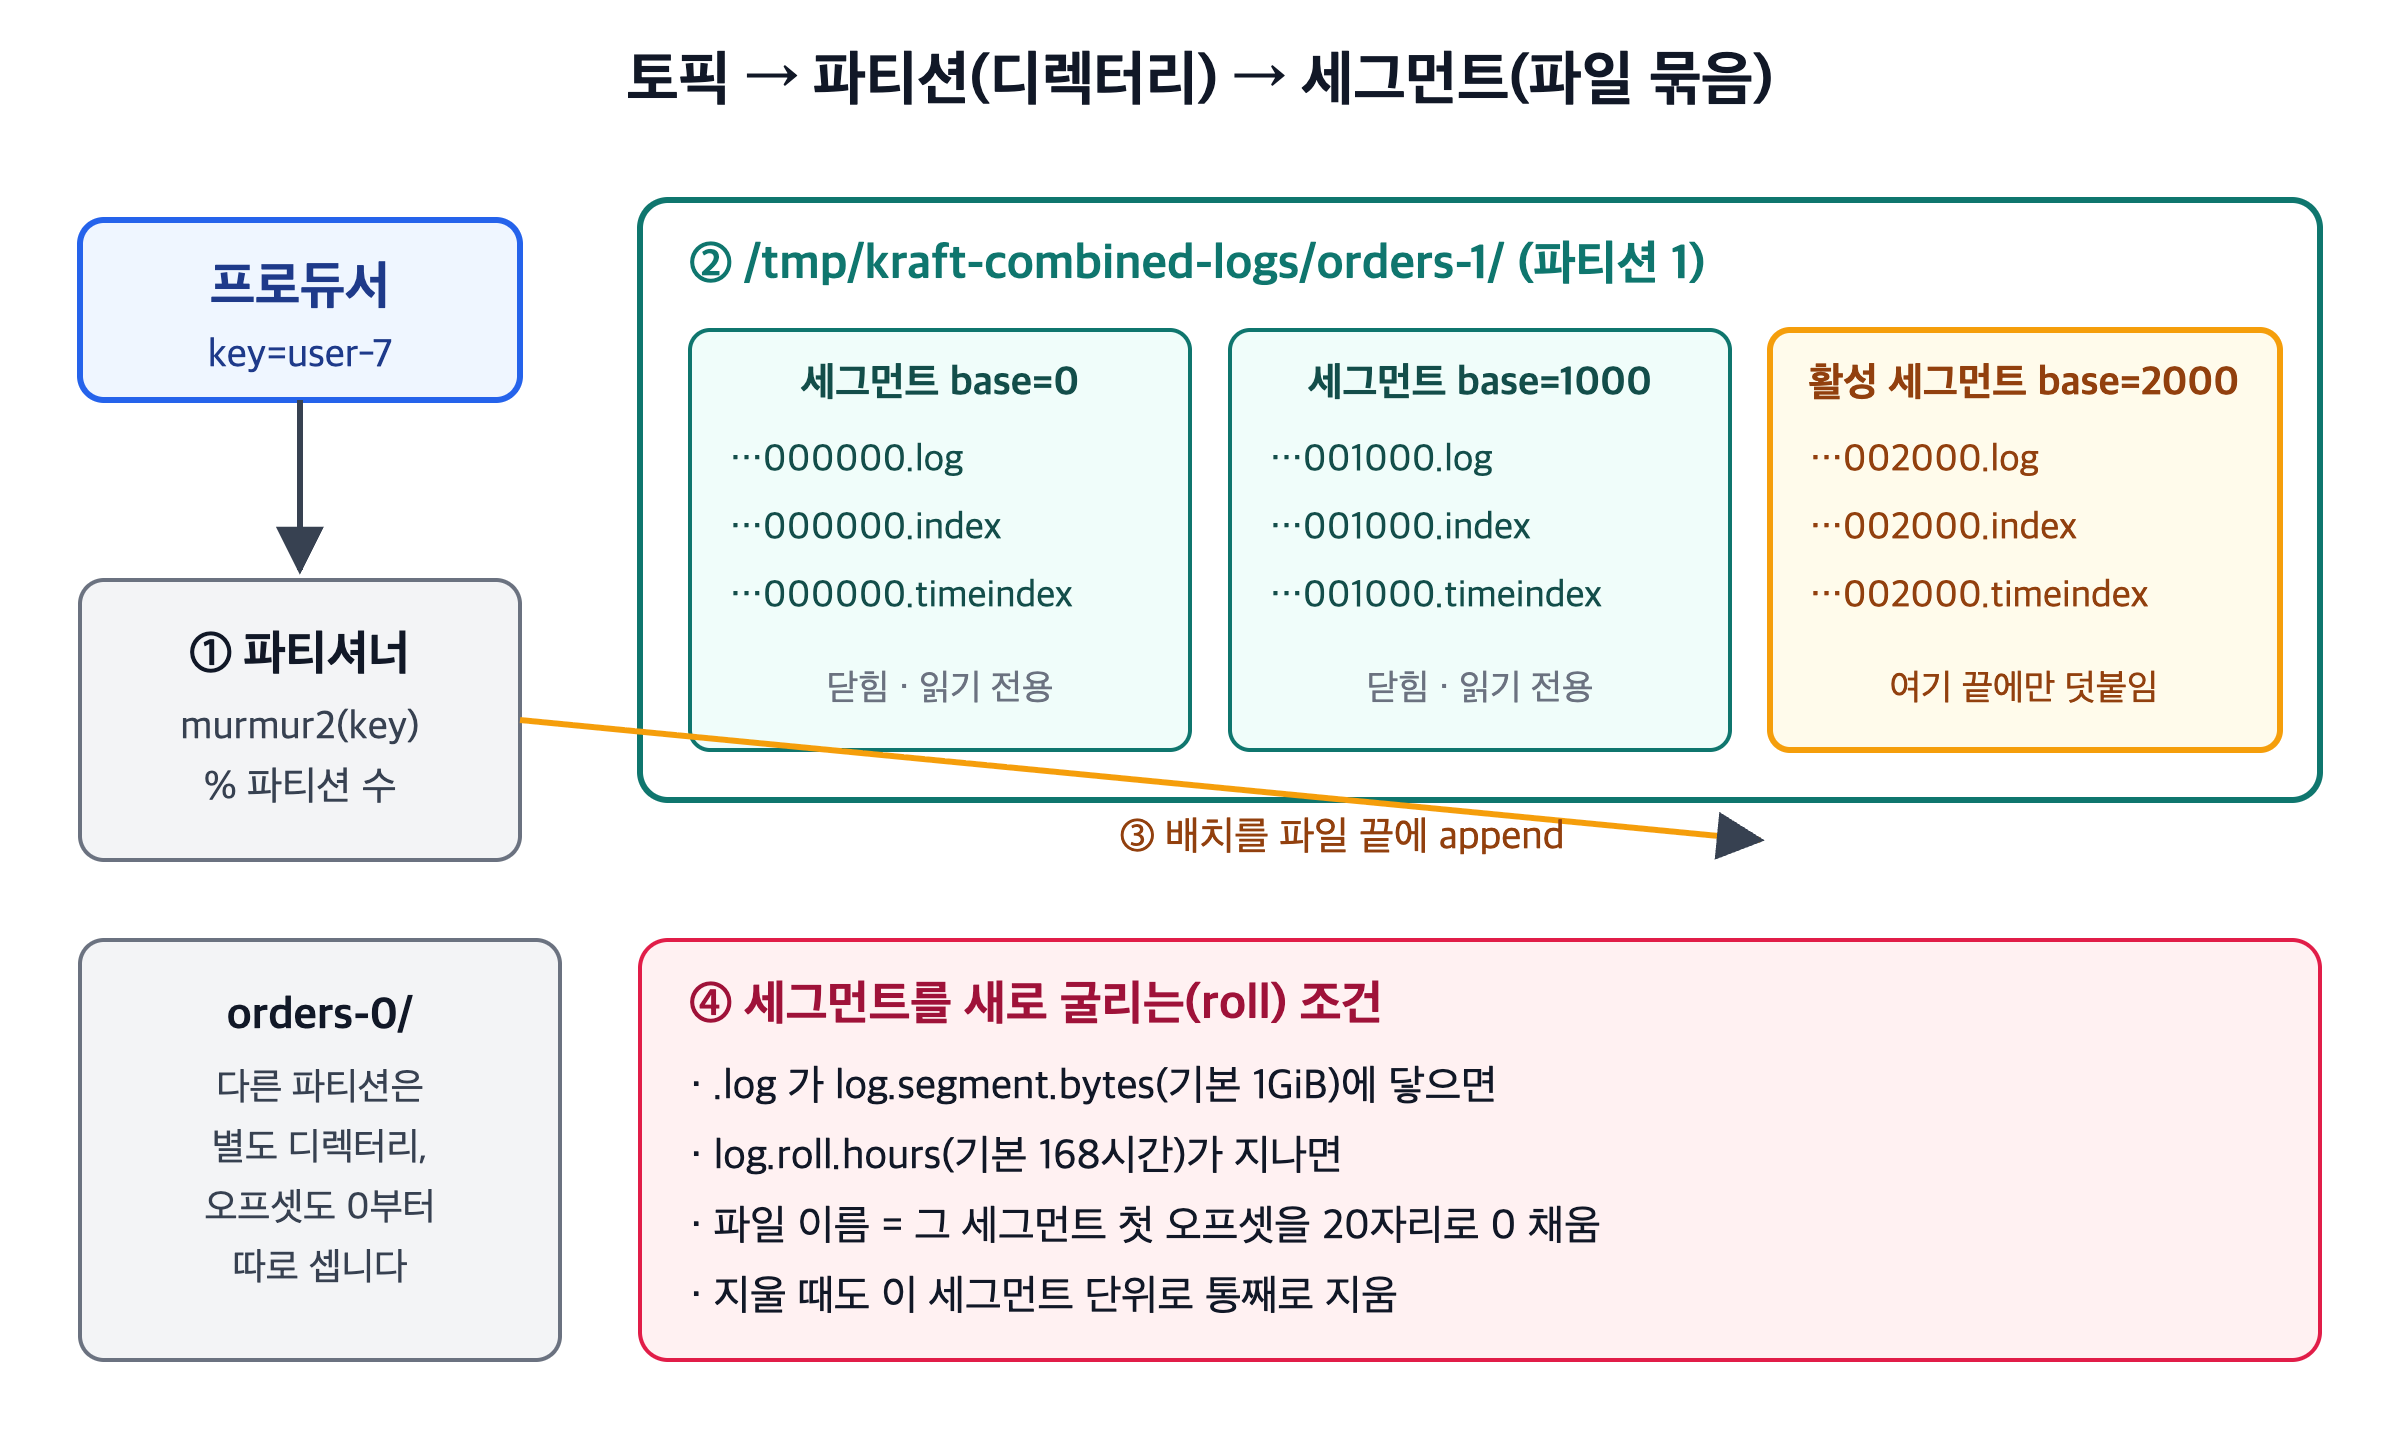
세그먼트 하나는 확장자만 다른 파일 몇 개로 이뤄집니다. LogFileUtils 소스에 정의된 접미사 가운데 자주 보는 것을 정리하면 이렇습니다.
| 파일 | 내용 | 항목 크기 |
|---|---|---|
.log |
레코드 배치를 그대로 이어 붙인 본체 | 가변 |
.index |
오프셋 → 파일 내 바이트 위치(성긴 인덱스) | 8바이트 (상대 오프셋 4 + 위치 4) |
.timeindex |
타임스탬프 → 오프셋 | 12바이트 (타임스탬프 8 + 상대 오프셋 4) |
.txnindex |
중단된 트랜잭션 범위 | — |
.snapshot |
프로듀서 상태 스냅숏(멱등성·트랜잭션용) | — |
.deleted |
삭제 예약된 세그먼트에 붙는 접미사 | — |
새 메시지는 언제나 마지막 세그먼트, 즉 활성 세그먼트에만 붙습니다. 활성 세그먼트가 log.segment.bytes(기본 1GiB)에 닿거나 log.roll.hours(기본 168시간)가 지나면 닫히고 새 세그먼트가 열립니다. 닫힌 세그먼트는 다시 쓰지 않습니다.
동작 원리 1: 쓰기 — 배치가 세그먼트 끝에 붙기까지
프로듀서에서 디스크까지는 다섯 단계를 거칩니다.
- 파티션 결정. 키가 있으면 프로듀서의
BuiltInPartitioner.partitionForKey가murmur2(키) % 파티션 수로 파티션을 고릅니다. 키가 없으면 스티키 파티셔너가 한 파티션에batch.size만큼 쌓일 때까지 그 파티션으로 보냅니다. - 배치로 묶어 전송. 카프카는 메시지를 한 건씩 저장하지 않습니다. 문서는 "메시지는 언제나 배치로 쓰인다"고 적습니다. 배치 헤더에는
baseOffset(int64),lastOffsetDelta(int32),baseTimestamp,maxTimestamp,producerId,baseSequence, CRC 같은 값이 들어 있습니다. - 오프셋 부여. 리더 브로커가 배치를 받으면 현재 로그 끝 오프셋(LEO)부터 번호를 매깁니다. 배치 안의 각 레코드는
baseOffset으로부터의 차이만 들고 있습니다. - 파일 끝에 append.
LogSegment.append는 배치를.log끝에 씁니다. 이때 실제로는 OS 페이지 캐시에 쓰는 것이고, 디스크로 내리는 일은 OS 가 나중에 합니다. - 인덱스 항목 추가(가끔). 같은 메서드에서 마지막 인덱스 항목 이후 쌓인 바이트가
log.index.interval.bytes(기본 4096바이트)를 넘으면.index에 (그 배치의 마지막 오프셋, 배치 시작 바이트 위치)를 한 줄 추가합니다..timeindex에도 지금까지의 최대 타임스탬프를 한 줄 추가합니다.
5번이 핵심입니다. 인덱스는 모든 메시지를 담지 않습니다. 대략 4KB 마다 한 줄씩만 찍는 성긴(sparse) 인덱스입니다. 그래서 인덱스가 작고, 통째로 메모리에 올라갑니다. OffsetIndex 소스 주석은 오프셋을 세그먼트 기준 상대값으로 저장한다고 설명합니다. 기준 오프셋이 50 이면 55 는 5 로 저장됩니다.
fsync 는 기본으로 하지 않습니다. log.flush.interval.messages 의 기본값은 9223372036854775807(Long 최댓값)입니다. 문서는 기본 플러시 설정을 권장하며 "카프카의 내구성은 디스크 동기화가 아니라 복제에서 온다"고 적습니다. 브로커가 죽어도 다른 레플리카에서 복구하기 때문입니다. 재시작할 때는 마지막 세그먼트를 처음부터 훑으며 CRC 를 검사하고, 깨진 지점 뒤를 잘라냅니다. 인덱스에는 체크섬이 없습니다. 깨지면 .log 를 읽어 다시 만듭니다.
동작 원리 2: 읽기 — 오프셋 하나로 바이트 위치 찾기
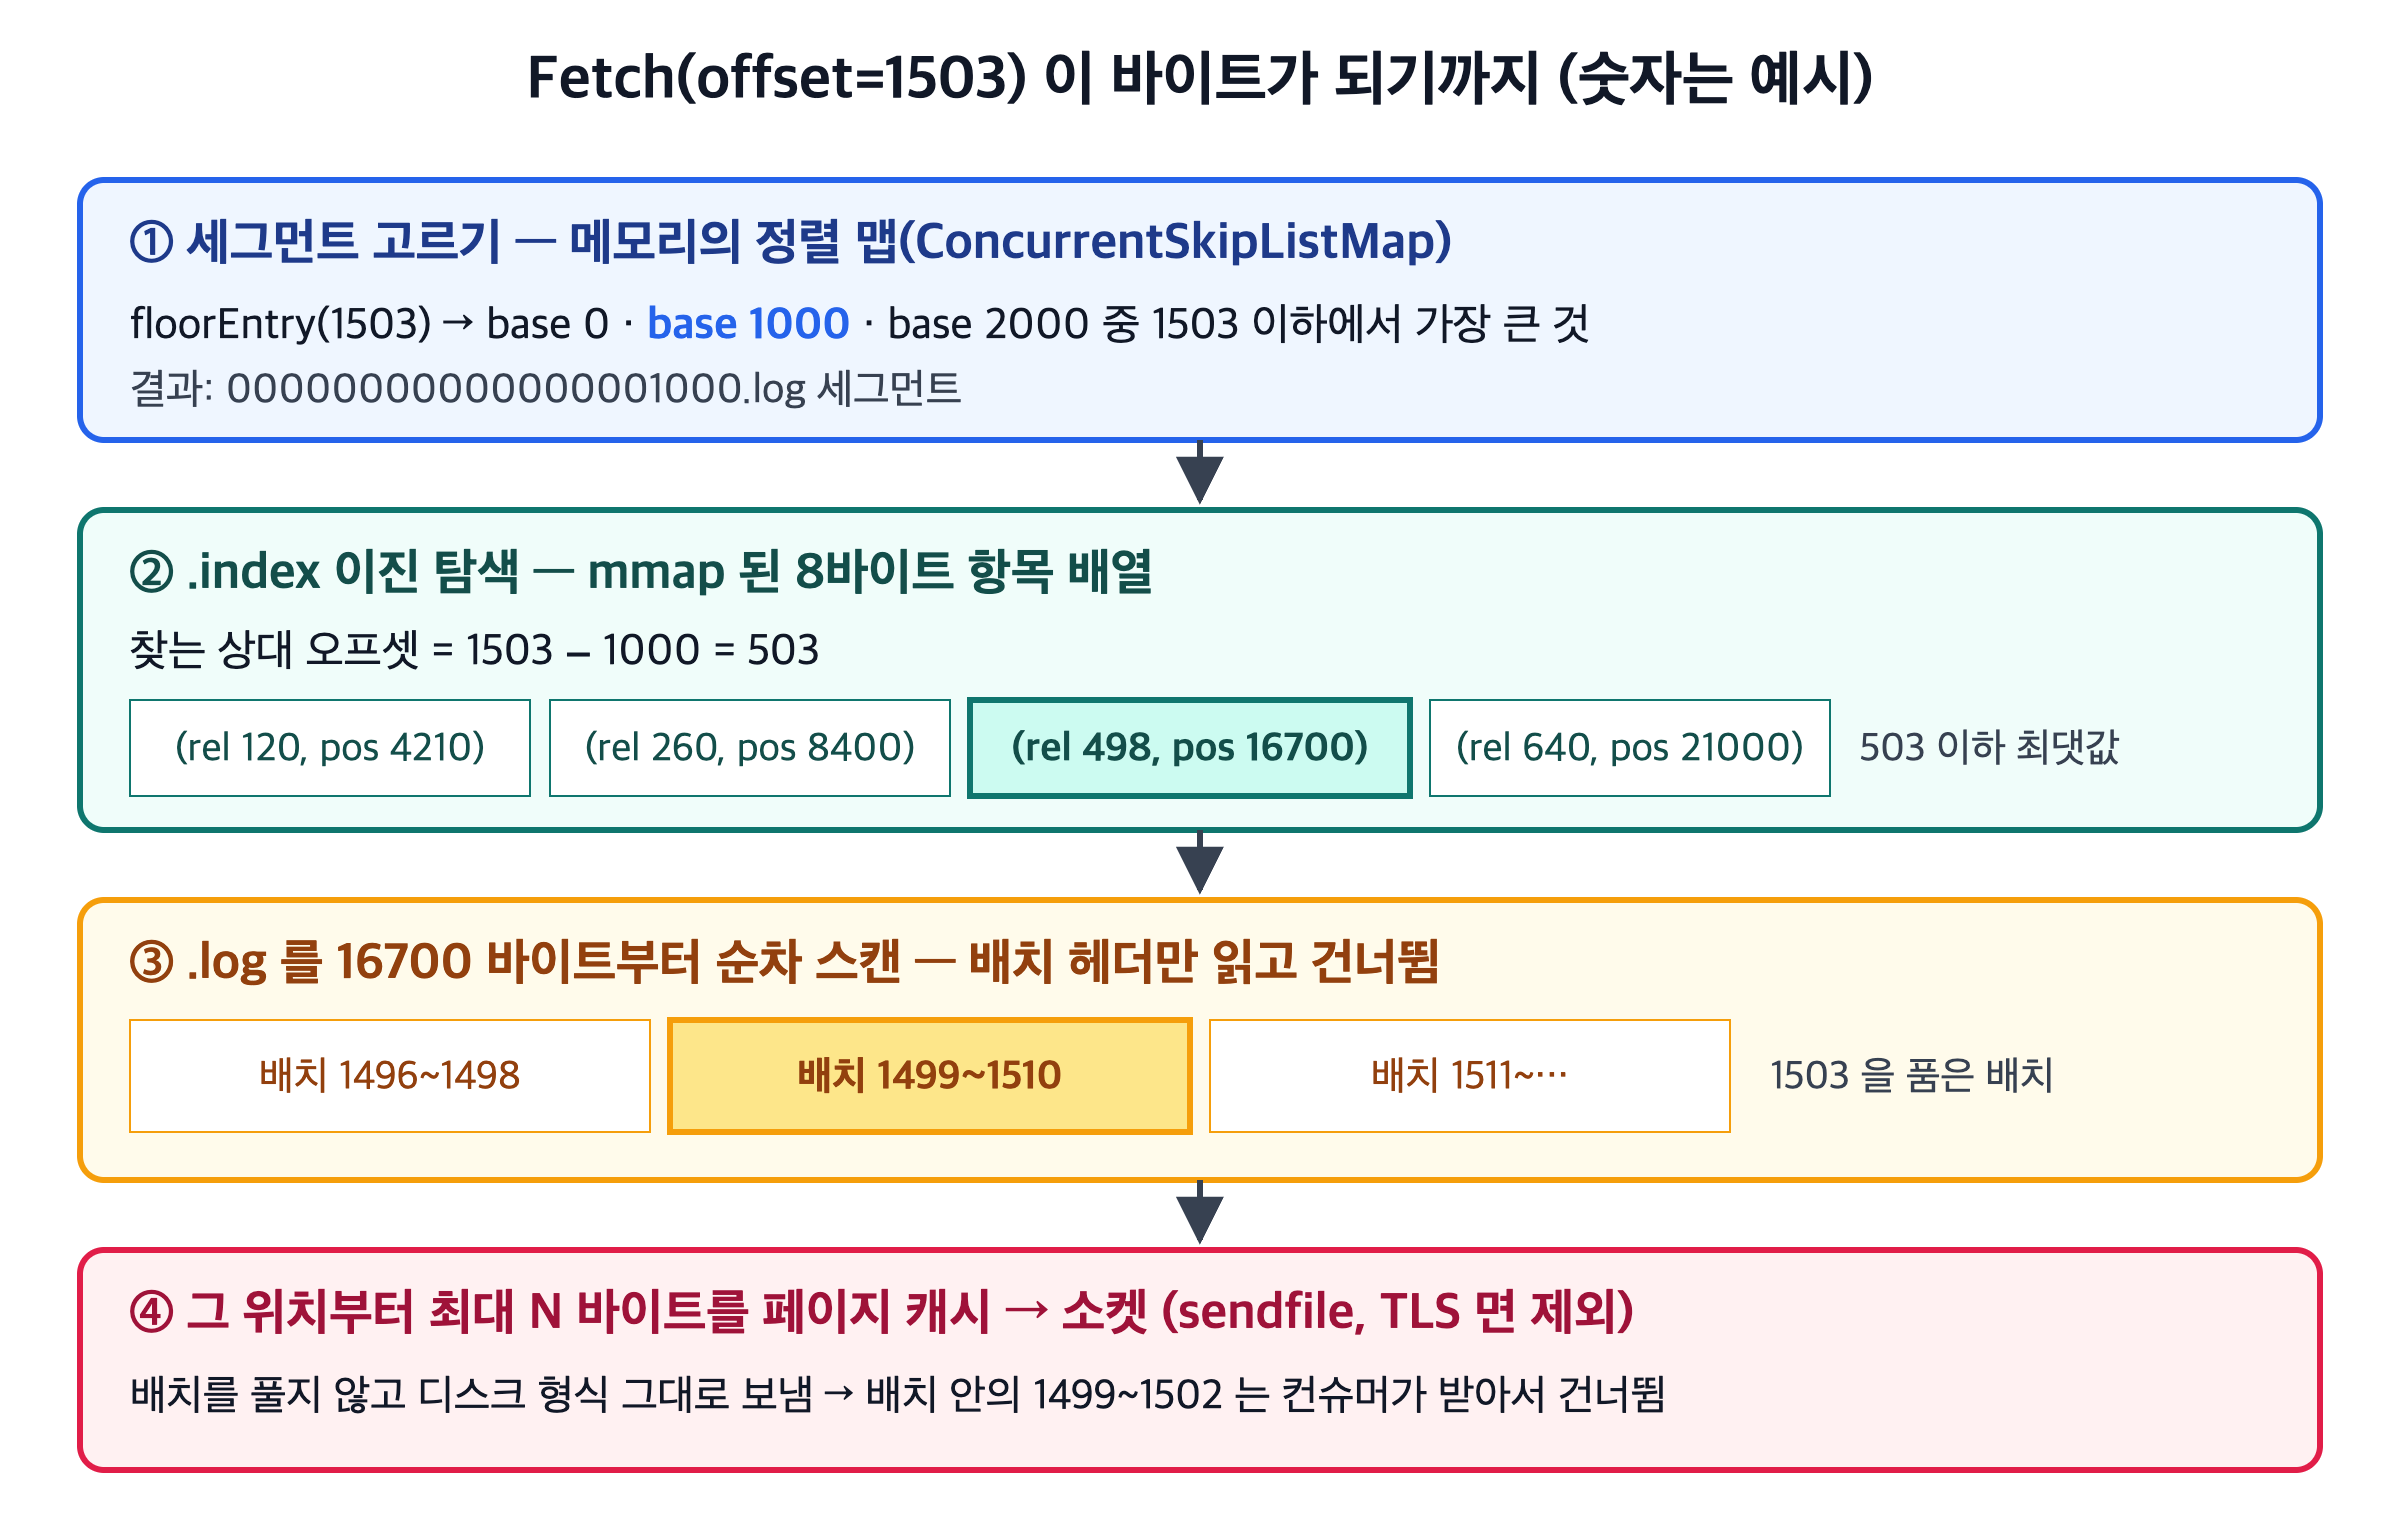
컨슈머나 팔로워 레플리카는 Fetch 요청에 "파티션 P 의 오프셋 X 부터, 최대 N 바이트"를 담아 보냅니다. 브로커는 이 오프셋을 파일과 바이트 위치로 바꿔야 합니다.
- 세그먼트 고르기.
LogSegments는 세그먼트들을 기준 오프셋을 키로 하는ConcurrentSkipListMap에 들고 있습니다.floorEntry(X)를 부르면 X 이하에서 가장 큰 기준 오프셋, 즉 X 가 들어 있는 세그먼트가 나옵니다. 파일 이름이 첫 오프셋인 이유가 여기 있습니다. - 인덱스 이진 탐색. 그 세그먼트의
.index는 mmap 으로 메모리에 매핑돼 있습니다.X - 기준 오프셋을 상대 오프셋으로 놓고, 그 값 이하인 가장 큰 항목을 이진 탐색으로 찾습니다. 결과는 "이 바이트 위치부터 읽으면 X 보다 앞에서 시작한다"는 위치입니다. - 로그 순차 스캔.
LogSegment.translateOffset은 그 위치부터.log를 읽으며 배치 헤더만 확인합니다. 배치 길이를 보고 건너뛰다가 X 를 품은 배치를 만나면 멈춥니다. - 페이지 캐시에서 소켓으로. 찾은 위치부터 최대 N 바이트를 응답으로 보냅니다. 리눅스에서는
sendfile시스템 호출로 페이지 캐시의 데이터를 사용자 공간을 거치지 않고 소켓으로 넘깁니다. 문서 설명으로는, 일반적인 경로라면 복사 4번에 시스템 호출 2번이 들지만sendfile을 쓰면 NIC 버퍼로 가는 마지막 복사만 남습니다. 단, TLS 를 켜면 암호화를 사용자 공간에서 해야 하므로sendfile을 쓰지 않습니다.
브로커는 배치를 풀지 않습니다. 디스크에 있는 바이트를 그대로 보냅니다. 그래서 X 가 배치 중간에 있으면 배치 앞쪽 레코드도 함께 넘어가고, 컨슈머 라이브러리가 X 보다 작은 오프셋을 걸러냅니다.
인덱스 탐색에도 캐시를 고려한 장치가 있습니다. AbstractIndex 주석에 따르면 일반 이진 탐색은 매번 인덱스 첫 페이지부터 건드려서 페이지 캐시에 불리합니다. 그래서 인덱스 끝쪽 8192개 항목을 "warm" 구간으로 두고, 찾는 값이 그 안에 있으면 그 구간만 이진 탐색합니다. 따라잡은 컨슈머와 팔로워는 거의 항상 로그 끝 근처를 읽으므로 대부분 이 구간에서 끝납니다. 문서는 컨슈머가 대체로 따라잡은 클러스터에서는 디스크 읽기가 아예 보이지 않을 수 있다고 적습니다. 모든 읽기가 캐시에서 나가기 때문입니다.
동작 원리 3: 어디까지 읽을 수 있나 — 다섯 가지 오프셋
파티션 하나에는 서로 다른 의미의 오프셋이 여러 개 붙습니다. 이걸 섞어 쓰면 랙 계산도, 장애 분석도 틀립니다.
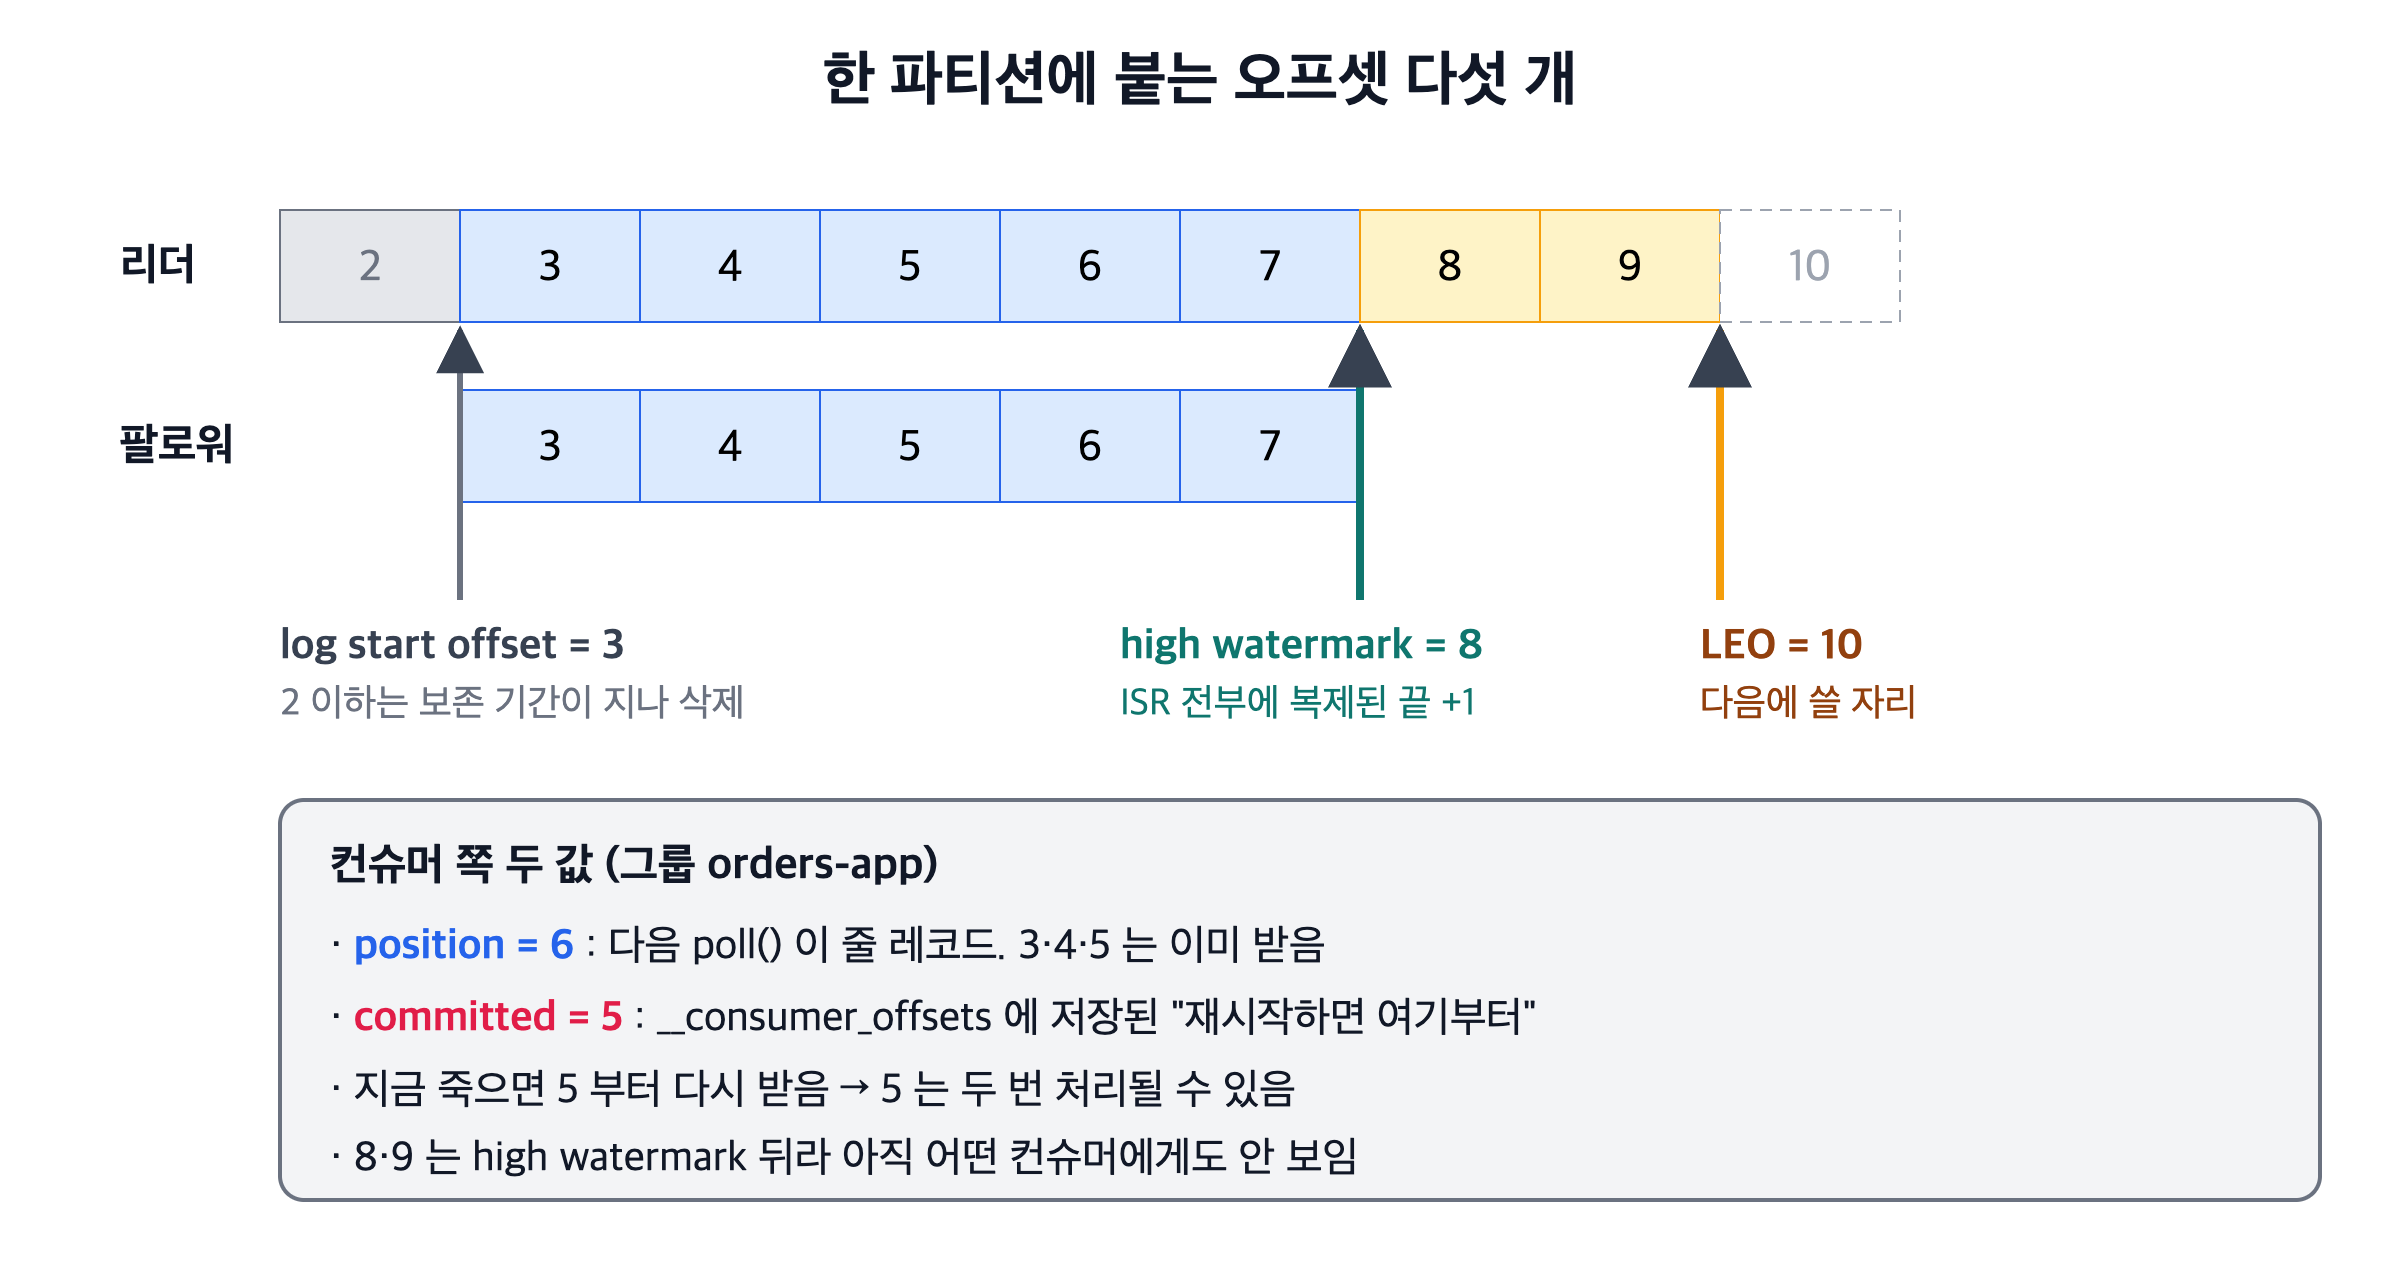
| 이름 | 누가 관리 | 뜻 |
|---|---|---|
| log start offset | 브로커 | 아직 남아 있는 가장 오래된 오프셋. 보존 기간·크기 정책으로 세그먼트가 지워지면 앞으로 이동 |
| LEO (log end offset) | 브로커(레플리카마다) | 다음 메시지를 쓸 자리. 마지막 오프셋 + 1 |
| high watermark (HW) | 리더 | ISR 전부에 복제된 마지막 오프셋 + 1. 컨슈머는 여기 앞까지만 읽음 |
| position | 컨슈머 메모리 | 다음 poll() 이 돌려줄 레코드의 오프셋 |
| committed offset | __consumer_offsets 토픽 |
재시작하면 여기서부터 읽음 |
공식 문서는 acks 설정과 상관없이 메시지가 모든 ISR 에 복제되고 ISR 수가 min.insync.replicas 이상이어야 컨슈머에게 보인다고 적습니다. 이 경계가 HW 입니다. 리더의 LEO 가 10 이어도 팔로워가 8 까지만 복제했다면 HW 는 8 이고, 8·9 번은 아직 아무 컨슈머에게도 보이지 않습니다. KafkaConsumer.endOffsets() 문서도 기본 격리 수준(read_uncommitted)에서 끝 오프셋은 HW 라고 명시합니다. read_committed 라면 HW 와 열린 트랜잭션 중 가장 작은 오프셋 가운데 작은 값인 LSO 가 경계입니다.
컨슈머 쪽 두 값은 더 자주 헷갈립니다. KafkaConsumer 문서의 예로, position 이 5 라는 말은 0~4 를 이미 받았고 다음에 5 를 받는다는 뜻입니다. committed offset 은 안전하게 저장된 마지막 위치입니다. 둘 사이에 있는 레코드는 "받았지만 커밋은 안 된" 상태입니다. 이때 컨슈머가 죽으면 그 구간을 다시 받습니다. 카프카의 기본 전달 보장이 at-least-once 인 이유가 바로 이 간격입니다. enable.auto.commit 기본값은 true, auto.commit.interval.ms 기본값은 5초이므로, 기본 설정에서는 최대 몇 초 분량이 중복 처리될 수 있습니다.
커밋 오프셋도 결국 카프카 토픽 __consumer_offsets(기본 50개 파티션)에 쌓이는 로그입니다. 그룹이 빈 뒤 offsets.retention.minutes(기본 10080분, 7일)가 지나면 커밋 기록이 지워집니다. 그 뒤에는 auto.offset.reset(기본 latest)을 따릅니다.
삭제는 세그먼트 단위
보존 정책은 메시지 한 건씩 지우지 않습니다. 문서는 "데이터는 한 번에 한 세그먼트씩 지운다"고 적습니다. 시간 기준일 때는 세그먼트 안의 가장 큰 타임스탬프가 그 세그먼트 전체의 나이가 됩니다. 크기 기준(log.retention.bytes)은 기본으로 꺼져 있고(-1), 켜면 파티션 크기가 한도 안에 들어올 때까지 가장 오래된 세그먼트부터 지웁니다.
지우는 순서도 단계가 있습니다. 브로커는 log.retention.check.interval.ms(기본 5분)마다 지울 세그먼트를 찾습니다. 찾으면 먼저 log start offset 을 옮기고 파일 이름에 .deleted 를 붙입니다. 실제 파일은 log.segment.delete.delay.ms(기본 1분) 뒤에 지웁니다.
직접 해 보기
도커만 있으면 됩니다. 공식 빠른 시작이 쓰는 apache/kafka:4.3.1 이미지를 띄우고, 세그먼트가 빨리 굴러가도록 segment.bytes 를 1MiB 로 줄인 토픽을 만듭니다. 이 이미지의 기본 log.dirs 는 /tmp/kraft-combined-logs 입니다.
docker run -d --name kafka -p 9092:9092 apache/kafka:4.3.1

docker exec kafka /opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server localhost:9092 --create --topic orders \
  --partitions 2 --config segment.bytes=1048576

# 200바이트짜리 레코드 2만 건 = 약 4MB → 파티션당 세그먼트 여러 개
docker exec kafka /opt/kafka/bin/kafka-producer-perf-test.sh \
  --topic orders --num-records 20000 --record-size 200 --throughput -1 \
  --command-property bootstrap.servers=localhost:9092

docker exec kafka ls -l /tmp/kraft-combined-logs/orders-0/
ls 결과에서 이름이 숫자 20자리인 .log·.index·.timeindex 묶음이 여러 벌 보입니다. 두 번째 묶음 이름의 숫자가 첫 세그먼트 다음 오프셋입니다. 이제 세그먼트 안을 열어 봅니다.
docker exec -w /tmp/kraft-combined-logs/orders-0 kafka \
  /opt/kafka/bin/kafka-dump-log.sh --files 00000000000000000000.log | head -5

docker exec -w /tmp/kraft-combined-logs/orders-0 kafka \
  /opt/kafka/bin/kafka-dump-log.sh --files 00000000000000000000.index | head -5
.log 를 덤프하면 줄마다 배치 하나가 나오고, baseOffset·lastOffset·count·position 이 찍힙니다. .index 를 덤프하면 offset: … position: … 쌍이 띄엄띄엄 나옵니다. 오프셋이 연속이 아니라 대략 4KB 간격으로 건너뛰는 것이 성긴 인덱스입니다.
컨슈머 그룹을 붙여 position 과 committed 를 봅니다.
docker exec kafka /opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 --topic orders \
  --group demo --from-beginning --max-messages 100 > /dev/null

docker exec kafka /opt/kafka/bin/kafka-consumer-groups.sh \
  --bootstrap-server localhost:9092 --describe --group demo
출력의 CURRENT-OFFSET 이 커밋된 오프셋, LOG-END-OFFSET 이 파티션 끝, LAG 이 둘의 차이입니다.
직접 커밋한다면 오프셋에 1을 더해야 합니다. 커밋 값은 "마지막으로 처리한 것"이 아니라 "다음에 읽을 것"이기 때문입니다.
for (ConsumerRecord<String, String> rec : consumer.poll(Duration.ofMillis(500))) {
    process(rec);
    consumer.commitSync(Map.of(
        new TopicPartition(rec.topic(), rec.partition()),
        new OffsetAndMetadata(rec.offset() + 1)));   // +1 이 빠지면 재시작 때 마지막 건을 또 받음
}
설정값별로 달라지는 것
| 설정 | 기본값 | 줄이면 | 늘리면 |
|---|---|---|---|
log.segment.bytes (토픽: segment.bytes) |
1GiB | 파일 수·열린 핸들 증가, 보존 정책이 더 촘촘하게 적용 | 오래된 데이터가 한 세그먼트에 묶여 늦게 지워짐 |
log.roll.hours |
168 | 한산한 토픽도 자주 굴러 시간 보존이 정확해짐 | 한산한 토픽의 활성 세그먼트가 오래 열려 있음 |
log.index.interval.bytes |
4096 | 인덱스가 커지고 스캔 거리는 짧아짐 | 인덱스가 작아지고 스캔 거리는 길어짐 |
log.index.size.max.bytes |
10MiB | 인덱스가 먼저 차서 세그먼트가 일찍 굴러감 | 큰 세그먼트에도 인덱스 여유 |
log.retention.hours |
168 | 디스크 절약, 재처리 가능 범위 축소 | 되감아 읽을 수 있는 기간 확대 |
log.flush.interval.messages |
Long 최댓값 | fsync 가 잦아져 처리량 하락 | 기본값 = OS 와 복제에 맡김 |
흔한 오해·실수
"오프셋은 파일 안의 바이트 위치다." 아닙니다. 오프셋은 파티션마다 1씩 늘어나는 논리 번호입니다. 바이트 위치는 .index 가 따로 들고 있습니다. 공식 문서의 Log 절에는 옛 설계의 흔적으로 "바이트 위치"라는 표현이 남아 있지만, 같은 절의 뒷부분과 소스는 파티션별 원자적 카운터를 오프셋으로 쓴다고 설명합니다. 오프셋이 늘 연속인 것도 아닙니다. 컴팩션된 토픽이나 트랜잭션 제어 레코드가 끼면 번호가 건너뜁니다. "오프셋 차이 = 메시지 건수"로 계산하면 틀릴 수 있습니다.
"파티션을 늘려도 키 순서는 그대로다." 키의 파티션은 murmur2(키) % 파티션 수 입니다. 파티션 수가 바뀌면 같은 키가 다른 파티션으로 갑니다. 이미 쌓인 데이터는 옮겨지지 않습니다. 그래서 user-7 의 옛 이벤트는 파티션 1에, 새 이벤트는 파티션 3에 있게 됩니다. 두 파티션을 다른 컨슈머가 읽으면 새 이벤트가 옛 이벤트보다 먼저 처리될 수 있습니다. 카프카가 보장하는 순서는 파티션 안의 순서뿐입니다.
"보존 기간 7일이면 정확히 7일 뒤 지워진다." 지우는 단위가 세그먼트이고, 기준이 세그먼트 안의 가장 새 레코드입니다. 1GiB 세그먼트가 차는 데 사흘 걸리는 토픽이라면 첫 레코드는 열흘 가까이 남을 수 있습니다. 디스크가 급하면 보존 기간보다 segment.bytes·segment.ms 를 먼저 보십시오.
"커밋 = 처리 완료한 마지막 오프셋." 커밋 값은 다음에 읽을 오프셋입니다. 수동 커밋에서 rec.offset() 을 그대로 넣으면 재시작할 때마다 마지막 한 건이 다시 옵니다. 반대로 처리 전에 커밋하면 죽었을 때 그 건이 사라집니다.
"fsync 를 안 하니 브로커가 죽으면 유실된다." 단일 브로커라면 맞습니다. 하지만 카프카의 설계는 디스크 동기화 대신 복제로 내구성을 얻습니다. 커밋된 메시지(HW 아래)는 ISR 이 하나라도 살아 있으면 남습니다. 유실을 막으려면 log.flush.* 가 아니라 replication.factor, min.insync.replicas, acks=all 을 맞추는 것이 먼저입니다.
"랙이 0이니 컨슈머가 최신이다." 컨슈머가 보는 끝은 LEO 가 아니라 HW 입니다. 리더에 쓰였지만 아직 ISR 전부에 복제되지 않은 메시지는 컨슈머 기준 랙에 잡히지 않습니다. 팔로워 하나가 느리면 그 팔로워가 ISR 에서 빠질 때까지(replica.lag.time.max.ms, 기본 30초) HW 가 멈춰 있을 수 있습니다. 이때 컨슈머 랙은 0으로 보여도 acks=all 프로듀서는 응답을 기다리며 지연이 커집니다.
정리
- 파티션은 디렉터리, 세그먼트는 첫 오프셋을 이름으로 한
.log·.index·.timeindex묶음이고, 쓰기는 활성 세그먼트 끝에만 붙습니다. - 읽기는 "세그먼트 floor 검색 → 성긴 인덱스 이진 탐색 → 짧은 순차 스캔 →
sendfile" 순서로 오프셋을 바이트 위치로 바꿉니다. - 컨슈머가 볼 수 있는 끝은 HW, 재시작 지점은 committed offset(다음에 읽을 번호)이며, 둘 사이의 간격이 중복 처리의 원인입니다.
smith lab 에서 이어서 보기
smith lab(smithlab.co.kr)은 설치·로그인 없이 브라우저에서 바로 쓰는 개발자 도구와 실무 글을 모아 둔 곳입니다. 개발 글 모음도 함께 보세요.
참고 자료
- Apache Kafka 4.3 문서 — Design (Persistence, Efficiency, Consumer Position, Replication)
- Apache Kafka 4.3 문서 — Implementation: Log
- Apache Kafka 4.3 문서 — Implementation: Message Format (RecordBatch)
- Apache Kafka 4.3 Quickstart (Docker 이미지)
- KafkaConsumer Javadoc 4.3 — Offsets and Consumer Position
- apache/kafka — OffsetIndex.java
- apache/kafka — TimeIndex.java
- apache/kafka — AbstractIndex.java (warm 구간 탐색)
- apache/kafka — LogSegment.java
- apache/kafka — BuiltInPartitioner.java
'Develop > [Kafka]' 카테고리의 다른 글
| 카프카 KRaft 원리 — 주키퍼 없는 메타데이터 합의 (0) | 2026.10.27 |
|---|---|
| CDC 원리 — Debezium 이 WAL 을 카프카로 흘리는 법 (0) | 2026.10.26 |
| 카프카 Exactly-once 원리 — 멱등 프로듀서·트랜잭션·LSO (0) | 2026.10.25 |
| 카프카 컨슈머 그룹 리밸런싱은 왜 멈춤을 만드나 — KIP-848 (0) | 2026.10.13 |
| [Kafka] 파티셔너 (0) | 2023.08.31 |


