========================================
LLM 응답을 코드로 받아 쓰는 순간, 문제는 내용보다 형식에서 먼저 터집니다. 프롬프트에 "JSON 으로만 답하세요"라고 써도 모델은 가끔 앞에 "물론입니다!"를 붙이고, 코드 펜스로 감싸고, 필수 키를 빼먹습니다. json.loads 가 예외를 던지면 재시도하고, 그래도 안 되면 정규식으로 긁어냅니다.
구조화된 출력(Structured Outputs)은 이 문제를 생성 단계에서 없앱니다. 모델이 토큰을 고르기 직전에, 스키마상 나올 수 없는 토큰의 확률을 0으로 만듭니다. 이 방식을 제약 디코딩(constrained decoding)이라고 합니다. 이 글은 그 마스크가 어디서 오고, 어떻게 매 토큰마다 빠르게 계산되는지를 따라갑니다.
■ 1. 왜 나왔나 — 프롬프트로는 확률만 올릴 수 있습니다
LLM 은 매 스텝 어휘 전체에 대한 확률 분포를 내고, 그중 하나를 뽑습니다. 프롬프트·예시·파인튜닝은 이 분포를 원하는 쪽으로 기울일 뿐입니다. 0.1% 의 확률로 쉼표 대신 마침표가 나오는 일은 막지 못합니다. 하루 10만 건을 처리하는 파이프라인이라면 0.1% 도 하루 100건입니다.
그래서 단계가 나뉘어 발전했습니다.
- 프롬프트 지시: "JSON 으로 답하라". 형식 보장 없음.
- JSON 모드: 출력이 문법상 유효한 JSON 이 되도록 제한합니다. 그러나 어떤 키가 있어야 하는지, 값의 타입이 무엇인지는 보장하지 않습니다. {} 도 유효한 JSON 입니다.
- 스키마 기반 구조화된 출력: JSON Schema 를 문법으로 컴파일해, 키 이름·타입·필수 여부·열거값까지 디코딩 단계에서 강제합니다.
OpenAI 는 2024년 8월 6일 API 에 Structured Outputs 를 도입하면서, 자체 평가(복잡한 JSON 스키마 따르기)에서 gpt-4o-2024-08-06 + Structured Outputs 가 100%, gpt-4-0613 은 40% 미만이었다고 밝혔습니다. 사내 평가이므로 방법론은 공개되지 않았지만, "지시만으로는 형식이 깨진다"는 출발점은 분명히 보여 줍니다.
오픈소스 쪽에서는 2023년 Outlines 논문(Willard·Louf, arXiv 2307.09702)이 정규식·문법으로 생성을 유도하는 효율적인 방법을 제시했고, 2024년 XGrammar(arXiv 2411.15100)가 문맥 자유 문법(CFG)을 거의 오버헤드 없이 돌리는 엔진을 내놓았습니다. 지금 vLLM 은 XGrammar 와 llguidance 를 구조화된 출력 백엔드로 씁니다.
■ 2. 내부 동작 원리 — 로짓에 마스크를 더합니다
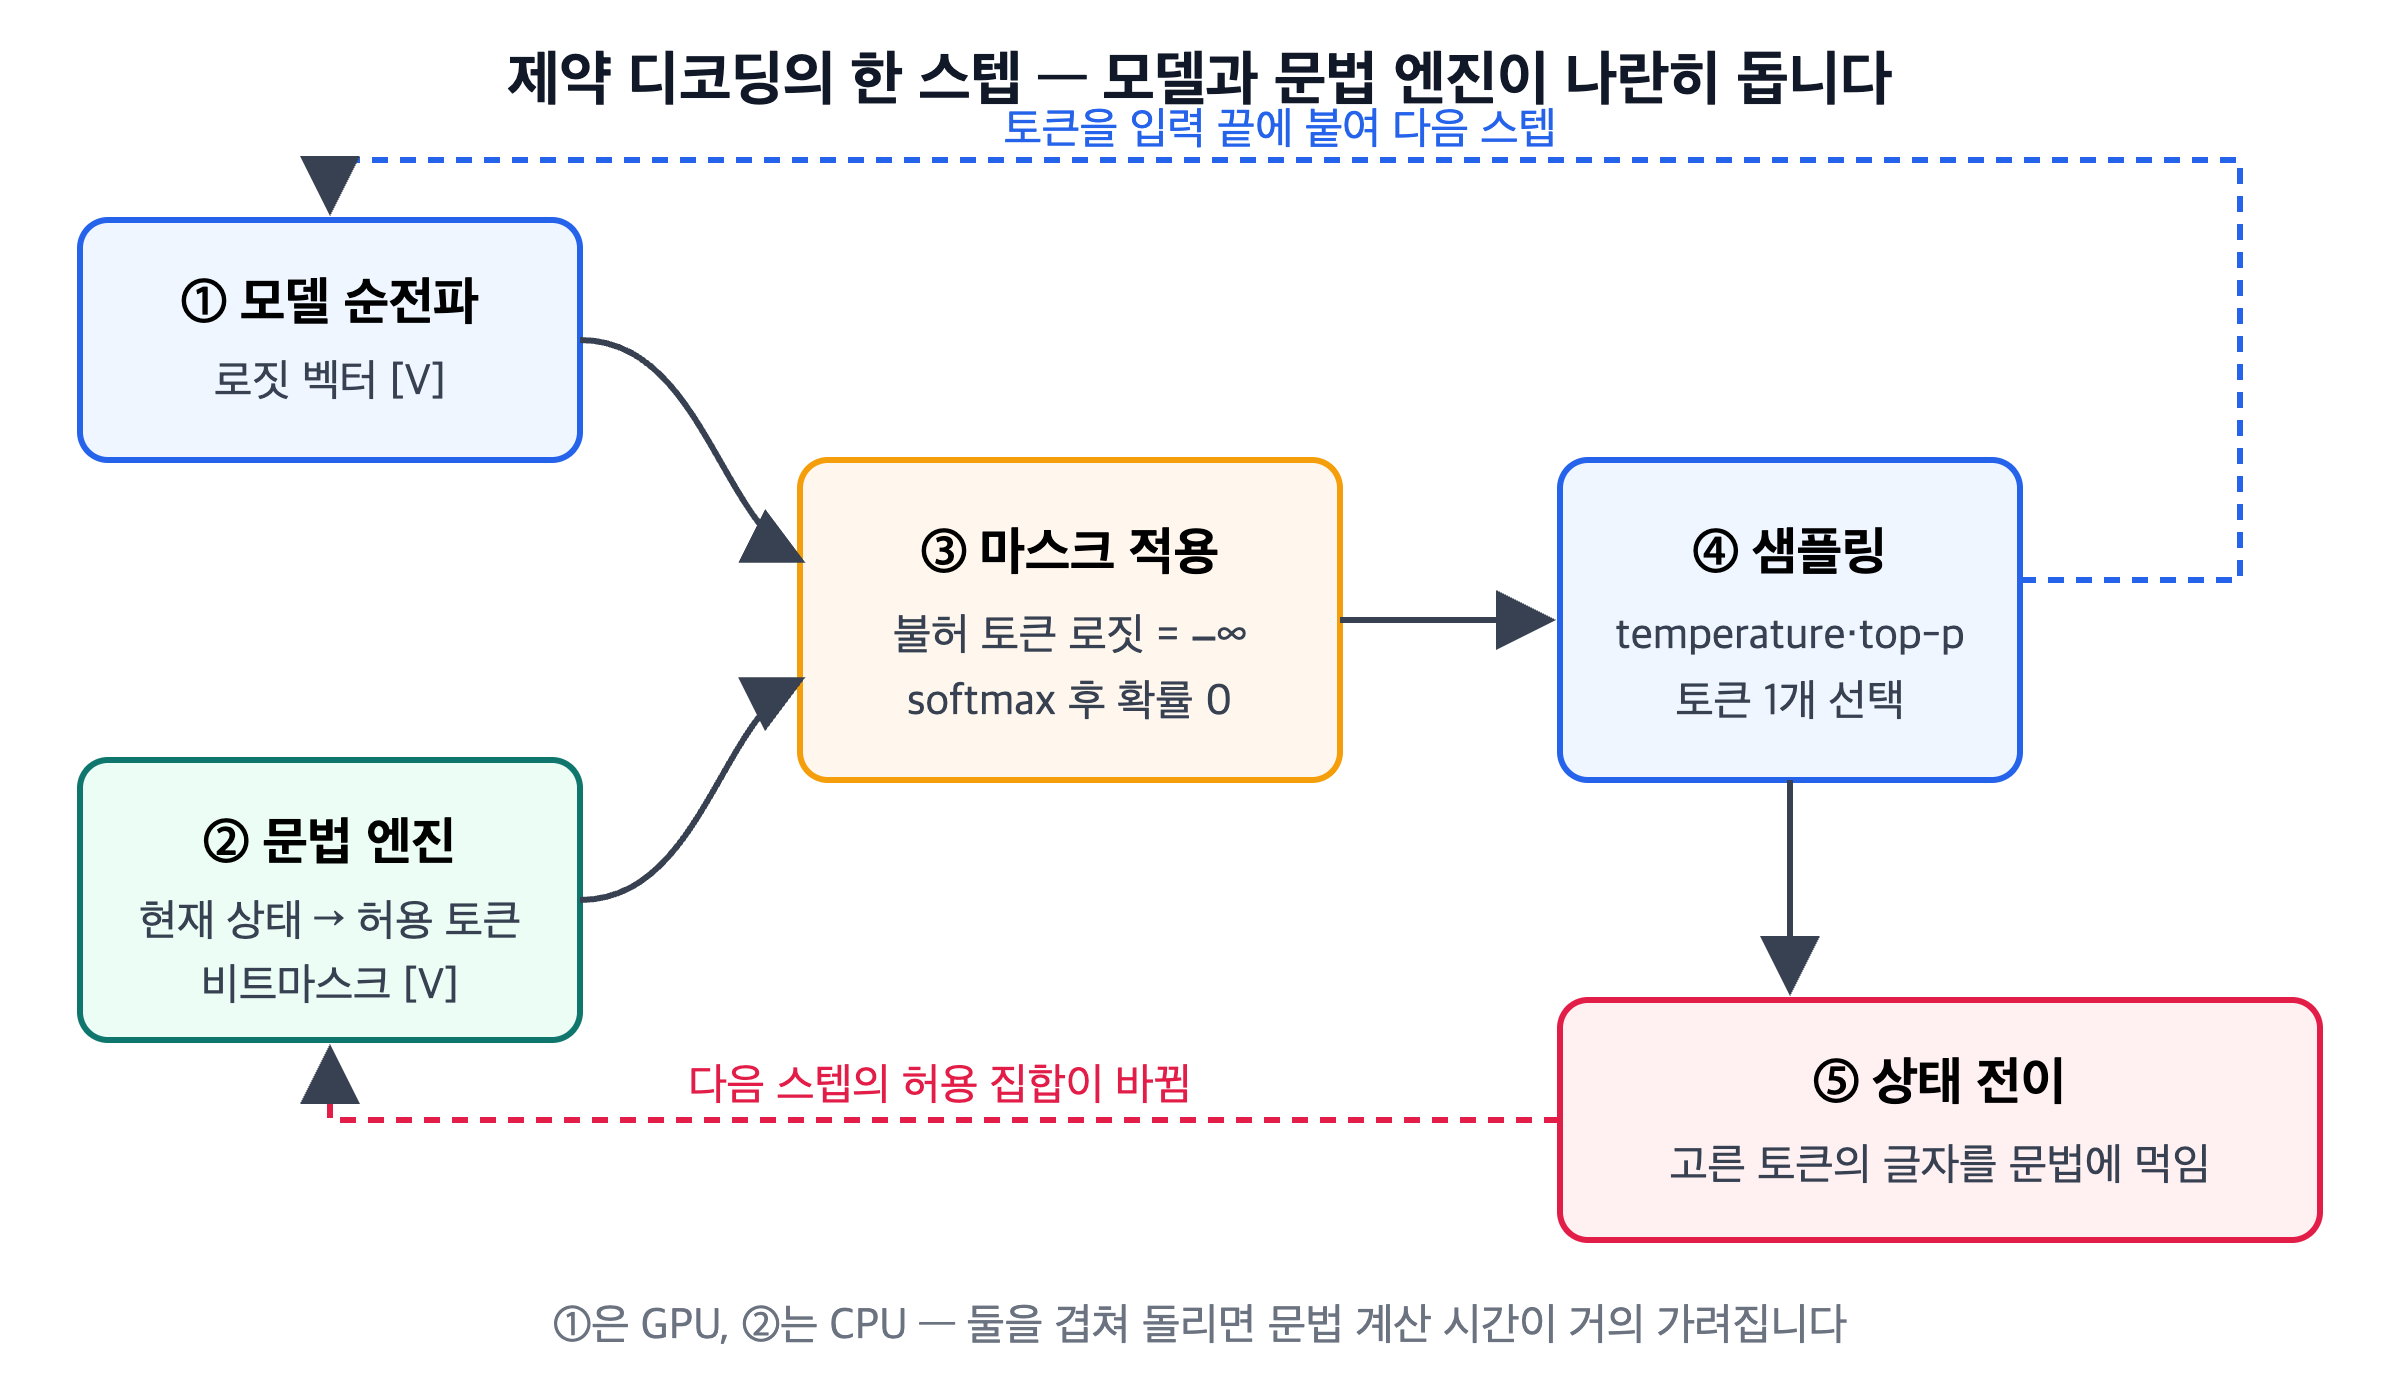
▶ 2-1. 한 스텝의 흐름
생성은 토큰 하나씩 반복됩니다. 제약 디코딩은 이 반복에 문법 엔진 하나를 끼워 넣습니다.
1. 모델 순전파: 지금까지의 토큰을 넣고, 어휘 크기 V 만큼의 로짓(정규화 전 점수) 벡터를 받습니다. Llama 3.1 이라면 V 가 약 128k 입니다.
2. 문법 엔진: 지금까지 출력된 글자를 바탕으로 문법의 현재 상태를 압니다. 이 상태에서 다음에 와도 되는 토큰 집합을 V 비트짜리 마스크로 만듭니다.
3. 마스크 적용: 허용되지 않은 토큰의 로짓을 −∞ 로 바꿉니다. softmax 를 거치면 그 토큰들의 확률은 정확히 0 이 됩니다.
4. 샘플링: 남은 토큰들 사이에서 평소처럼 temperature·top-p 로 하나를 뽑습니다.
5. 상태 전이: 뽑힌 토큰의 글자들을 문법 엔진에 먹여 다음 상태로 옮깁니다. 그리고 1번으로 돌아갑니다.
수식으로 쓰면 하나입니다.
[코드: text]
p'(t) = p(t) · m(t) / Σ_u p(u) · m(u) m(t) ∈ {0, 1}
[/코드]
말로 풀면 이렇습니다. 모델이 원래 준 확률 p 에서 허용된 토큰(m=1)만 남기고, 남은 것끼리 합이 1 이 되도록 다시 나눕니다. 허용된 토큰들 사이의 상대적 순위는 그대로입니다. 모델의 판단을 바꾸는 게 아니라, 판단할 후보를 잘라 낼 뿐입니다.
여기서 핵심 비용은 2번입니다. 모델 순전파는 GPU 가 하지만, 마스크는 문법을 따라가며 계산해야 합니다. 128k 개 토큰을 매 스텝 하나씩 문법에 대 보면 느립니다. 두 논문은 모두 이 2번을 빠르게 만드는 이야기입니다.
▶ 2-2. 토큰은 글자가 아닙니다
문법은 글자 단위로 정의됩니다. 그런데 모델은 토큰 단위로 냅니다. 토큰 하나가 {", name, ":", 3} 처럼 여러 글자를 담습니다. 그래서 "이 토큰이 허용되는가"는 "이 토큰의 글자들을 현재 상태에서 차례로 먹였을 때 문법이 깨지지 않는가"라는 질문이 됩니다.
같은 이유로 문법 엔진은 반드시 모델과 같은 토크나이저를 알아야 합니다. 스키마가 같아도 모델이 바뀌면 어휘가 바뀌고, 마스크 색인도 다시 만들어야 합니다.
▶ 2-3. 정규식 수준: 유한 상태 기계와 색인 (Outlines)
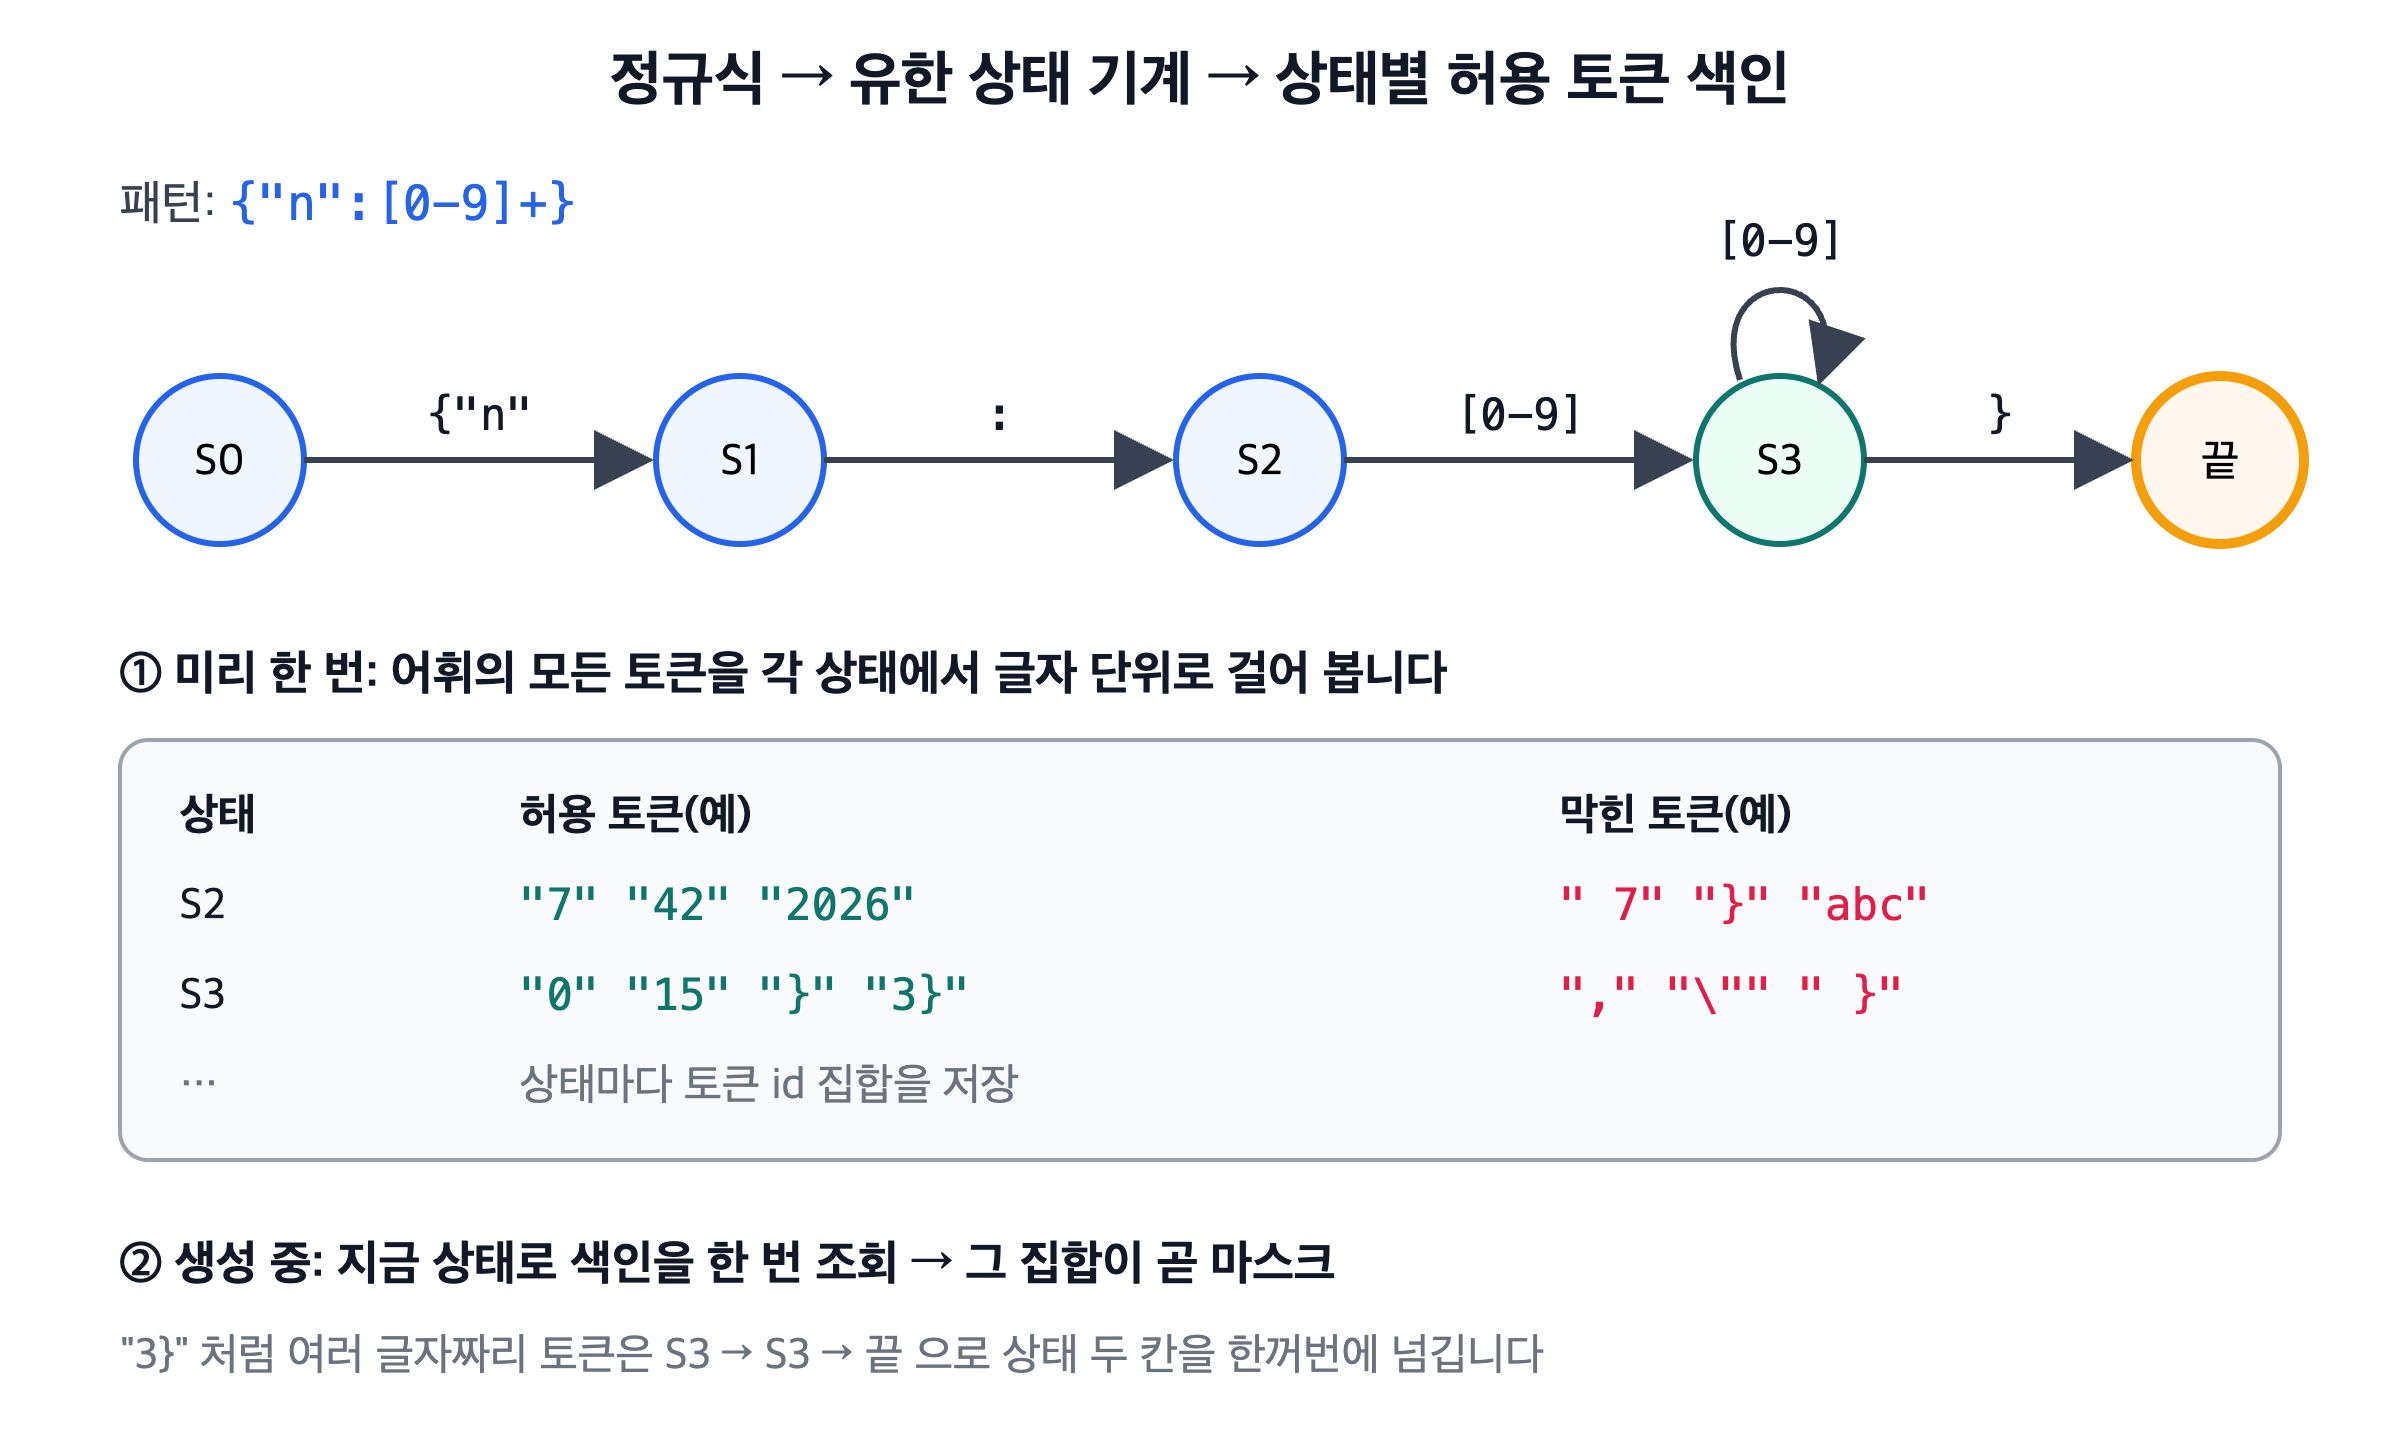
Outlines 논문의 아이디어는 생성을 유한 상태 기계(FSM)의 상태 전이로 다시 보는 것입니다.
1. 정규식을 결정적 유한 오토마톤(DFA)으로 바꿉니다. [0-9]+ 라면 "숫자를 하나 이상 읽은 상태" 같은 상태들이 생깁니다.
2. 생성 전에 한 번, 어휘의 모든 토큰을 모든 상태에서 글자 단위로 걸어 봅니다. 끝까지 막히지 않고 걸어지는 토큰을 그 상태의 허용 집합에 넣습니다. 도착 상태도 함께 기록합니다.
3. 생성 중에는 현재 상태로 이 색인을 조회만 합니다. 조회 결과가 곧 마스크입니다. 토큰을 고르면 기록해 둔 도착 상태로 옮깁니다.
비싼 계산을 컴파일 시간으로 미루고, 생성 루프에서는 표 조회만 남긴 구조입니다. JSON Schema 도 정규식으로 바꿀 수 있는 범위에서는 이 방식으로 처리합니다. 키 순서와 이름이 정해진 객체, 열거값, 정수 범위 같은 것들입니다.
한계도 여기서 나옵니다. 정규식은 괄호의 짝을 셀 수 없습니다. 깊이가 정해지지 않은 중첩 객체나 재귀 스키마(트리 구조 같은 것)는 FSM 으로 정확히 표현되지 않습니다.
▶ 2-4. 문맥 자유 문법 수준: 스택과 토큰 나누기 (XGrammar)
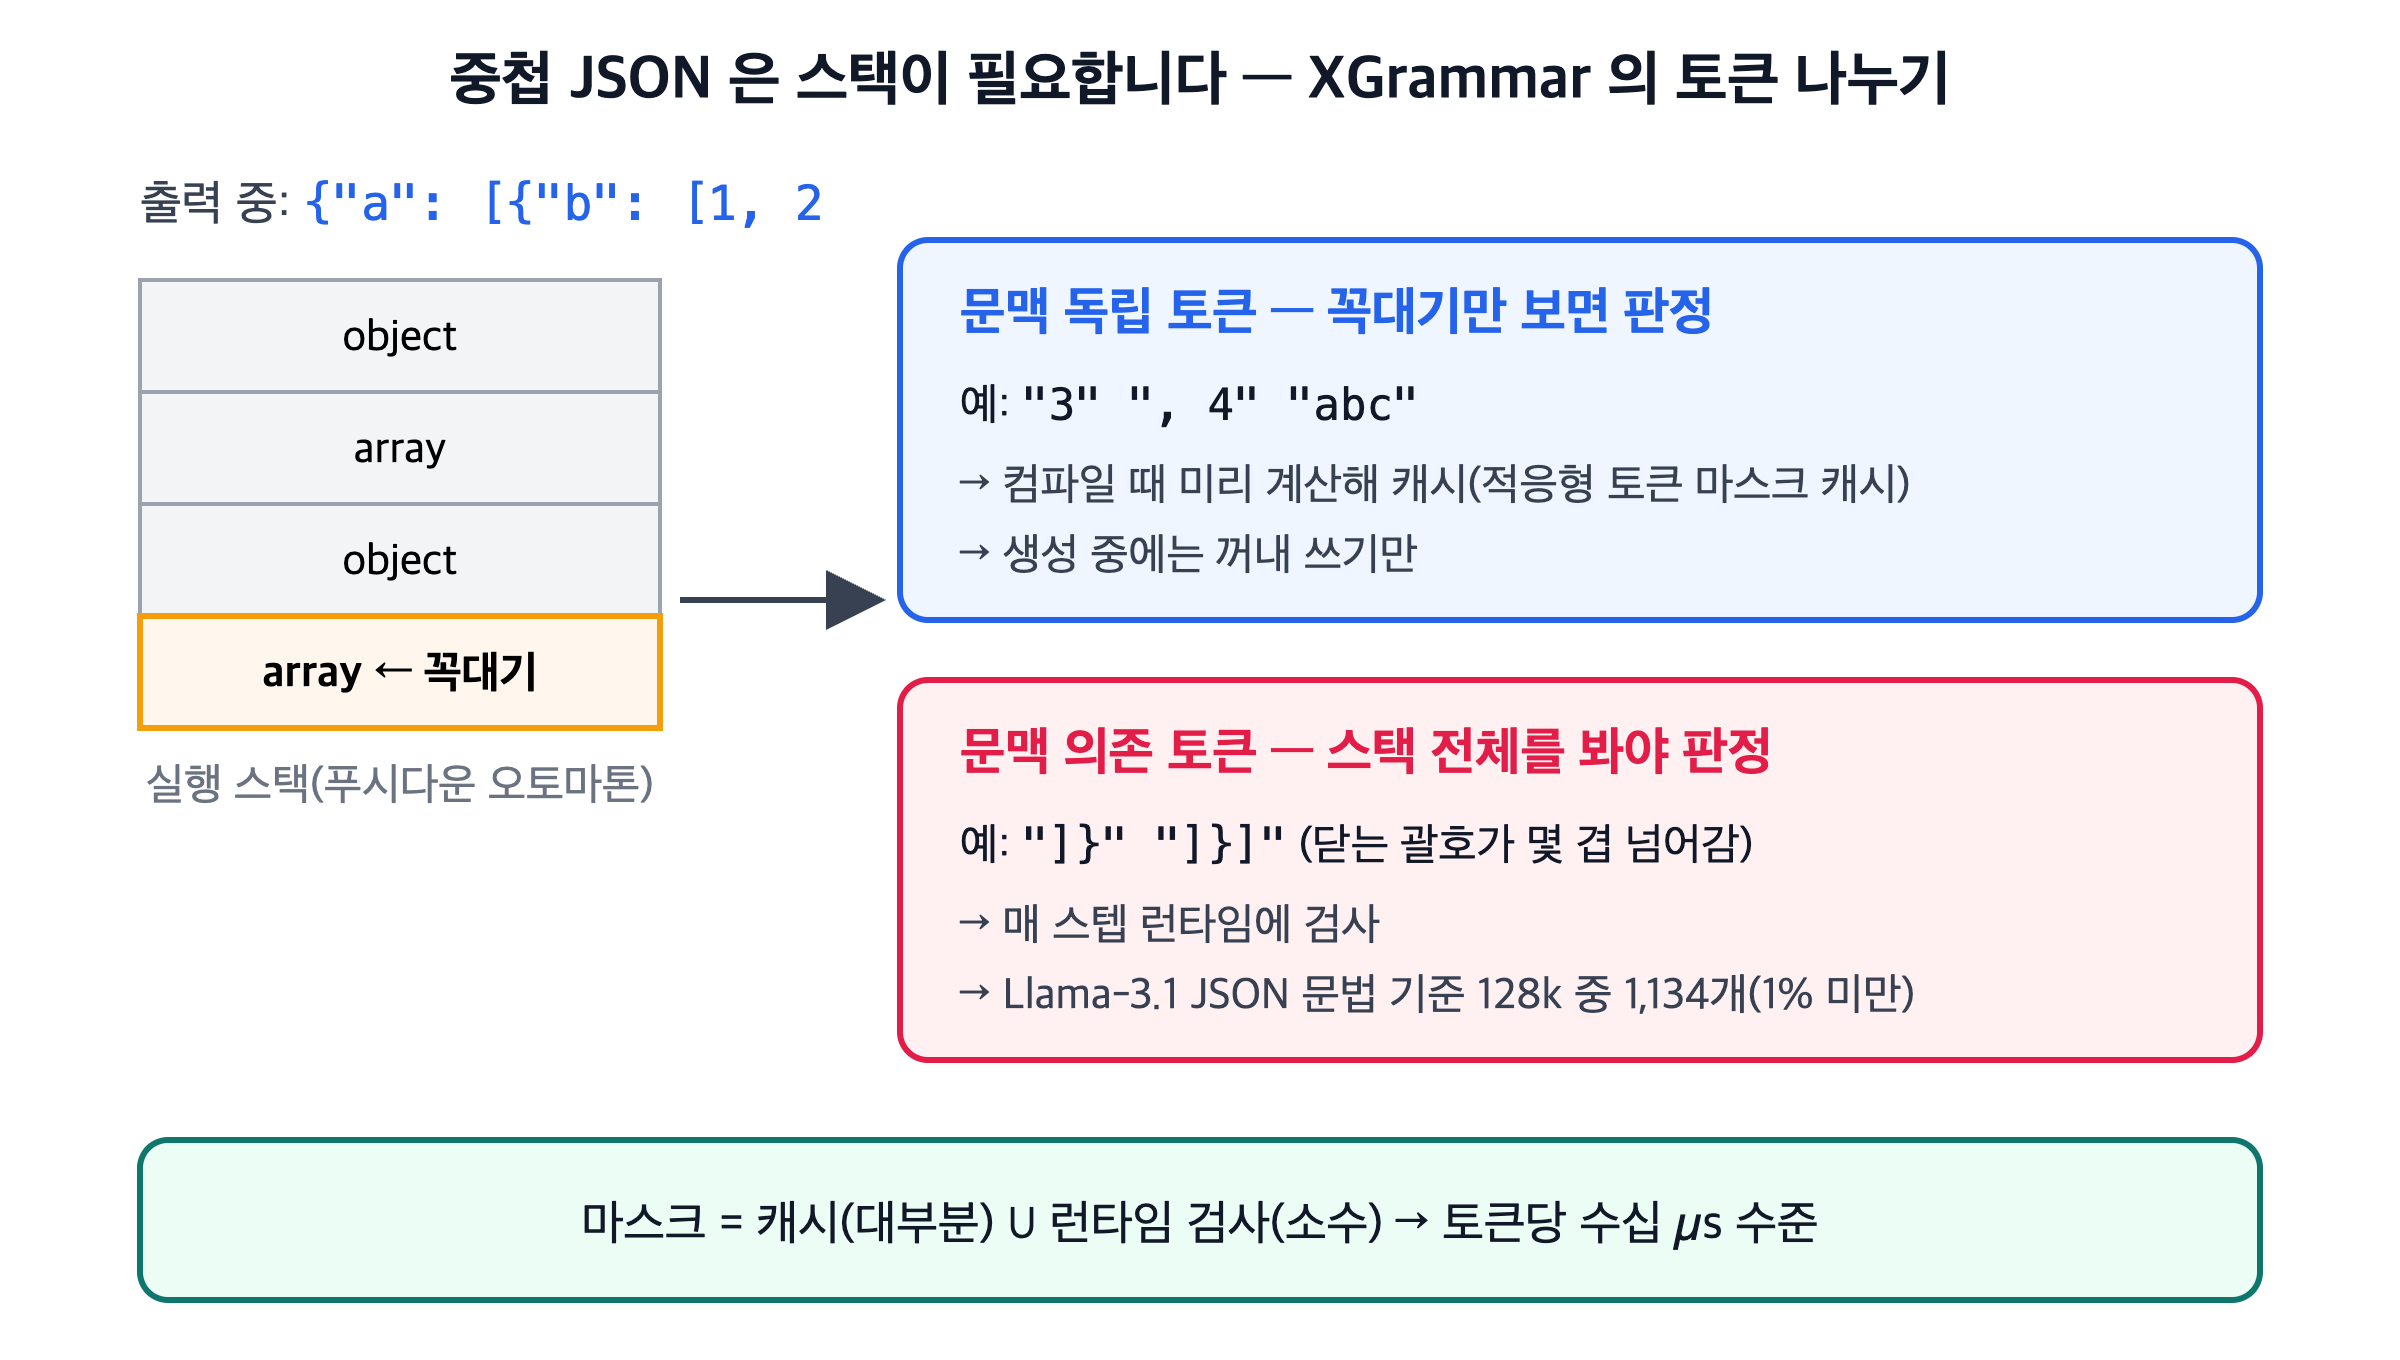
중첩을 다루려면 문맥 자유 문법(CFG)과 그것을 실행하는 푸시다운 오토마톤(PDA), 즉 스택이 있는 상태 기계가 필요합니다. { 를 만나면 "객체"를 스택에 쌓고, } 를 만나면 꺼냅니다. 문제는 스택 내용이 무한히 다양하므로, FSM 처럼 모든 경우를 미리 표로 만들 수 없다는 점입니다.
XGrammar 는 어휘를 두 무리로 나눕니다.
- 문맥 독립 토큰: 스택 꼭대기 노드만 보면 허용 여부가 정해지는 토큰. 예를 들어 숫자 배열 안에서 "3" 이나 ", 4" 는 그 아래 스택이 무엇이든 판정이 같습니다. 이 결과는 문법 컴파일 때 미리 계산해 캐시합니다(논문 용어로 적응형 토큰 마스크 캐시).
- 문맥 의존 토큰: 스택 전체를 봐야 판정되는 토큰. "]}" 처럼 닫는 괄호가 여러 겹을 넘어가는 토큰이 대표적입니다. 이것만 생성 중에 실제 스택으로 검사합니다.
논문에 따르면 Llama-3.1 어휘와 JSON 문법에서 문맥 의존 토큰은 128k 중 1,134개로 1% 미만이고, 문맥 확장이라는 문법 변환을 거치면 120개로 더 줄어듭니다. 캐시 메모리는 160MB 에서 0.46MB 로 줄었습니다. 여기에 여러 스택을 하나의 트리로 공유하는 지속형(persistent) 스택, 그리고 마스크 계산(CPU)을 모델 순전파(GPU)와 겹쳐 실행하는 기법을 더했습니다.
같은 논문의 측정(Llama-3.1-8B-Instruct, Ryzen 9 7950X + RTX 4090)에서 토큰당 마스크 생성 시간은 JSON Schema·JSON 문법 기준 40µs 미만이었습니다. 단순 PDA 구현은 토큰당 65.776ms 였고, 모든 최적화를 넣으면 0.018ms 가 됐습니다. 모델 한 스텝이 보통 밀리초 단위이니, 마스크 계산은 GPU 가 도는 사이에 끝나 버립니다.
▶ 2-5. 서버에서 요청이 흐르는 순서
vLLM 같은 추론 서버에 스키마를 담은 요청이 들어오면 순서는 이렇습니다.
1. 요청의 JSON Schema(또는 정규식·선택지·문법)를 받습니다.
2. 백엔드(XGrammar 등)가 이를 문법으로 바꾸고, 모델 토크나이저 기준으로 컴파일합니다. 이때 캐시 가능한 마스크를 미리 계산합니다. 같은 스키마는 컴파일 결과를 재사용합니다.
3. 디코딩 루프에서 요청마다 문법 상태를 따로 들고, 배치의 각 시퀀스에 자기 비트마스크를 적용합니다.
4. 문법이 끝 상태에 도달하면 EOS 만 허용되어 생성이 멈춥니다.
2번이 첫 요청에만 붙는 비용입니다. 스키마가 크고 매번 달라지면 이 컴파일 비용이 눈에 띌 수 있습니다.
■ 3. 직접 해 보기
▶ 3-1. 마스크를 손으로 짜 보기 (Transformers)
원리를 확인하는 데는 라이브러리 없이 LogitsProcessor 하나면 충분합니다. 아래는 출력이 세 문자열 중 하나가 되도록 강제합니다. 각 선택지를 토큰 id 열로 바꿔 두고, 지금까지 만든 토큰과 앞부분이 일치하는 선택지의 "다음 토큰"만 허용합니다. 선택지를 트리로 본 가장 단순한 문법 엔진입니다.
[코드: python]
# pip install torch transformers
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, LogitsProcessor, LogitsProcessorList
MODEL = "Qwen/Qwen2.5-0.5B-Instruct"
tok = AutoTokenizer.from_pretrained(MODEL)
model = AutoModelForCausalLM.from_pretrained(MODEL)
CHOICES = ['{"label": "positive"}', '{"label": "negative"}', '{"label": "neutral"}']
# 허용 문자열을 토큰 id 열로 바꾸고, 끝에 EOS 를 붙여 거기서 멈추게 합니다.
SEQS = [tok.encode(c, add_special_tokens=False) + [tok.eos_token_id] for c in CHOICES]
class ChoiceMask(LogitsProcessor):
def __init__(self, prompt_len):
self.prompt_len = prompt_len
def __call__(self, input_ids, scores):
done = input_ids[0, self.prompt_len:].tolist() # 지금까지 만든 토큰
allowed = {s[len(done)] for s in SEQS
if len(s) > len(done) and s[:len(done)] == done}
mask = torch.full_like(scores, float("-inf"))
mask[:, list(allowed)] = 0 # 허용 토큰만 남깁니다
return scores + mask
msgs = [{"role": "user", "content": "리뷰: '배송이 빠르고 품질이 좋아요.' 감정을 JSON 으로."}]
inputs = tok.apply_chat_template(msgs, add_generation_prompt=True,
return_tensors="pt", return_dict=True)
plen = inputs["input_ids"].shape[1]
out = model.generate(**inputs, max_new_tokens=20, do_sample=False,
logits_processor=LogitsProcessorList([ChoiceMask(plen)]))
print(tok.decode(out[0, plen:], skip_special_tokens=True))
[/코드]
scores + mask 한 줄이 2절의 수식 그 자체입니다. 실제 엔진은 이 allowed 계산을 정규식 FSM 이나 PDA 로 바꾸고, 미리 색인해 빠르게 만든 것입니다.
▶ 3-2. 라이브러리로 스키마 강제하기 (Outlines)
Pydantic 모델을 그대로 출력 타입으로 넘깁니다. Outlines 가 JSON Schema 를 문법으로 바꾸고 마스크를 붙입니다.
[코드: python]
# pip install outlines transformers torch
from typing import Literal
from pydantic import BaseModel
import outlines
from transformers import AutoTokenizer, AutoModelForCausalLM
MODEL = "Qwen/Qwen2.5-0.5B-Instruct"
model = outlines.from_transformers(
AutoModelForCausalLM.from_pretrained(MODEL),
AutoTokenizer.from_pretrained(MODEL),
)
class Review(BaseModel):
sentiment: Literal["positive", "negative", "neutral"]
score: int
keywords: list[str]
prompt = ("다음 리뷰를 sentiment, score(1~5), keywords 키를 가진 JSON 으로 분석하세요: "
"'배송은 느렸지만 품질은 훌륭합니다.'")
raw = model(prompt, Review, max_new_tokens=200)
print(Review.model_validate_json(raw))
[/코드]
▶ 3-3. 추론 서버에 요청하기 (vLLM)
vLLM 의 OpenAI 호환 서버는 구조화된 출력이 기본으로 켜져 있습니다. 표준 response_format 으로 스키마를 넘깁니다.
[코드: python]
# 서버: vllm serve Qwen/Qwen2.5-0.5B-Instruct
from openai import OpenAI
from pydantic import BaseModel
class Review(BaseModel):
sentiment: str
score: int
client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")
resp = client.chat.completions.create(
model="Qwen/Qwen2.5-0.5B-Instruct",
messages=[{"role": "user", "content": "'품질 최고' 리뷰를 sentiment, score 로 분석해 JSON 으로."}],
response_format={"type": "json_schema",
"json_schema": {"name": "review", "schema": Review.model_json_schema()}},
)
print(resp.choices[0].message.content)
[/코드]
선택지·정규식만 필요하면 vLLM 고유 필드 extra_body={"structured_outputs": {"choice": ["positive", "negative"]}} 를 씁니다. 예전의 guided_json 같은 필드는 v0.12.0 에서 제거됐습니다.
■ 4. 비교
▶ 형식을 얻는 방법별 차이
방법 | 무엇을 보장하나 | 원리 | 실패 시
--------------------------------------------------
프롬프트 지시 | 없음(확률만 올림) | 지시·예시 | 파싱 오류 → 재시도
JSON 모드 | 문법상 유효한 JSON | JSON 문법 마스크 | 키 누락·타입 불일치 가능
스키마 구조화 출력 | 스키마 일치(지원 범위 안) | 스키마 → 문법 → 마스크 | 길이 잘림 외엔 형식 오류 없음
함수 호출 strict | 인자가 스키마 일치 | 위와 같음, 도구 인자에 적용 | 위와 같음
사후 검증 + 재시도 | 결국 일치(비용 증가) | 파싱·검증 후 재요청 | 지연·토큰 비용 누적
▶ 엔진별 차이
엔진 | 표현력 | 마스크 계산 방식 | 쓰이는 곳
--------------------------------------------------------
Outlines | 정규식·JSON Schema·CFG | 정규식은 FSM 상태별 토큰 색인을 미리 구축 | Transformers 등 여러 모델 백엔드
XGrammar | CFG(바이트 단위 PDA) | 문맥 독립 토큰은 캐시, 의존 토큰만 런타임 검사 | vLLM·SGLang·TensorRT-LLM 기본 백엔드
llguidance | CFG | Rust 구현, 런타임 계산 | vLLM guidance 백엔드
llama.cpp GBNF | GBNF 문법, JSON Schema 일부 | 샘플러 단계에서 문법 검사 | --grammar, -j, 서버 json_schema
■ 5. 흔한 오해와 실수
"형식이 맞으면 내용도 맞다." 아닙니다. 마스크는 score 가 정수임을 보장할 뿐, 그 정수가 옳은지는 모릅니다. 근거가 없을 때도 모델은 스키마에 맞는 그럴듯한 값을 채웁니다. 모를 수 있는 필드는 null 을 허용하거나 "unknown" 같은 열거값을 열어 두세요. 그래야 모델이 "모름"을 말할 통로가 생깁니다.
"스키마를 넘겼으니 프롬프트에 설명은 안 써도 된다." 마스크는 모델 입력에 아무것도 넣지 않습니다. 모델은 자기가 어떤 틀 안에서 쓰고 있는지 모른 채, 허용된 후보 중에서만 고르게 됩니다. llama.cpp 문서도 스키마는 출력만 제약하고 프롬프트에 추가되지 않으니 기대하는 구조를 프롬프트에 적으라고 안내합니다. 필드의 뜻을 프롬프트에 함께 적어야 품질이 나옵니다.
"답을 먼저, 이유는 나중에." JSON 은 키 순서대로 생성됩니다. {"answer": ..., "reasoning": ...} 이면 모델은 생각하기 전에 답부터 확정합니다. 뒤에 오는 이유는 이미 정한 답을 합리화할 뿐입니다. 추론이 필요한 작업이면 reasoning 을 앞에 두세요. "Let Me Speak Freely?"(arXiv 2408.02442) 논문은 형식 제약 아래에서 추론 성능이 눈에 띄게 떨어지고, 제약이 엄격할수록 더 떨어지는 경향을 보고했습니다. 어려운 추론은 자유 형식으로 먼저 생각하게 하고, 마지막에 구조화하는 두 단계도 방법입니다.
"마스크를 씌우면 출력이 절대 안 깨진다." max_tokens 에 걸리면 생성은 문법과 무관하게 멈춥니다. 닫는 괄호가 없는 JSON 이 돌아옵니다. 종료 사유(finish_reason 이 length 인지)를 반드시 확인하세요. 배열 길이에 상한(maxItems)이 없는 스키마는 모델이 끝없이 항목을 붙이다 잘리는 일도 생깁니다.
"모든 JSON Schema 기능이 된다." 구현마다 지원 범위가 다릅니다. llama.cpp 문서는 prefixItems, 중첩 $ref, properties 와 anyOf/oneOf 섞어 쓰기 등을 미지원·문제 있는 기능으로 적어 두었습니다. 지원하지 않는 키워드는 오류가 나거나 조용히 무시될 수 있으니, 엔진 문서의 지원 목록을 먼저 확인하세요.
"문법만 맞으면 속도는 같다." 문법을 어떻게 쓰느냐에 따라 마스크 계산량이 달라집니다. llama.cpp 문서는 선택적 반복을 x? x? x?... 처럼 쓰면 샘플링이 극도로 느려질 수 있으니 x{0,N} 을 쓰라고 권합니다. 같은 뜻이라도 상태 수가 폭발하지 않는 형태로 써야 합니다.
"마스크는 모델 분포를 그대로 지킨다." 한 스텝 안에서는 허용 토큰끼리의 순위를 지킵니다. 하지만 스텝마다 따로 자르고 다시 정규화하므로, 전체 시퀀스 단위로 보면 "모델이 이 스키마 안에서 가장 그럴듯하다고 볼 출력"과 같지 않을 수 있습니다. 모델이 쓰고 싶던 토큰이 막히면 어색한 다음 토큰으로 밀려납니다. 키 이름을 모델이 자연스럽게 쓸 만한 낱말로 짓고, 프롬프트에 예시를 주면 이 어긋남이 줄어듭니다.
■ 6. 정리
- 구조화된 출력은 매 토큰 로짓에 문법 마스크를 더해, 스키마에 어긋나는 토큰의 확률을 0으로 만드는 기법입니다.
- 정규식은 FSM 상태별 토큰 색인(Outlines)으로, 중첩 JSON 은 스택과 캐시된 마스크(XGrammar)로 풀어 토큰당 오버헤드를 마이크로초 수준으로 낮췄습니다.
- 보장하는 건 형식뿐입니다. 필드 순서·프롬프트 설명·길이 상한·finish_reason 확인은 여전히 개발자 몫입니다.
━━━━━━━━━━━━━━━━━━━━━
━━━━━━━━━━━━━━━
■ 참고 자료
- Willard, Louf, "Efficient Guided Generation for Large Language Models" — https://arxiv.org/abs/2307.09702
- Dong 외, "XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models" — https://arxiv.org/abs/2411.15100
- Tam 외, "Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of Large Language Models" — https://arxiv.org/abs/2408.02442
- OpenAI, "Introducing Structured Outputs in the API" — https://openai.com/index/introducing-structured-outputs-in-the-api/
- vLLM 문서, Structured Outputs — https://docs.vllm.ai/en/latest/features/structured_outputs/
- llama.cpp, GBNF Guide — https://github.com/ggml-org/llama.cpp/blob/master/grammars/README.md
- Outlines 저장소 — https://github.com/dottxt-ai/outlines
- XGrammar 저장소 — https://github.com/mlc-ai/xgrammar
'[Ai Developer]' 카테고리의 다른 글
| 토크나이저와 BPE 원리 — LLM 이 글자를 숫자로 바꾸는 법 (0) | 2026.10.13 |
|---|---|
| MXC·Gemini 에이전트·텔레그램 CVE — 이번 주 IT 뉴스 (0) | 2026.10.12 |
