
ollama run 한 줄이면 노트북에서 LLM 이 대답합니다. 그러다 "GPU 좋은 걸 샀는데 왜 글자 나오는 속도는 그대로지?", "요청마다 왜 몇 초씩 멈추지?" 같은 질문에서 막힙니다. 이 글은 llama.cpp 와 Ollama 가 GGUF 파일 하나를 받아 토큰을 내보내기까지 무엇을 하는지, 소스 코드 기준으로 한 단계씩 따라갑니다. 기준은 2026년 10월 두 저장소의 main·master 브랜치입니다.
양자화 자체(INT4·GGUF 블록 구조)는 지난 양자화 글에서 다뤘습니다. 이번 글은 그다음, 그 파일이 메모리에 올라가고 계산되는 과정입니다.
왜 나왔나 — 파이토치 서버의 전제가 노트북에 안 맞는다
LLM 서빙의 기본형은 파이썬 + 파이토치 + CUDA GPU 입니다. 16비트 가중치가 VRAM 에 통째로 들어가고, CUDA 툴킷을 깔 수 있고, 요청이 몰려 배치로 묶는 편이 이득이라는 전제입니다. 노트북은 셋 다 어긋납니다. VRAM 은 작거나 없고, 맥에는 CUDA 가 없고, 요청은 한 사람이 보내는 한 건입니다.
llama.cpp 는 이 조건을 겨냥해 나왔습니다. README 가 밝히는 목표는 "최소한의 설정으로 넓은 하드웨어에서 LLM 추론"이고, 특징으로 의존성 없는 순수 C/C++ 구현, "애플 실리콘은 일등 시민"(ARM NEON·Accelerate·Metal 최적화), x86 의 AVX·AVX2·AVX512·AMX, 1.5비트부터 8비트까지 정수 양자화, 그리고 "VRAM 보다 큰 모델을 일부만 가속하는 CPU+GPU 하이브리드 추론"을 꼽습니다. 연산 라이브러리는 같은 팀의 ggml 입니다.
Ollama 는 그 위에 얹힌 관리 계층입니다. 모델 내려받기, 이름으로 부르기, 메모리에 올리고 내리기, HTTP API 를 맡습니다. 현재 Ollama 소스(llm/llama_server.go)의 첫 줄 주석은 이렇습니다. "llama_server.go wraps the llama-server binary as a subprocess". 즉 지금의 Ollama 는 llama.cpp 의 llama-server 를 자식 프로세스로 띄워 일을 맡깁니다.

내부 동작 원리 1 — 요청이 프로세스 두 개를 지나는 길
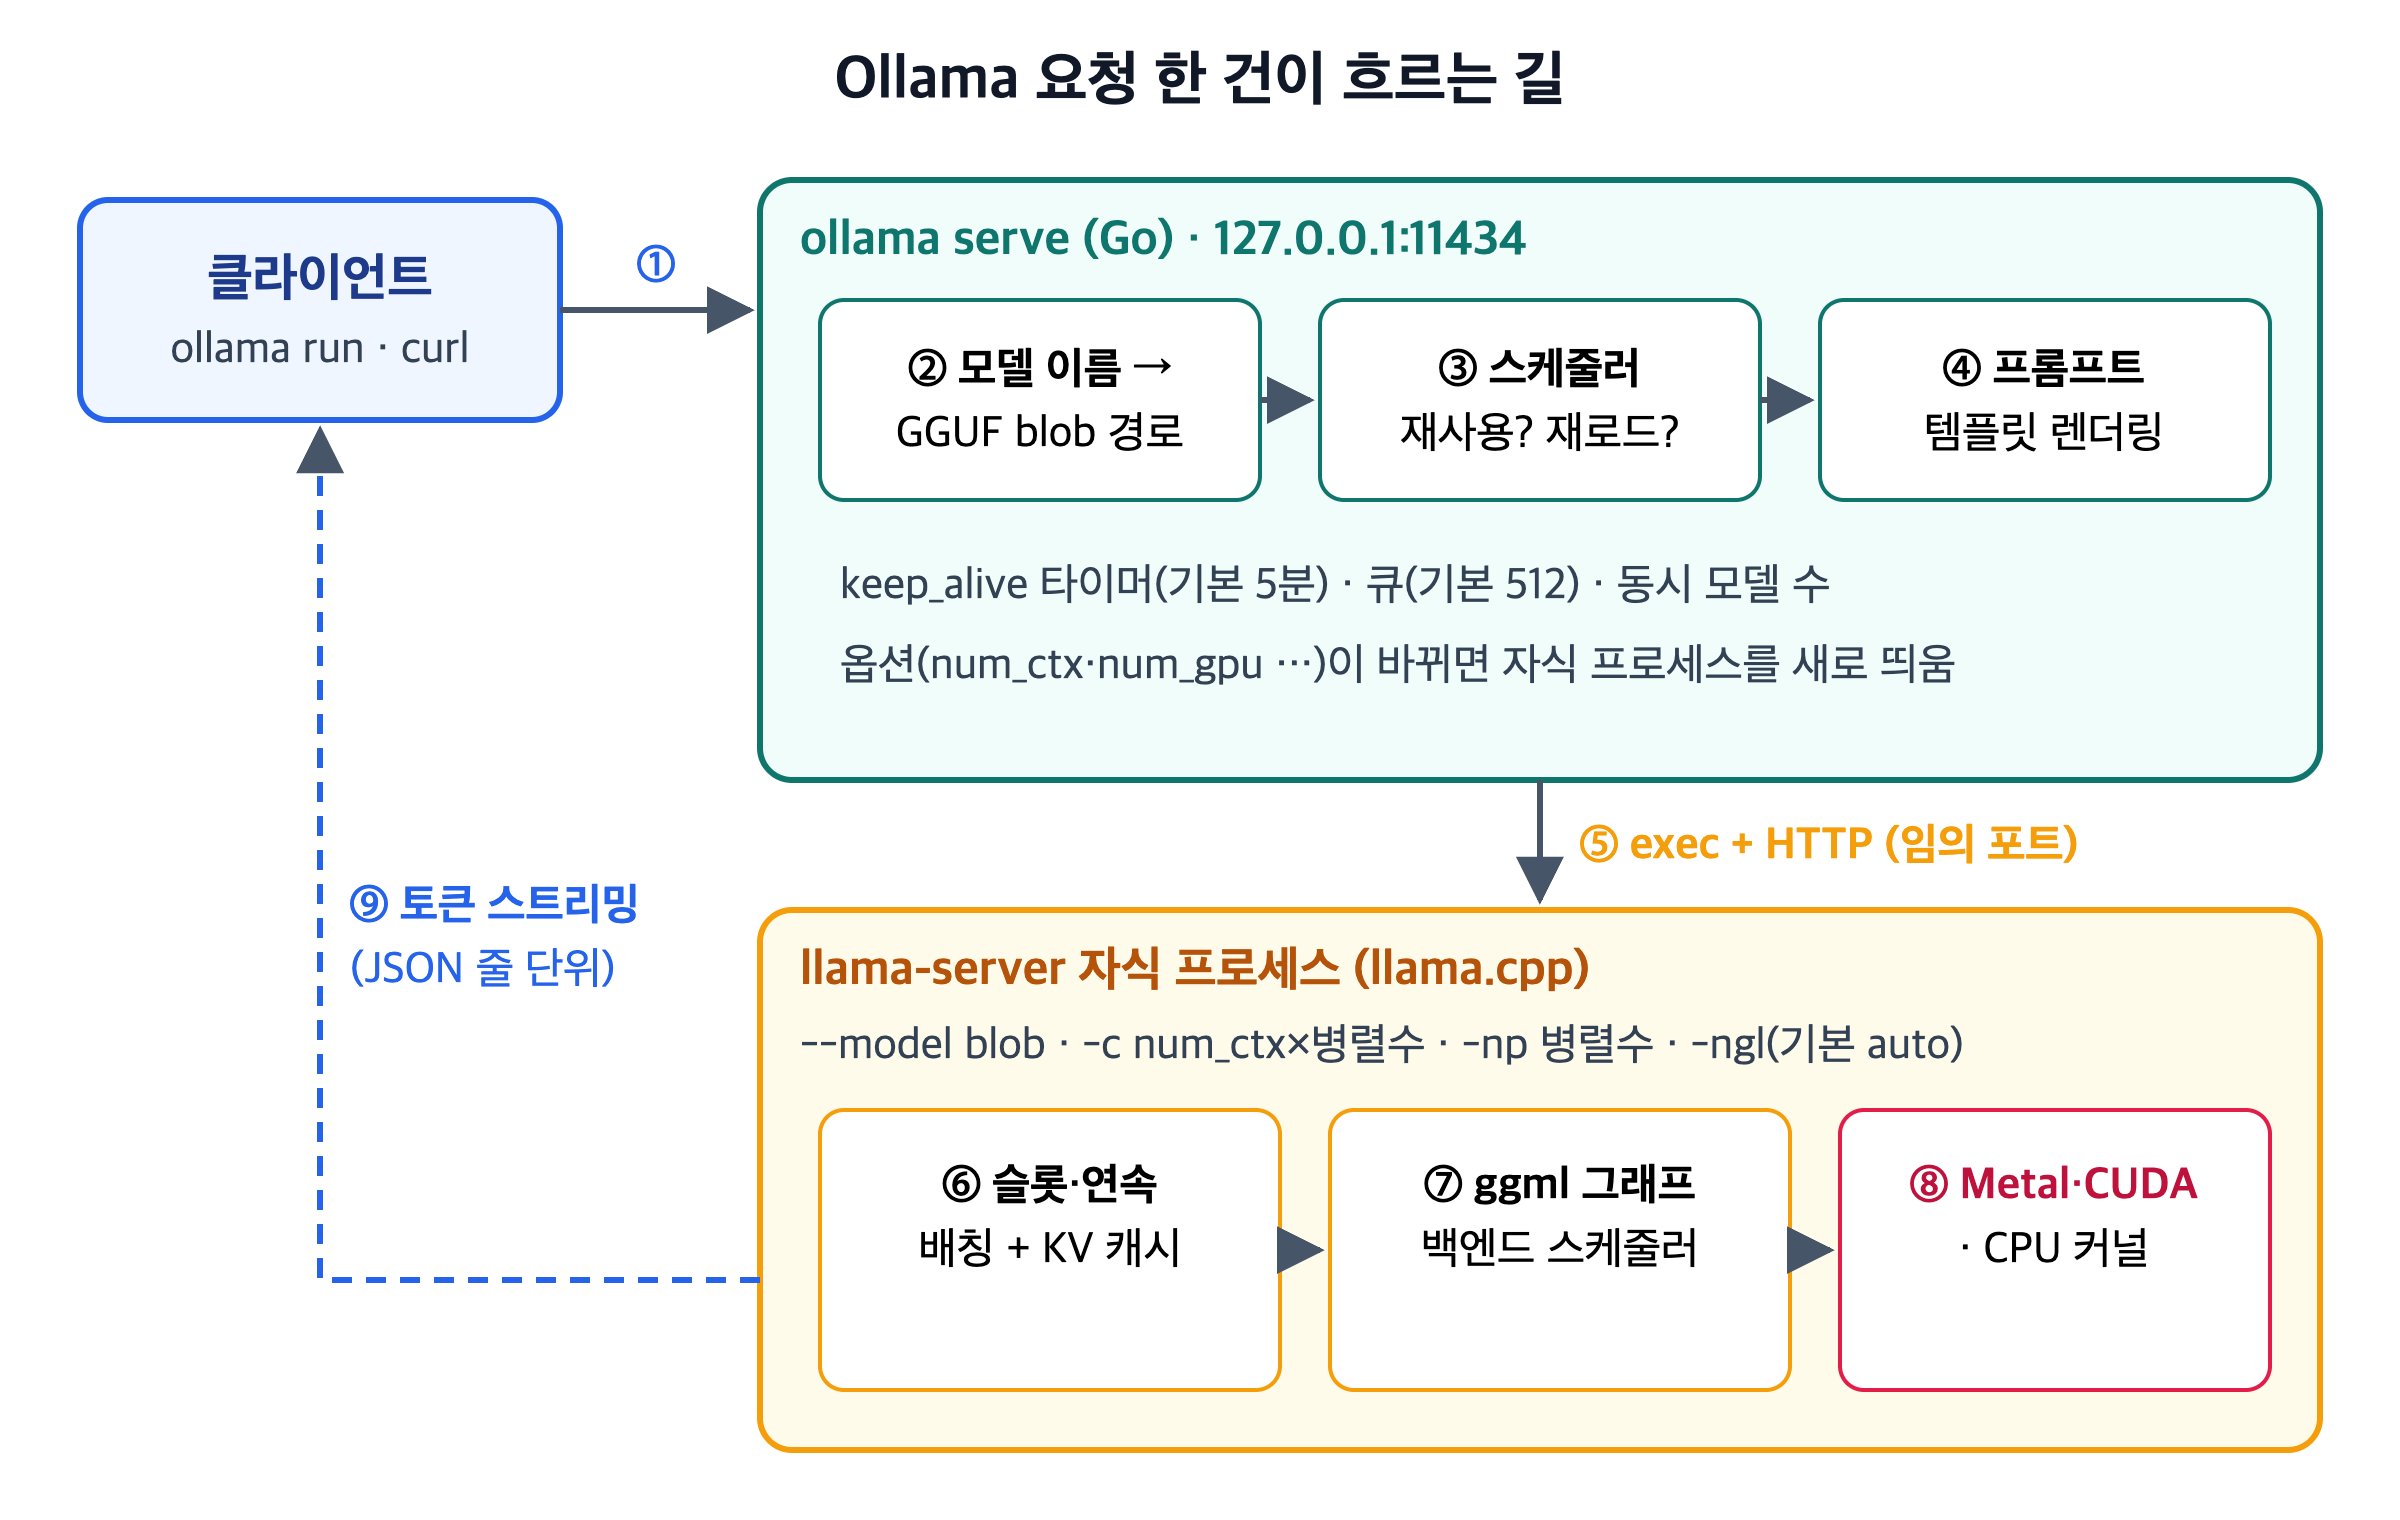
Ollama 에 요청 한 건을 보내면 아래 순서로 흐릅니다.
- 수신.
ollama serve가127.0.0.1:11434에서 기다립니다(FAQ 의 기본 바인딩 주소).ollama run도 결국 이 HTTP 서버에 요청합니다. - 이름 → 파일.
qwen3:0.6b같은 이름을 매니페스트로 풀어 실제 GGUF 블롭 경로를 찾습니다. 맥에서는~/.ollama/models아래에 있습니다. - 스케줄러.
server/sched.go가 이미 떠 있는 러너를 재사용할지 정합니다.needsReload()는 어댑터·프로젝터 경로와 러너 옵션(num_ctx,num_batch,num_gpu,use_mmap,num_thread등)을reflect.DeepEqual로 비교합니다. 하나라도 다르면 프로세스를 새로 띄웁니다. 메모리가 모자라면 다른 모델을 내립니다. - 프롬프트 렌더링. 대화 배열을 모델의 채팅 형식 문자열로 바꿉니다. 전용 렌더러가 있는 모델은 Go 에서 렌더링해
/completion을, 나머지는llama-server의 chat template 에 맡겨/v1/chat/completions를 부릅니다(소스 주석). - 자식 프로세스 기동. 러너가 없으면 빈 포트를 하나 잡아
llama-server를exec합니다. 넘기는 인자는 최소한입니다.--model,--port,--host 127.0.0.1, 그리고-c에NumCtx × numParallel,-np에 병렬 수. 주석대로 GPU 층 수(-ngl)·스레드 수(-t)·플래시 어텐션은 사용자가 따로 정하지 않으면llama-server가 자동으로 고릅니다. - 슬롯과 연속 배칭.
llama-server는 슬롯(-np) 단위로 요청을 받고, 연속 배칭(continuous batching)이 기본으로 켜져 있습니다. 슬롯마다 KV 캐시 구역을 가집니다. - 계산 그래프. 이번 배치의 토큰으로 ggml 계산 그래프를 만들고, 백엔드 스케줄러가 노드를 장치에 나눠 줍니다(아래 절).
- 커널 실행. Metal·CUDA·CPU 커널이 행렬곱을 돌리고 마지막 로짓에서 다음 토큰을 샘플링합니다.
- 스트리밍과 타이머. 토큰이 JSON 줄 단위로 클라이언트에 흐릅니다. 요청이 끝나면 스케줄러가 만료 타이머를 겁니다. 기본값은
envconfig/config.go의5 * time.Minute입니다. 그동안 다음 요청이 오면 3번에서 바로 재사용됩니다.
내부 동작 원리 2 — GGUF 를 "읽지 않고" 여는 법, mmap
모델 파일을 read() 로 힙에 복사하면 시작이 느리고 메모리도 두 벌(페이지 캐시 + 힙) 듭니다. llama.cpp 는 기본으로 mmap 을 씁니다. llama-server 의 --load-mode 기본값은 auto 이고, 설명은 "mmap, unless a device does not support it" 입니다.
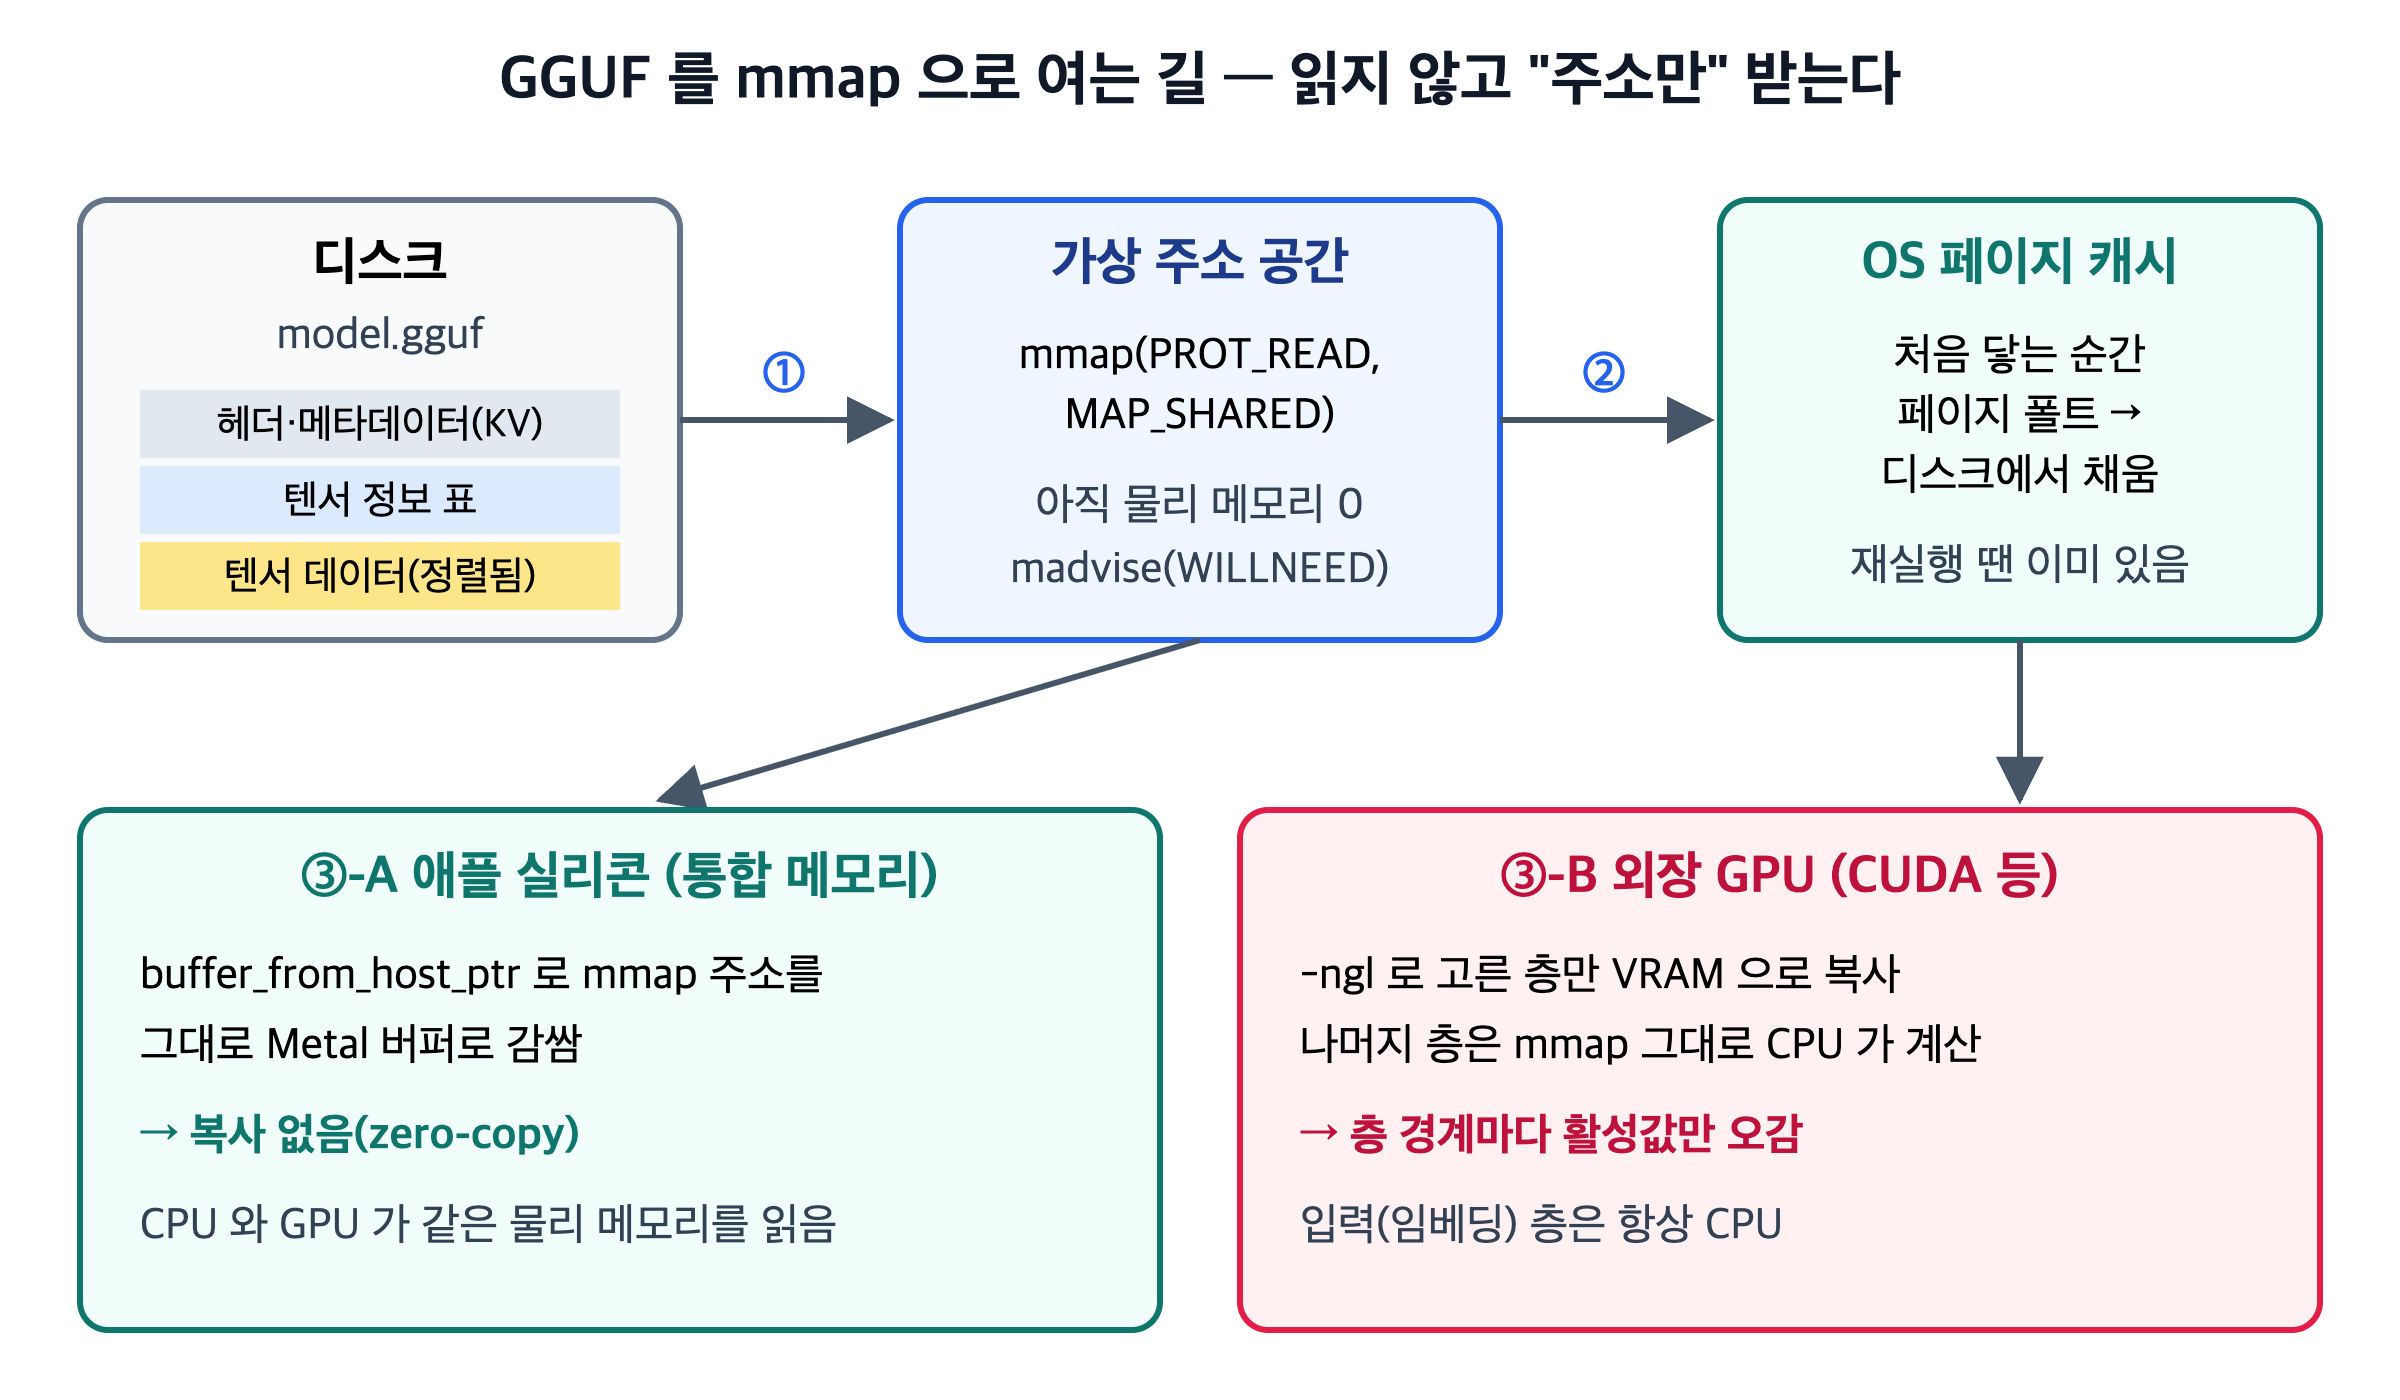
src/llama-mmap.cpp 의 POSIX 구현을 따라가면 이렇습니다.
mmap(NULL, file->size(), PROT_READ, MAP_SHARED, fd, 0)으로 파일 전체를 읽기 전용으로 매핑합니다. 이 호출은 주소 범위만 예약합니다. 물리 메모리는 아직 쓰지 않습니다.- 미리 읽기(prefetch)를 켜면
posix_madvise(..., POSIX_MADV_WILLNEED)로 커널에 "곧 읽을 테니 미리 올려 두라"고 알립니다. 리눅스에서는MAP_POPULATE플래그도 붙입니다. - 계산이 텐서 주소에 처음 닿으면 페이지 폴트가 나고, 커널이 그 페이지를 디스크에서 페이지 캐시로 읽어 옵니다. 같은 파일을 다시 열면 페이지 캐시에 남아 있는 부분은 디스크를 건너뜁니다. 두 번째 실행이 빠른 이유입니다.
GGUF 형식이 이 방식에 맞춰져 있습니다. ggml 의 GGUF 명세는 각 텐서 데이터의 오프셋을 정렬 단위(general.alignment, 적혀 있지 않으면 32바이트)의 배수로 두도록 정합니다. 로더(llama-model-loader.cpp)는 mmap 을 쓸 때 데이터 구역 오프셋이 정렬에 맞지 않으면 "cannot mmap" 오류를 냅니다. 텐서를 파일 오프셋 그대로 가리키기 때문입니다(소스 주석 "mmap places tensors at their file offsets").
애플 실리콘: mmap 주소를 그대로 GPU 버퍼로
맥에서 진짜 이득은 여기서 나옵니다. 애플 실리콘은 CPU 와 GPU 가 물리 메모리를 공유합니다(통합 메모리). src/llama-model.cpp 는 장치가 buffer_from_host_ptr 기능을 지원하면 mmap 된 영역을 ggml_backend_dev_buffer_from_host_ptr() 로 감싸 백엔드 버퍼로 씁니다. 소스 주석은 "this is important for metal with apple silicon" 이라고 적습니다. 파일 → 페이지 캐시 → GPU 가 읽는 메모리가 같은 페이지입니다. VRAM 으로 옮기는 복사가 없습니다.
외장 GPU 는 사정이 다릅니다. VRAM 은 별도 메모리라 GPU 에 맡긴 층의 가중치는 복사해야 합니다. 그래서 -ngl(GPU 에 올릴 층 수)이 생깁니다. 맡기지 않은 층은 mmap 된 그대로 CPU 가 계산합니다. 같은 파일의 다른 주석은 입력(임베딩) 층에 대해 "there is very little benefit to offloading the input layer, so always keep it on the CPU" 라고 적습니다.
내부 동작 원리 3 — ggml 계산 그래프와 백엔드 스케줄러
llama.cpp 는 배치마다 ggml 연산(행렬곱, RMSNorm, RoPE, 어텐션 …)을 노드로 하는 계산 그래프를 만들고, ggml_backend_sched 에 실행을 맡깁니다. ggml-backend.h 설명대로 스케줄러는 계산 버퍼를 할당하고, 텐서를 백엔드에 배정하고, 백엔드 사이 텐서를 복사합니다. 배정 기준은 두 가지입니다. 그 연산을 지원하는 백엔드인가, 가중치가 어느 장치에 있는가.
-ngl 은 뒤쪽 층부터 GPU 에 맡깁니다. llama-model.cpp 는 i_gpu_start = max(n_layer + 1 - n_gpu_layers, 0) 으로 경계를 잡고, 그보다 앞 층은 CPU 에 둡니다. -ngl 20 인 40층 모델이면 앞쪽은 CPU, 뒤쪽은 GPU 에서 계산합니다. 장치가 바뀌는 경계에서는 가중치가 아니라 활성값(토큰 수 × hidden 크기 텐서)만 복사합니다. 가중치에 비해 아주 작습니다. CPU+GPU 하이브리드가 가능한 원리가 이것입니다. 다만 전체 속도는 느린 쪽(CPU 층)이 정합니다.
내부 동작 원리 4 — 프롬프트 처리와 토큰 생성은 병목이 다르다
같은 모델, 같은 가중치인데 두 단계의 성격이 정반대입니다.
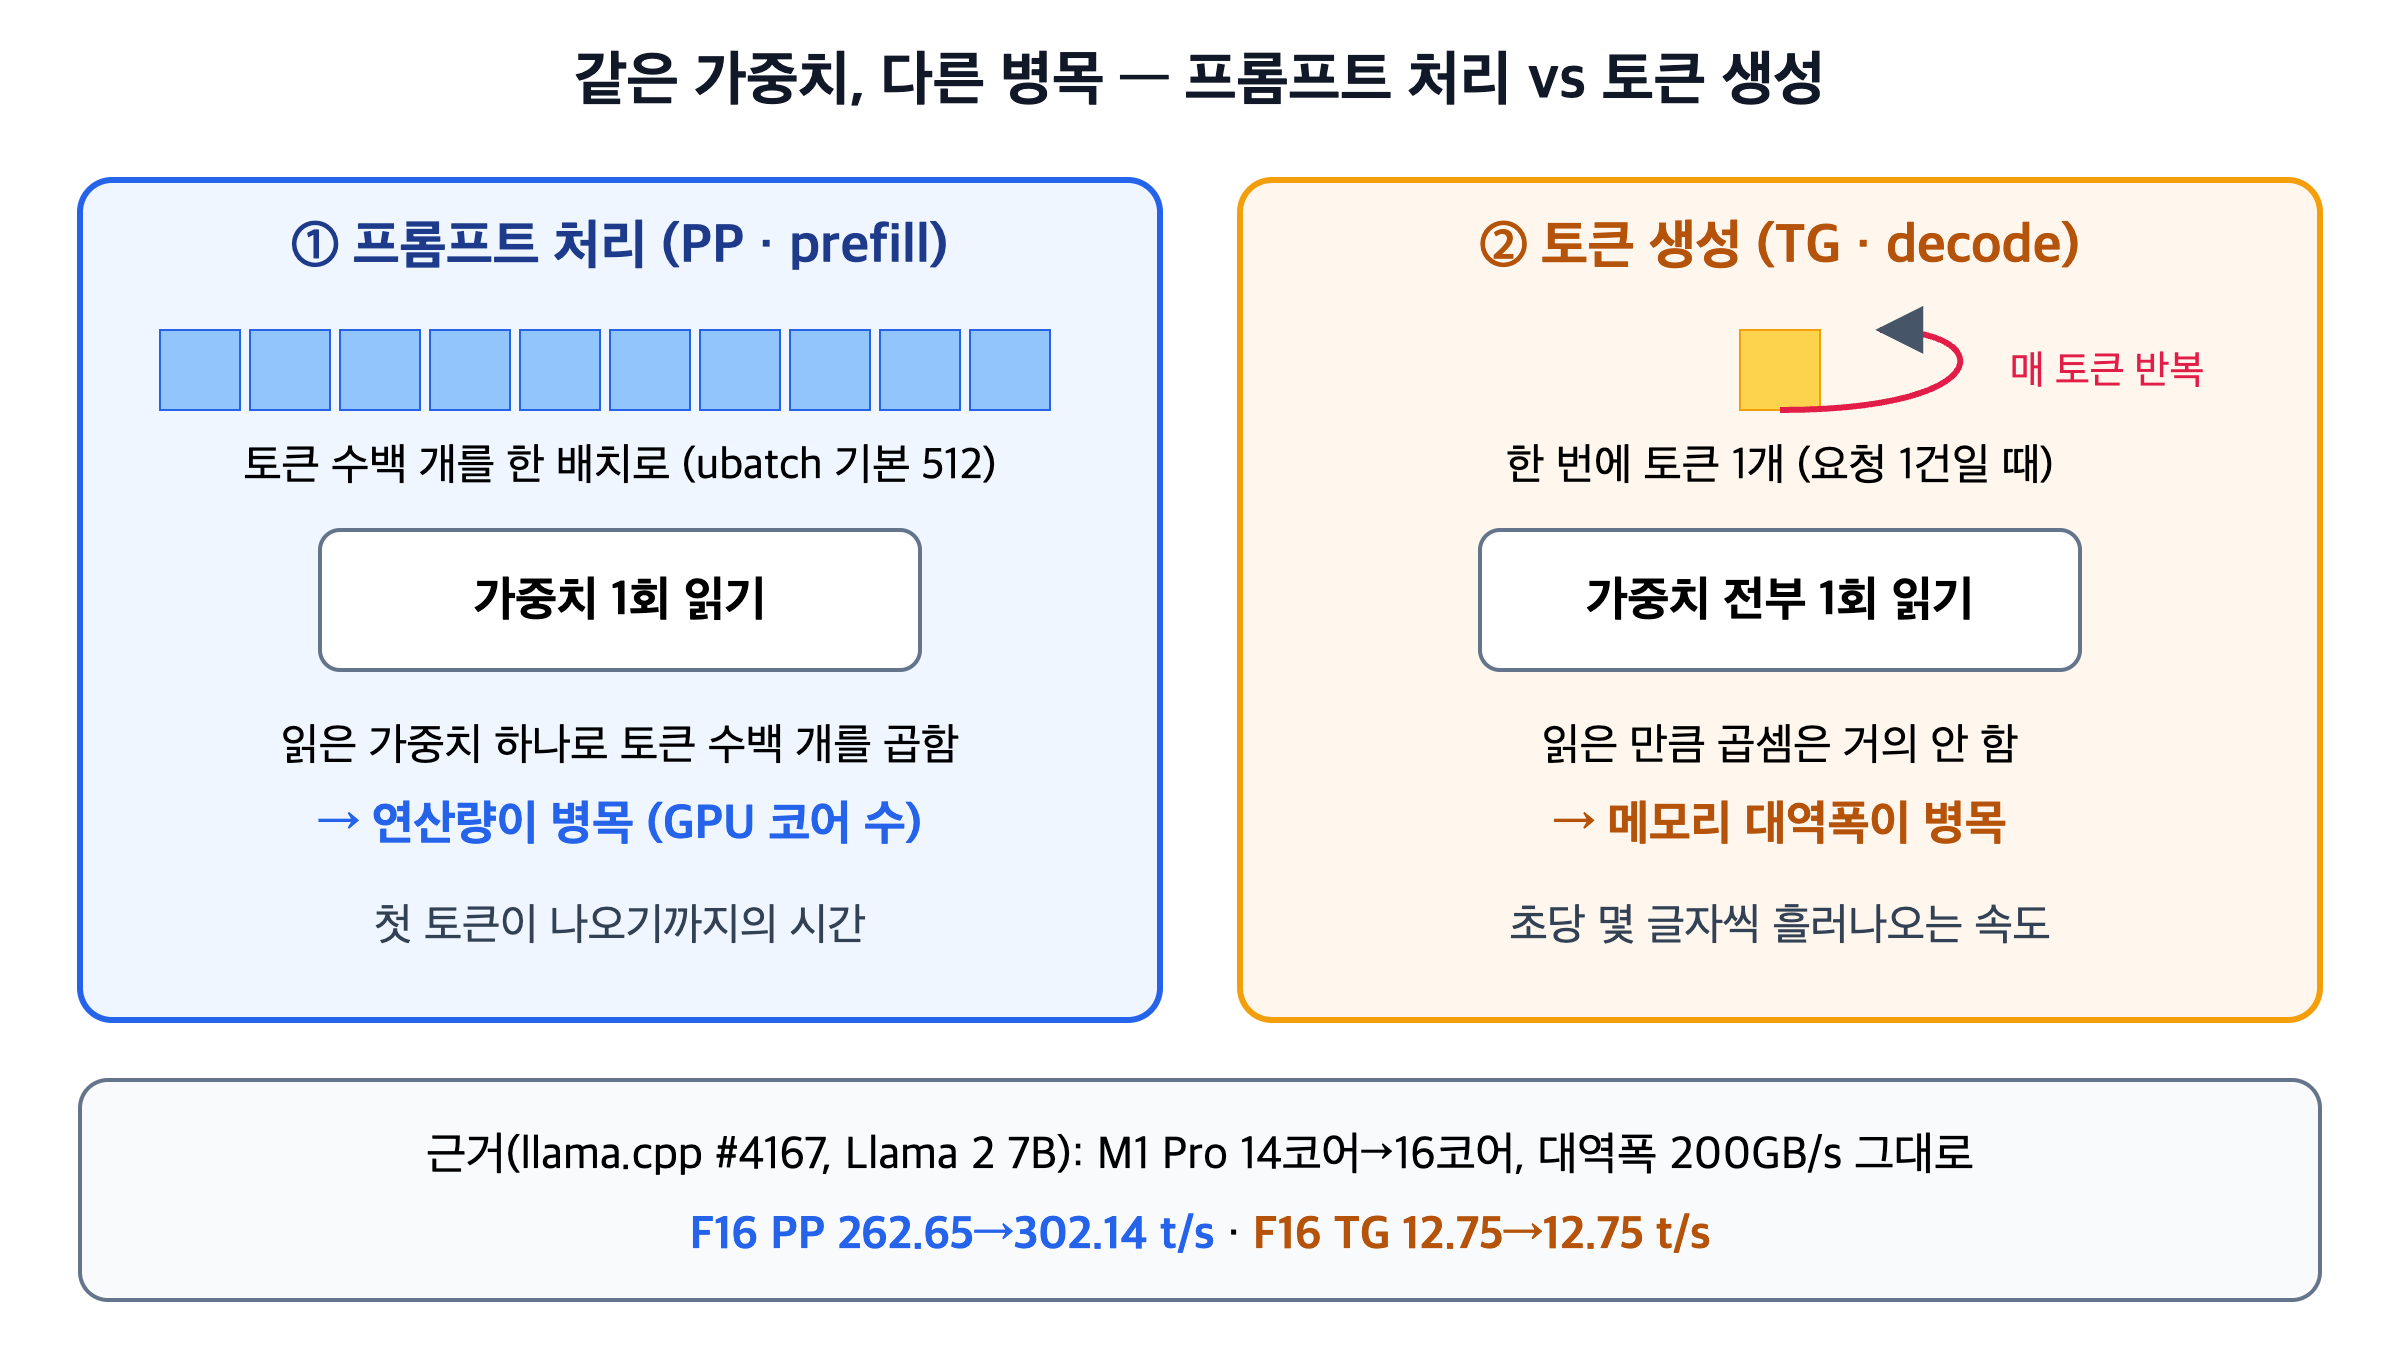
프롬프트 처리(PP, prefill). 입력 토큰 수백 개를 한 배치로 넣습니다. llama-server 의 물리 배치(-ub) 기본값은 512 입니다. 가중치 행렬을 한 번 읽어 와서 토큰 512개와 곱합니다. 읽은 바이트당 곱셈이 많습니다. 그래서 연산 장치 수가 속도를 정합니다.
토큰 생성(TG, decode). 요청이 한 건이면 한 번에 토큰 하나를 만듭니다. 그 토큰 하나를 위해 모든 층의 가중치를 메모리에서 한 번씩 다 읽어야 합니다. 곱셈은 벡터 하나분뿐입니다. 연산 장치는 대부분 데이터를 기다립니다. 메모리 대역폭이 속도를 정합니다.
말로 쓰면 토큰 생성 속도의 상한은 대략 이렇습니다.
초당 생성 토큰 수 ≲ 메모리 대역폭 ÷ 토큰 하나에 읽어야 하는 바이트(≈ 모델 가중치 크기)
대역폭이 두 배거나 파일이 절반이면 상한이 두 배입니다. 실제 값은 KV 캐시 읽기 등으로 이보다 낮습니다.
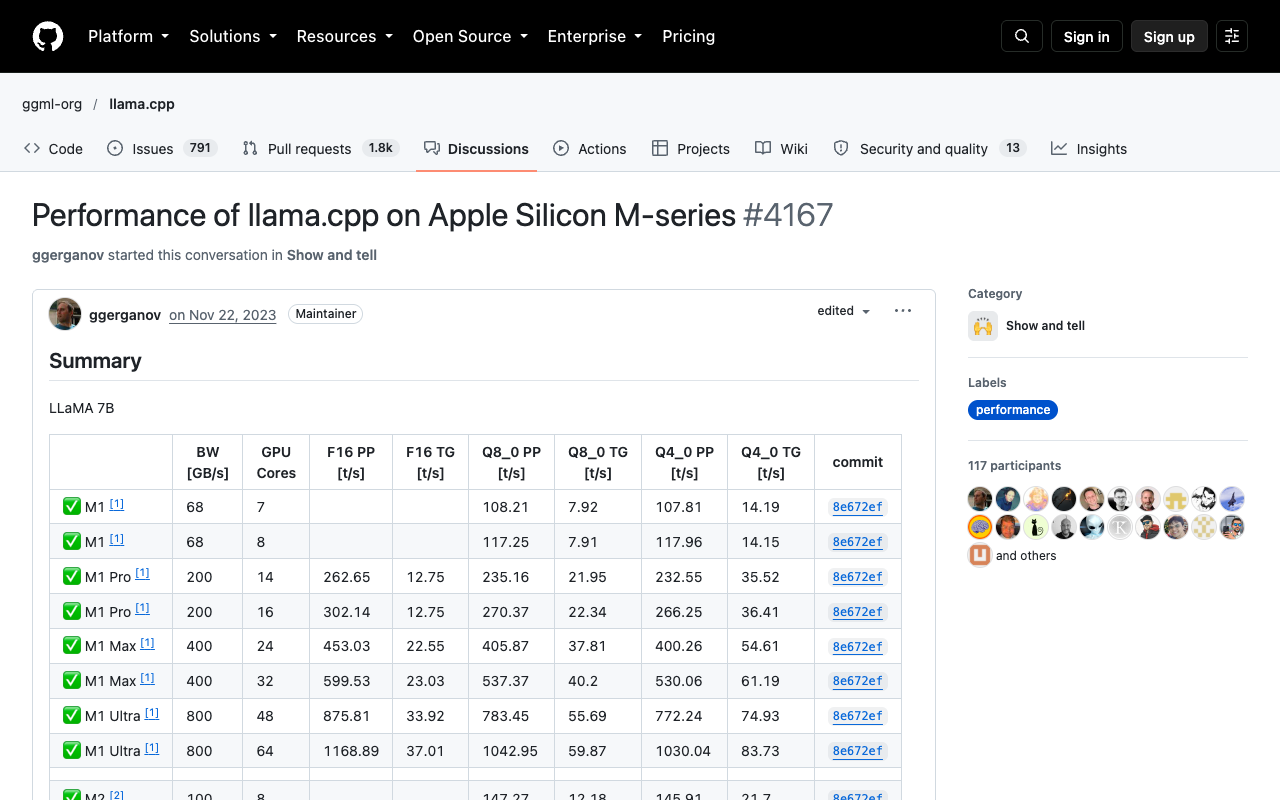
llama.cpp 메인테이너가 모아 둔 애플 실리콘 측정(Discussion #4167, Llama 2 7B, llama-bench -p 512 -n 128 -ngl 99)이 이 구도를 그대로 보여 줍니다.
| 칩 | 대역폭(GB/s) | GPU 코어 | F16 PP (t/s) | F16 TG (t/s) | Q4_0 PP (t/s) | Q4_0 TG (t/s) |
|---|---|---|---|---|---|---|
| M1 Pro | 200 | 14 | 262.65 | 12.75 | 232.55 | 35.52 |
| M1 Pro | 200 | 16 | 302.14 | 12.75 | 266.25 | 36.41 |
| M1 Max | 400 | 32 | 599.53 | 23.03 | 530.06 | 61.19 |
| M2 Ultra | 800 | 76 | 1401.85 | 41.02 | 1238.48 | 94.27 |
| M4 Max | 546 | 40 | 922.83 | 31.64 | 885.68 | 83.06 |
- M1 Pro 14코어 vs 16코어. 대역폭은 200GB/s 로 같습니다. GPU 코어가 늘자 F16 PP 는 262.65 → 302.14 로 올랐습니다. F16 TG 는 12.75 → 12.75, 그대로입니다.
- 같은 칩에서 F16 → Q4_0. M2 Ultra 의 TG 는 41.02 → 94.27 로 두 배 넘게 뛰었습니다. 읽을 바이트가 줄었기 때문입니다. 반면 PP 는 1401.85 → 1238.48 로 오르지 않았습니다.
양자화는 메모리에 넣기 위한 수단만이 아닙니다. 토큰 생성 속도도 올립니다.
KV 캐시가 차지하는 몫
가중치 다음으로 메모리를 먹는 것은 이미 처리한 토큰의 K·V 벡터를 층마다 저장한 KV 캐시입니다.
KV 캐시 바이트 = 2(K와 V) × 층 수 × KV 헤드 수 × 헤드 차원 × 원소 바이트 × 컨텍스트 길이 × 병렬 수
Qwen3-8B 의 config.json 은 36층, KV 헤드 8개, 헤드 차원 128 입니다. f16(2바이트)이면 토큰 하나에 2 × 36 × 8 × 128 × 2 = 147,456바이트, 144KiB 입니다. 컨텍스트 32,768 이면 4.5GiB, 병렬 4 면 18GiB 입니다. 그래서 llama-server 는 -ctk/-ctv 로 KV 캐시를 q8_0·q4_0 등으로 줄일 수 있고, Ollama 는 OLLAMA_KV_CACHE_TYPE 을 받아 그대로 넘깁니다. Ollama FAQ 는 이 양자화가 플래시 어텐션이 켜져 있을 때 동작한다고 적습니다.
직접 해 보기
1) mmap 이 "게으르게" 읽는 모습 보기
라이브러리 없이 파이썬 표준 모듈만 씁니다. 512MiB 짜리 가짜 가중치 파일을 매핑하고, 페이지 폴트 수를 셉니다.
import mmap, os, resource, time

PATH = "fake_model.bin"
SIZE = 512 * 1024 * 1024            # 512 MiB 짜리 가짜 가중치 파일

if not os.path.exists(PATH):
    with open(PATH, "wb") as f:
        f.truncate(SIZE)            # 내용은 0 이지만 크기는 512 MiB

def faults():
    r = resource.getrusage(resource.RUSAGE_SELF)
    return r.ru_minflt + r.ru_majflt

with open(PATH, "rb") as f:
    t = time.perf_counter()
    m = mmap.mmap(f.fileno(), 0, access=mmap.ACCESS_READ)
    print(f"mmap 호출: {(time.perf_counter() - t) * 1e3:.2f} ms")

    before = faults()
    _ = m[0:4096]                   # 첫 페이지만 읽기
    print("4 KiB 읽은 뒤 페이지 폴트:", faults() - before)

    before = faults()
    page = mmap.PAGESIZE
    for off in range(0, SIZE, page):  # 파일 전체를 한 바이트씩 건드림
        m[off]
    print("전체를 훑은 뒤 페이지 폴트:", faults() - before)
    m.close()
애플 실리콘 맥에서 돌린 출력입니다(기기마다 다릅니다).
mmap 호출: 7.05 ms
4 KiB 읽은 뒤 페이지 폴트: 1
전체를 훑은 뒤 페이지 폴트: 32815
mmap 호출은 파일 크기와 상관없이 바로 끝나고, 폴트는 실제로 닿은 페이지 수만큼 납니다. 512MiB ÷ 16KiB(이 맥의 페이지 크기) = 32,768 이니 페이지마다 한 번씩입니다. 모델을 "여는" 순간과 "읽는" 순간이 다른 이유입니다.
2) KV 캐시 메모리 계산기
# Qwen3-8B config.json 값
n_layer, n_kv_head, head_dim = 36, 8, 128
bytes_per = {"f16": 2, "q8_0": 34 / 32}   # q8_0: 32개 값마다 1바이트×32 + f16 스케일 2바이트

def kv_bytes(n_ctx, n_parallel=1, dtype="f16"):
    per_token = 2 * n_layer * n_kv_head * head_dim * bytes_per[dtype]  # K 와 V 두 벌
    return per_token * n_ctx * n_parallel

for ctx, par, dt in [(4096, 1, "f16"), (32768, 1, "f16"), (32768, 4, "f16"), (32768, 4, "q8_0")]:
    print(f"ctx={ctx:>6} parallel={par} {dt:5}: {kv_bytes(ctx, par, dt) / 2**30:5.2f} GiB")
ctx=  4096 parallel=1 f16  :  0.56 GiB
ctx= 32768 parallel=1 f16  :  4.50 GiB
ctx= 32768 parallel=4 f16  : 18.00 GiB
ctx= 32768 parallel=4 q8_0 :  9.56 GiB
3) Ollama API 로 PP·TG 속도 따로 재기
Ollama 의 /api/generate 응답에는 load_duration, prompt_eval_count, prompt_eval_duration, eval_count, eval_duration 이 나노초 단위로 들어 있습니다. API 문서는 생성 속도를 eval_count / eval_duration × 10^9 로 구하라고 적습니다. ollama pull qwen3:0.6b 후 실행합니다.
import json, urllib.request

def generate(prompt, model="qwen3:0.6b", **options):
    body = json.dumps({"model": model, "prompt": prompt,
                       "stream": False, "think": False, "options": options}).encode()
    req = urllib.request.Request("http://localhost:11434/api/generate", body,
                                 {"Content-Type": "application/json"})
    with urllib.request.urlopen(req) as r:
        return json.load(r)

ns = 1e9
for i, ctx in enumerate([4096, 4096, 8192]):
    r = generate("트랜스포머를 한 문장으로 설명해 줘.", num_ctx=ctx)
    pp_n, pp_t = r.get("prompt_eval_count", 0), r.get("prompt_eval_duration", 0)
    print(f"[{i + 1}회차 num_ctx={ctx}] 로드 {r['load_duration'] / ns:.2f}s | "
          f"프롬프트 {pp_n}토큰 {pp_n / max(pp_t, 1) * ns:.0f} tok/s | "
          f"생성 {r['eval_count']}토큰 {r['eval_count'] / r['eval_duration'] * ns:.1f} tok/s")
1회차는 자식 프로세스 기동과 가중치 적재로 로드 시간이 깁니다. 2회차는 같은 옵션이라 러너를 재사용해 거의 0 입니다. 3회차는 num_ctx 만 바꿨는데 다시 깁니다. needsReload() 가 옵션 차이를 보고 llama-server 를 새로 띄웠기 때문입니다. 프롬프트를 길게 바꿔 보면 프롬프트 tok/s 가 생성 tok/s 보다 크게 나옵니다. PP 와 TG 의 병목 차이가 숫자로 보입니다. 같은 프롬프트를 반복하면 prompt_eval_cached_count 만큼 캐시에서 읽어 prompt_eval_count 가 줄어들 수 있습니다.
비교 표
실행 방법별 차이
| 항목 | llama cli |
llama serve / llama-server |
Ollama |
|---|---|---|---|
| 형태 | 대화형 단일 프로세스 | HTTP 서버(OpenAI 호환 API, 웹 UI) | Go 서버 + llama-server 자식 프로세스 |
| 모델 지정 | -m 파일 또는 -hf 저장소 |
같음 | 이름(qwen3:0.6b) → 블롭 |
| 동시 요청 | 1 | 슬롯 -np(기본 자동) + 연속 배칭(기본 켬) |
OLLAMA_NUM_PARALLEL(기본 1)을 -np 로 전달 |
| 모델 교체 | 재실행 | 재실행 | 스케줄러가 자동 로드·언로드, 동시 모델 수 제한 |
| 메모리에서 내리기 | 프로세스 종료 | 프로세스 종료 | keep_alive 기본 5분 후 자동 |
| 손볼 수 있는 폭 | 모든 플래그 | 모든 플래그 | 옵션 일부만 노출, 나머지는 자동 |
같은 설정, 두 도구에서의 이름
| 의미 | llama.cpp 플래그 (기본값) | Ollama 이름 |
|---|---|---|
| 컨텍스트 길이 | -c (0 = 모델 값) |
num_ctx, OLLAMA_CONTEXT_LENGTH (VRAM 따라 4k·32k·256k) |
| GPU 에 올릴 층 수 | -ngl (auto) |
num_gpu (미지정 시 자동) |
| CPU 스레드 | -t (-1 = 자동) |
num_thread |
| 병렬 슬롯 | -np (-1 = 자동) |
OLLAMA_NUM_PARALLEL (1) |
| KV 캐시 자료형 | -ctk·-ctv (f16) |
OLLAMA_KV_CACHE_TYPE (f16) |
| 플래시 어텐션 | -fa (auto) |
OLLAMA_FLASH_ATTENTION (지원 시 자동) |
| 적재 방식 | --load-mode (auto = mmap) |
use_mmap |
| 논리·물리 배치 | -b 2048 · -ub 512 |
num_batch (주면 -b·-ub 둘 다에 같은 값) |
Ollama 쪽 값은 envconfig/config.go, docs/context-length.mdx, FAQ 기준입니다.
흔한 오해와 실수
"GPU 코어 많은 칩을 사면 답이 빨리 나온다." 반만 맞습니다. 첫 토큰까지의 시간(PP)은 빨라집니다. 글자가 흘러나오는 속도(TG)는 메모리 대역폭이 정합니다. 장비를 고를 때는 대역폭과 메모리 용량을 먼저 봅니다.
"요청마다 num_ctx 를 바꿔 보내도 괜찮다." Ollama 에서는 비쌉니다. num_ctx 는 llama-server 기동 인자 -c 이고, 옵션이 바뀌면 스케줄러가 프로세스를 다시 띄웁니다. 서로 다른 num_ctx 를 보내는 두 클라이언트가 번갈아 부르면 매번 재로드입니다. 값은 서버의 OLLAMA_CONTEXT_LENGTH 로 정하고 요청에서는 빼는 편이 안전합니다.
"OLLAMA_NUM_PARALLEL 만 올리면 처리량이 늘어난다." 메모리가 곱해집니다. Ollama 는 -c 에 num_ctx × 병렬 수 를 넘깁니다. FAQ 도 필요한 RAM 이 OLLAMA_NUM_PARALLEL × OLLAMA_CONTEXT_LENGTH 에 비례한다고 적습니다. Qwen3-8B·32k·병렬 4 면 KV 캐시만 18GiB 입니다. 메모리가 모자라면 층 일부가 CPU 로 밀려 오히려 느려집니다. ollama ps 의 PROCESSOR 열이 100% GPU 가 아니면 이 상황을 의심합니다.
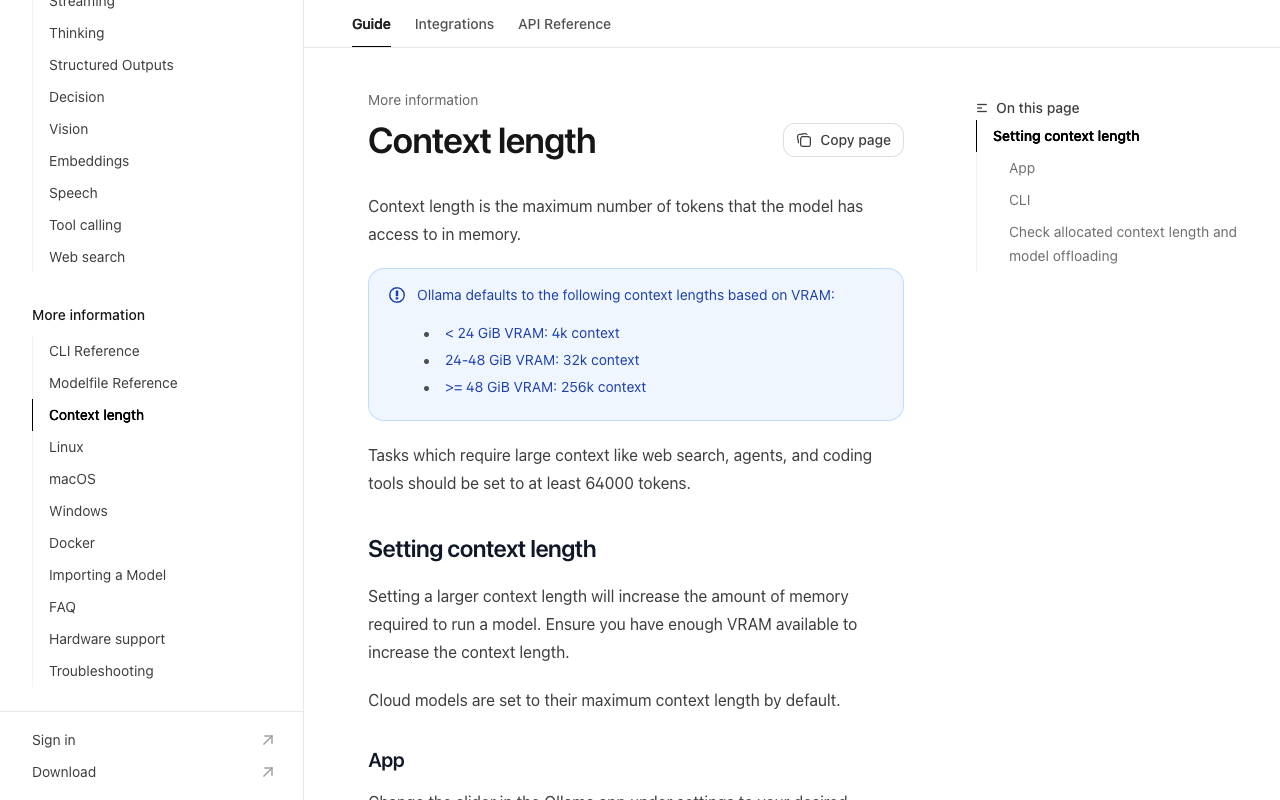
"기본 컨텍스트는 4096 이다." 문서끼리 어긋나 있습니다. FAQ 는 아직 "By default, Ollama uses a context window size of 4096 tokens" 라고 적지만, Context length 문서와 envconfig/config.go 의 설명은 VRAM 24GiB 미만 4k, 24~48GiB 32k, 48GiB 이상 256k 입니다. 이 문서는 에이전트·코딩 도구에 최소 64000 토큰을 권합니다. 실제 값은 ollama ps 의 CONTEXT 열에서 확인합니다.
"mmap 이니까 메모리를 적게 쓴다." 시작이 빠르고 복사가 없을 뿐, 추론할 때 필요한 양은 같습니다. 토큰 하나마다 모든 층을 읽으므로 결국 전 페이지가 메모리에 올라옵니다. RAM 이 모자라면 커널이 페이지를 버렸다가 다음 토큰에서 디스크로 다시 읽으므로, 생성이 디스크 속도로 떨어집니다. 답은 더 작은 양자화입니다. --load-mode mlock 은 페이지가 밀려나는 것을 막을 뿐 메모리를 만들어 주지 않습니다.
"스레드는 많을수록 좋다." llama.cpp 성능 문서는 -t 를 너무 크게 잡지 말라고 강조합니다. 물리 코어 수에 맞추고, 의심되면 1 부터 두 배씩 늘려 보라고 합니다. 문서의 예시(A6000 + 7 물리 코어, 30B Q4_0)에서는 -t 7 -ngl 2000000 이 8.7 t/s, -t 4 -ngl 2000000 이 9.1 t/s 로 스레드가 적은 쪽이 빨랐습니다.
정리
- Ollama 는 이름·스케줄링·HTTP 를 맡는 Go 서버이고, 실제 계산은 자식 프로세스로 띄운 llama.cpp
llama-server가 ggml 그래프로 합니다. 옵션이 바뀌면 그 프로세스가 다시 뜹니다. - GGUF 는 정렬된 텐서 덕분에 mmap 으로 복사 없이 열리고, 애플 실리콘에서는 그 주소가 그대로 Metal 버퍼가 됩니다. 외장 GPU 는
-ngl만큼만 VRAM 에 복사하고 경계에서 활성값만 주고받습니다. - 프롬프트 처리는 연산량, 토큰 생성은 메모리 대역폭이 병목입니다. 그래서 대역폭이 높은 장비와 작은 양자화가 생성 속도를 올리고, 컨텍스트 × 병렬 수가 KV 캐시 메모리를 정합니다.
smith lab 에서 이어서 보기
smith lab(smithlab.co.kr)은 설치·로그인 없이 브라우저에서 바로 쓰는 개발자 도구와 실무 글을 모아 둔 곳입니다. 개발 글 모음도 함께 보세요.
참고 자료
- llama.cpp README
- llama.cpp llama-server README — 플래그와 기본값
- llama.cpp src/llama-mmap.cpp — mmap·madvise 구현
- llama.cpp src/llama-model.cpp — buffer_from_host_ptr·층 배정
- llama.cpp src/llama-model-loader.cpp — GGUF 로더
- ggml-backend.h — 백엔드 스케줄러 설명
- GGUF 명세
- llama.cpp 토큰 생성 성능 문제 해결 문서
- Performance of llama.cpp on Apple Silicon M-series (Discussion #4167)
- Ollama llm/llama_server.go — llama-server 자식 프로세스
- Ollama server/sched.go — 스케줄러·needsReload
- Ollama envconfig/config.go — 환경 변수 기본값
- Ollama FAQ
- Ollama Context length
- Ollama API — Generate
- Qwen3-8B config.json
'[Ai Developer]' 카테고리의 다른 글
| LLM 추론 서버 원리: KV 캐시와 Continuous Batching (0) | 2026.10.27 |
|---|---|
| AI 코딩 에이전트 원리 — 계획·도구·검증 루프와 SWE-agent (0) | 2026.10.27 |
| 로컬 LLM 실행 원리 — llama.cpp·Ollama 내부 흐름 (0) | 2026.10.26 |
| LLM 평가 원리 — 벤치마크·LLM-as-a-judge 믿어도 되나 (0) | 2026.10.26 |
| 프롬프트 인젝션과 가드레일 원리 — LLM 앱 보안 공격 경로 (0) | 2026.10.26 |


