자바 21에서 가상 스레드(virtual thread)가 정식 기능이 됐습니다. "스레드를 백만 개 만들어도 된다"는 말이 함께 돌았습니다. 그런데 가상 스레드도 java.lang.Thread 입니다. 같은 클래스인데 왜 하나는 무겁고 하나는 가벼울까요. 답은 스레드의 스택이 어디에 있고, 누가 그 스레드를 CPU에 올리느냐에 있습니다. 이 글은 JEP 444와 OpenJDK 소스(VirtualThread.java, Poller.java)를 따라가며 가상 스레드가 멈췄다가 다시 도는 과정을 한 단계씩 풉니다.
■ 1. 가상 스레드가 푸는 문제: 스레드 한 개 = OS 스레드 한 개
기존 자바 스레드는 플랫폼 스레드입니다. new Thread() 하나가 OS 스레드 하나를 감쌉니다. 스레드의 일생 동안 OS 스레드를 계속 붙잡습니다. 그래서 비쌉니다.
- 스택 메모리: OS 스레드마다 고정 크기의 스택을 예약합니다. java 명령 문서에 따르면 -Xss 기본값은 Linux/x64 에서 1024KB, Linux/Aarch64 와 macOS/Aarch64 에서 2048KB 입니다.
- 스케줄링: 언제 어느 코어에서 돌지는 커널이 정합니다. 문맥 전환에 커널이 끼어듭니다.
- 개수 제한: 그래서 스레드를 몇백 개 단위로 풀(pool)에 담아 돌려 씁니다.
문제는 웹 서버의 기본 모델이 요청 하나에 스레드 하나(thread-per-request) 라는 점입니다. 코드가 읽기 쉽고 디버깅도 쉽습니다. 하지만 요청 처리 시간의 대부분은 DB·외부 API 응답을 기다리는 시간입니다. 기다리는 동안에도 스레드는 OS 스레드와 스택을 붙잡고 있습니다.
JEP 444는 이것을 리틀의 법칙(Little's Law)으로 설명합니다. 동시에 처리 중인 요청 수 = 처리량 × 지연 시간입니다. JEP 의 예를 그대로 옮기면, 요청 하나가 50ms 걸릴 때 동시 요청 10개면 초당 200건을 처리합니다. 초당 2,000건으로 올리려면 동시 요청이 100개 필요합니다. thread-per-request 에서는 처리량을 올리려면 스레드 수를 같이 올려야 합니다. 그런데 OS 스레드는 그만큼 늘릴 수 없습니다.
그동안의 우회로는 비동기 프로그래밍이었습니다. CompletableFuture, 리액티브 스트림처럼 기다리는 동안 스레드를 반납하는 방식입니다. 처리량은 오르지만 코드가 콜백 사슬로 쪼개집니다. 스택 트레이스가 끊기고, 디버거로 한 요청을 따라가기 어렵습니다.
가상 스레드는 이 둘을 합칩니다. 코드는 동기식 그대로 쓰고, 기다리는 순간에는 OS 스레드를 내려놓습니다. JEP 444의 표현으로는 가상 스레드는 "코드의 전체 수명 동안 OS 스레드를 붙잡지 않는" 스레드입니다.
■ 2. 내부 동작 원리
▶ 2-1. 등장인물 넷
구성 요소 | 정체 | 소스 위치
------------------------------------
가상 스레드 | Thread 의 하위 클래스. 상태(state)와 컨티뉴에이션을 가진 자바 객체 | java.lang.VirtualThread
컨티뉴에이션 | 실행을 멈췄다가 그 자리부터 다시 이어 갈 수 있는 코드 조각 | jdk.internal.vm.Continuation
캐리어 스레드 | 가상 스레드를 실제로 실행하는 플랫폼 스레드 | ForkJoinPool 의 워커(CarrierThread)
스케줄러 | 실행할 가상 스레드를 캐리어에 배분 | 전용 ForkJoinPool (FIFO 모드)
핵심은 M:N 스케줄링입니다. M개의 가상 스레드를 N개의 캐리어(OS 스레드)에 나눠 올립니다. JEP 444는 이 동작을 마운트(mount) 라고 부릅니다. 가상 스레드를 캐리어 위에 올리면 마운트, 내리면 언마운트입니다.
[이미지 01] 01-mn-scheduling.png
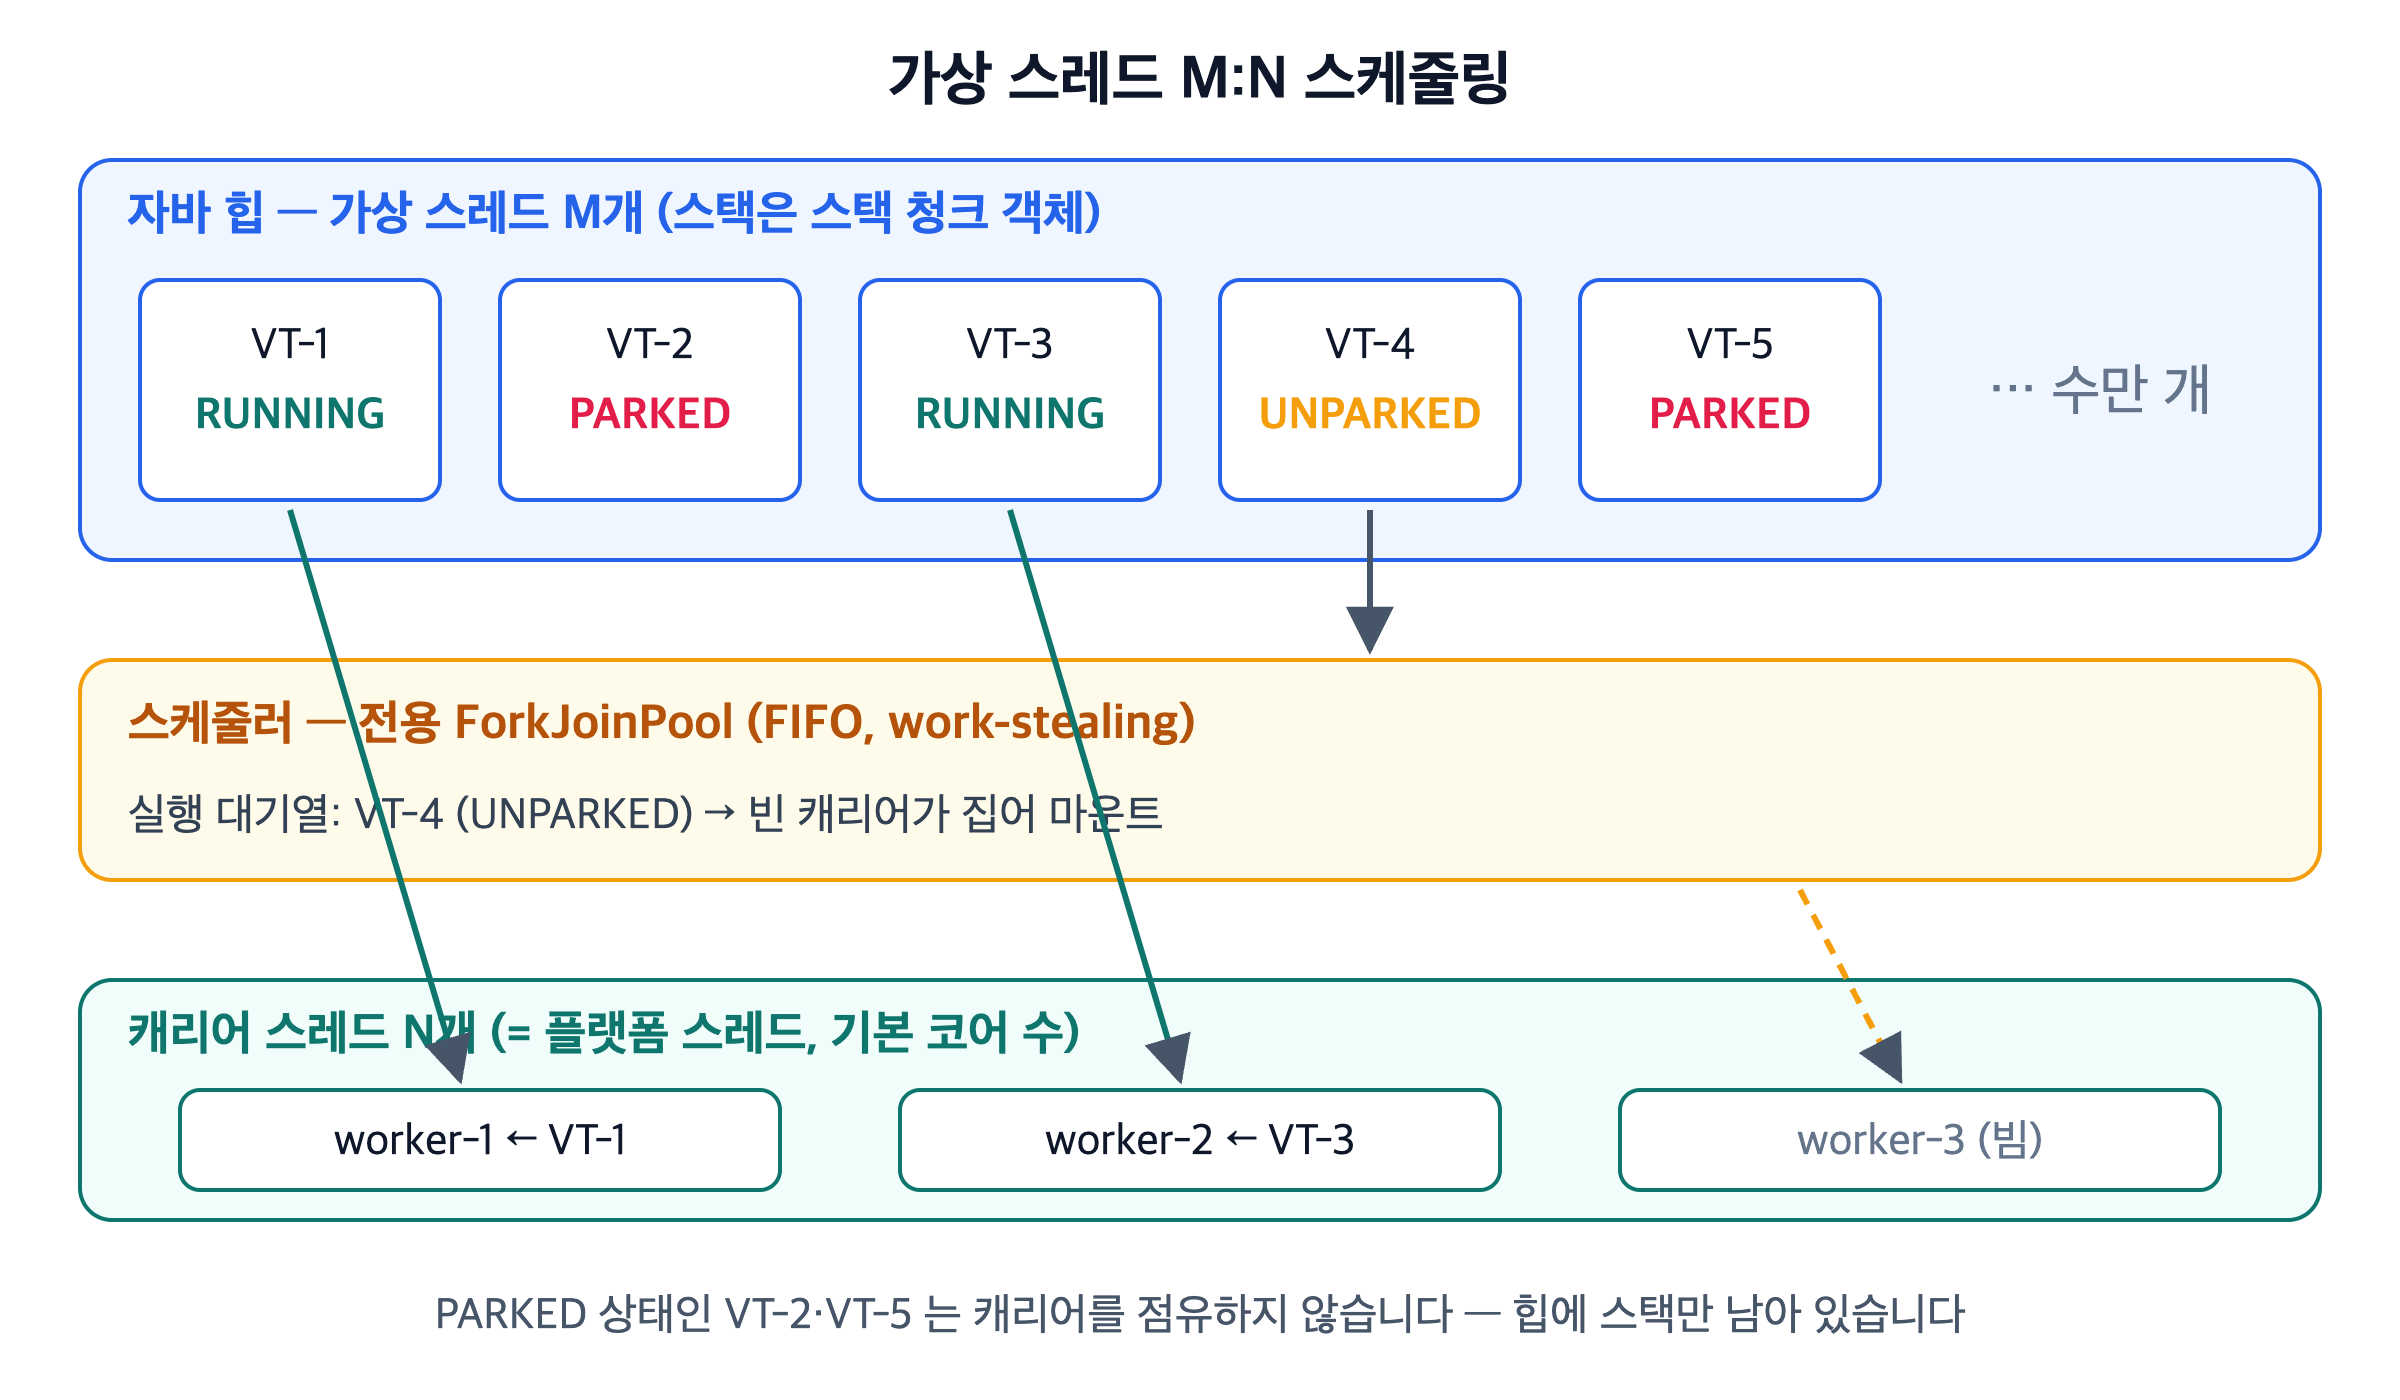
(가상 스레드 M:N 구조 — 힙의 가상 스레드들이 소수의 캐리어 스레드에 마운트됩니다)
▶ 2-2. 스택은 힙에 있습니다
플랫폼 스레드의 스택은 OS 가 잡아 준 연속된 메모리입니다. 가상 스레드의 스택은 다릅니다. JEP 444 원문은 이렇게 적습니다. "가상 스레드의 스택은 자바의 가비지 컬렉션 대상 힙에 스택 청크 객체로 저장된다." 그리고 이 스택은 필요한 만큼 늘었다 줄었다 합니다.
이 한 줄이 "가볍다"의 대부분을 설명합니다.
- 스레드를 만들 때 고정 크기 스택을 미리 예약하지 않습니다. 호출 깊이만큼만 씁니다.
- 생성은 자바 객체 몇 개를 만드는 일입니다. 시스템 콜이 없습니다.
- 끝난 가상 스레드는 다른 객체처럼 GC 가 회수합니다.
▶ 2-3. 실행 한 번의 흐름: 마운트 → 실행 → 언마운트
VirtualThread 의 생성자는 두 가지를 준비합니다. cont = new VThreadContinuation(this, task) 로 사용자 작업을 컨티뉴에이션에 감싸고, runContinuation 이라는 Runnable 을 만듭니다. 스케줄러에 제출되는 것은 이 runContinuation 입니다.
캐리어가 이 작업을 집으면 runContinuation() 이 돕니다. 순서는 이렇습니다.
1. 상태를 실행 가능 상태(STARTED, UNPARKED, YIELDED 등)에서 RUNNING 으로 CAS 합니다.
2. mount() — 캐리어의 carrierThread 필드를 채우고, carrier.setCurrentThread(this) 를 호출합니다. 이때부터 Thread.currentThread() 는 캐리어가 아니라 가상 스레드를 돌려줍니다.
3. cont.run() — 컨티뉴에이션을 실행합니다. 처음이면 작업의 첫 줄부터, 재개라면 멈췄던 자리부터 이어 갑니다.
4. 컨티뉴에이션이 끝나거나 양보(yield)하면 unmount() — currentThread 를 캐리어로 되돌립니다.
5. 끝났으면 afterDone(), 양보했으면 afterYield() 로 다음 상태를 정합니다.
▶ 2-4. 블로킹 I/O 를 만나면 무슨 일이 생기나
가상 스레드의 진짜 장면은 블로킹 호출입니다. 가상 스레드에서 소켓 read() 를 부르면 이렇게 흐릅니다.
[이미지 02] 02-park-unpark-flow.p
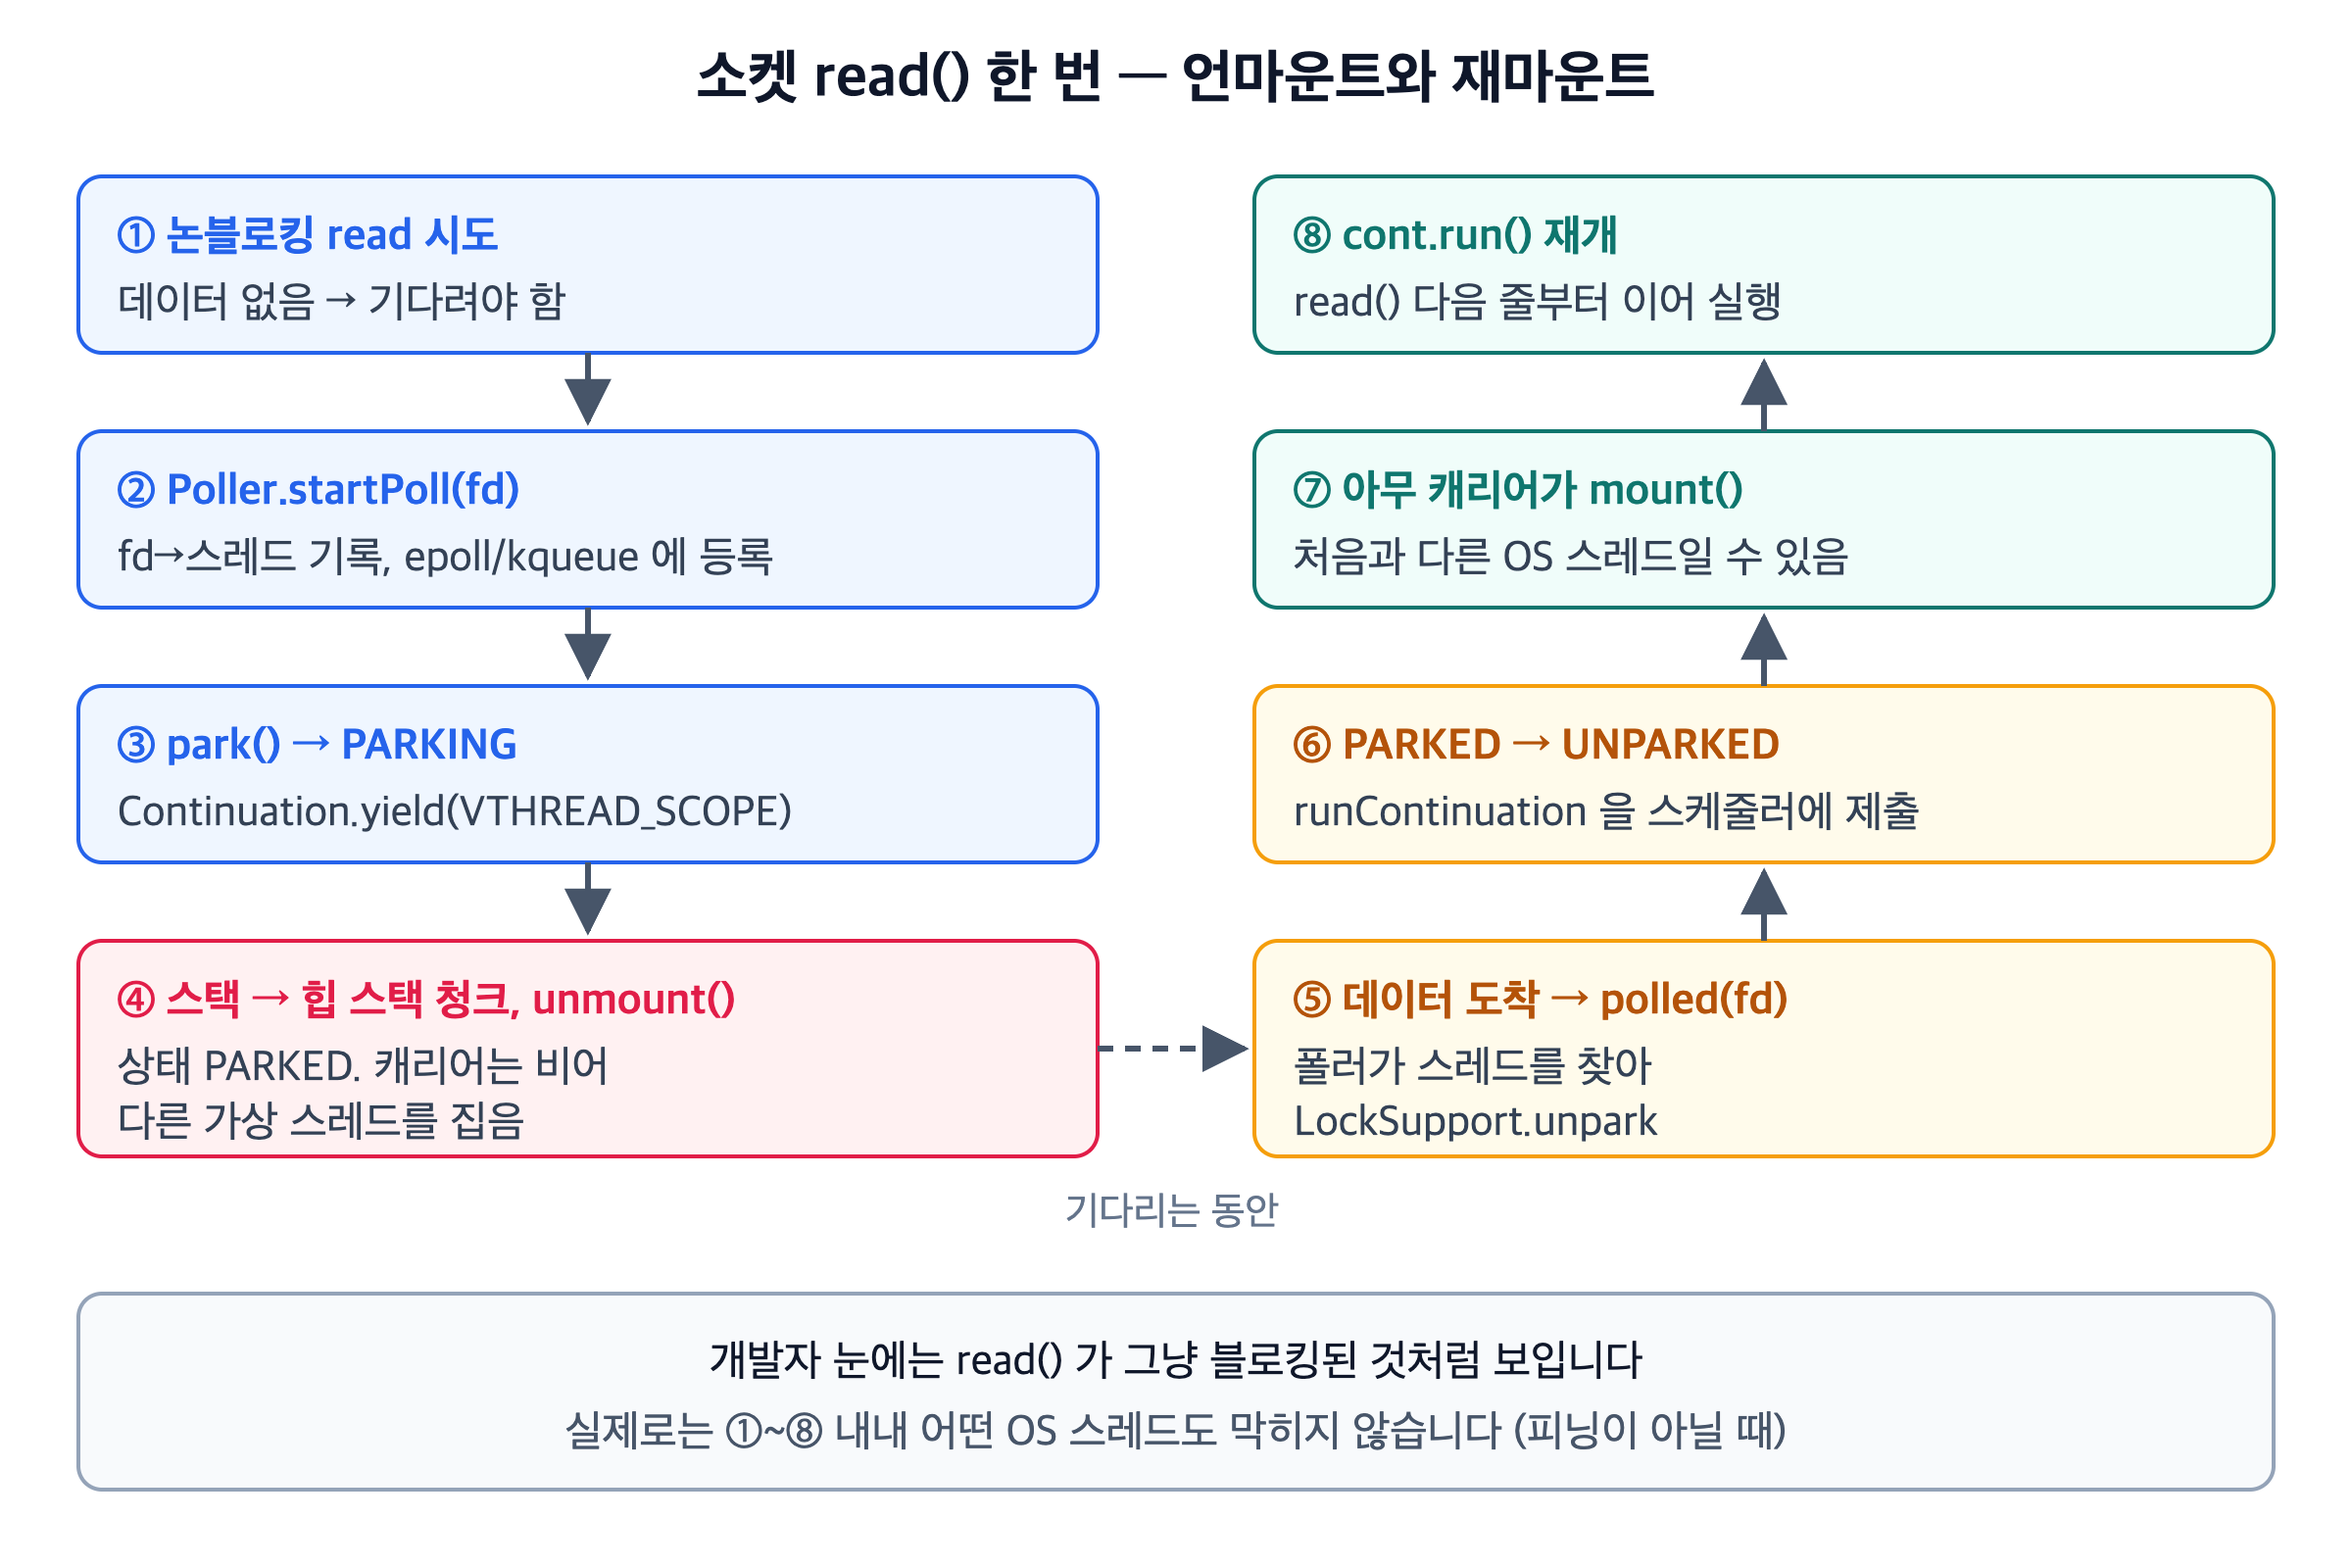
ng
(소켓 read 한 번에 가상 스레드가 언마운트되고 다시 마운트되는 순서)
1. 논블로킹 시도: JEP 444에 따르면 java.net·java.nio.channels 구현은 가상 스레드에서 "논블로킹 OS 호출을 하고, 다시 이어 갈 수 있을 때까지 가상 스레드를 자동으로 멈춥니다." 데이터가 이미 있으면 그냥 읽고 끝납니다.
2. 폴러 등록: 데이터가 없으면 sun.nio.ch.Poller 가 등장합니다. 소스 주석 그대로 "파일 디스크립터가 I/O 준비가 될 때까지 가상 스레드를 park 할 수 있게 하는 I/O 폴러"입니다. startPoll 이 fd → 스레드 매핑을 기록하고, OS 의 이벤트 기능(epoll·kqueue 등)에 fd 를 일회성으로 등록합니다.
3. park: 가상 스레드가 park() 를 부릅니다. 상태를 PARKING 으로 바꾸고 yieldContinuation() 을 호출합니다. 그 안에서 Continuation.yield(VTHREAD_SCOPE) 가 실행됩니다.
4. 언마운트: yield 순간 현재 스택 프레임이 힙의 스택 청크로 옮겨집니다. cont.run() 이 돌아오고, runContinuation() 은 unmount() 를 부릅니다. afterYield() 가 상태를 PARKED 로 바꿉니다. 캐리어는 이제 비었습니다. 큐에서 다른 가상 스레드를 집습니다.
5. 준비 완료 통지: 소켓에 데이터가 오면 폴러의 루프가 polled(fd) 를 부릅니다. 매핑에서 스레드를 꺼내 LockSupport.unpark 합니다.
6. 재스케줄: unpark() 는 상태를 PARKED → UNPARKED 로 CAS 하고, runContinuation 을 다시 스케줄러에 제출합니다.
7. 재마운트: 아무 캐리어가 그 작업을 집습니다. 처음과 다른 캐리어일 수 있습니다. mount() 후 cont.run() 이 힙의 스택 청크를 되살려 read() 다음 줄부터 이어 갑니다.
개발자 눈에는 read() 가 그냥 블로킹된 것처럼 보입니다. 실제로는 OS 스레드가 한 번도 막히지 않았습니다. 이것이 "동기식 코드, 비동기식 자원 사용"의 정체입니다.
Thread.sleep(), BlockingQueue.take(), ReentrantLock.lock() 도 같은 길을 탑니다. 호출한 쪽이 가상 스레드면 결국 VirtualThread 의 park 계열 메서드로 내려가고, 거기서 언마운트가 일어납니다.
▶ 2-5. 스케줄러: 전용 ForkJoinPool
기본 스케줄러는 VirtualThread.createDefaultScheduler() 가 만듭니다. 소스에서 읽히는 기본값은 다음과 같습니다.
시스템 속성 | 기본값 | 의미
----------------------------------
jdk.virtualThreadScheduler.parallelism | availableProcessors() | 동시에 가상 스레드를 실행할 캐리어 수
jdk.virtualThreadScheduler.maxPoolSize | max(parallelism, 256) | 일시 보충을 포함한 캐리어 최대 수
jdk.virtualThreadScheduler.minRunnable | max(parallelism / 2, 1) | 실행 가능한 캐리어 최소 수
풀은 asyncMode = true, 즉 FIFO 로 동작하는 work-stealing ForkJoinPool 입니다. JEP 444는 이 풀이 공용 풀(ForkJoinPool.commonPool())과 별개라고 명시합니다. 병렬 스트림과 캐리어를 나눠 쓰지 않습니다.
maxPoolSize 가 parallelism 보다 큰 이유가 있습니다. 일부 파일 시스템 작업처럼 OS 스레드를 어쩔 수 없이 붙잡는 호출이 있습니다. 이때 스케줄러는 캐리어를 일시적으로 늘려 보충합니다.
▶ 2-6. 피닝(pinning): 언마운트가 안 되는 경우
언마운트가 불가능한 순간이 있습니다. 이것을 피닝이라 부릅니다. 가상 스레드가 캐리어에 못 박힌 상태입니다. 이때 블로킹하면 소스의 park() 는 yield 에 실패하고 parkOnCarrierThread() 로 빠집니다. 상태는 PINNED 가 되고 캐리어 OS 스레드 자체가 멈춥니다.
[이미지 03] 03-pinning.png
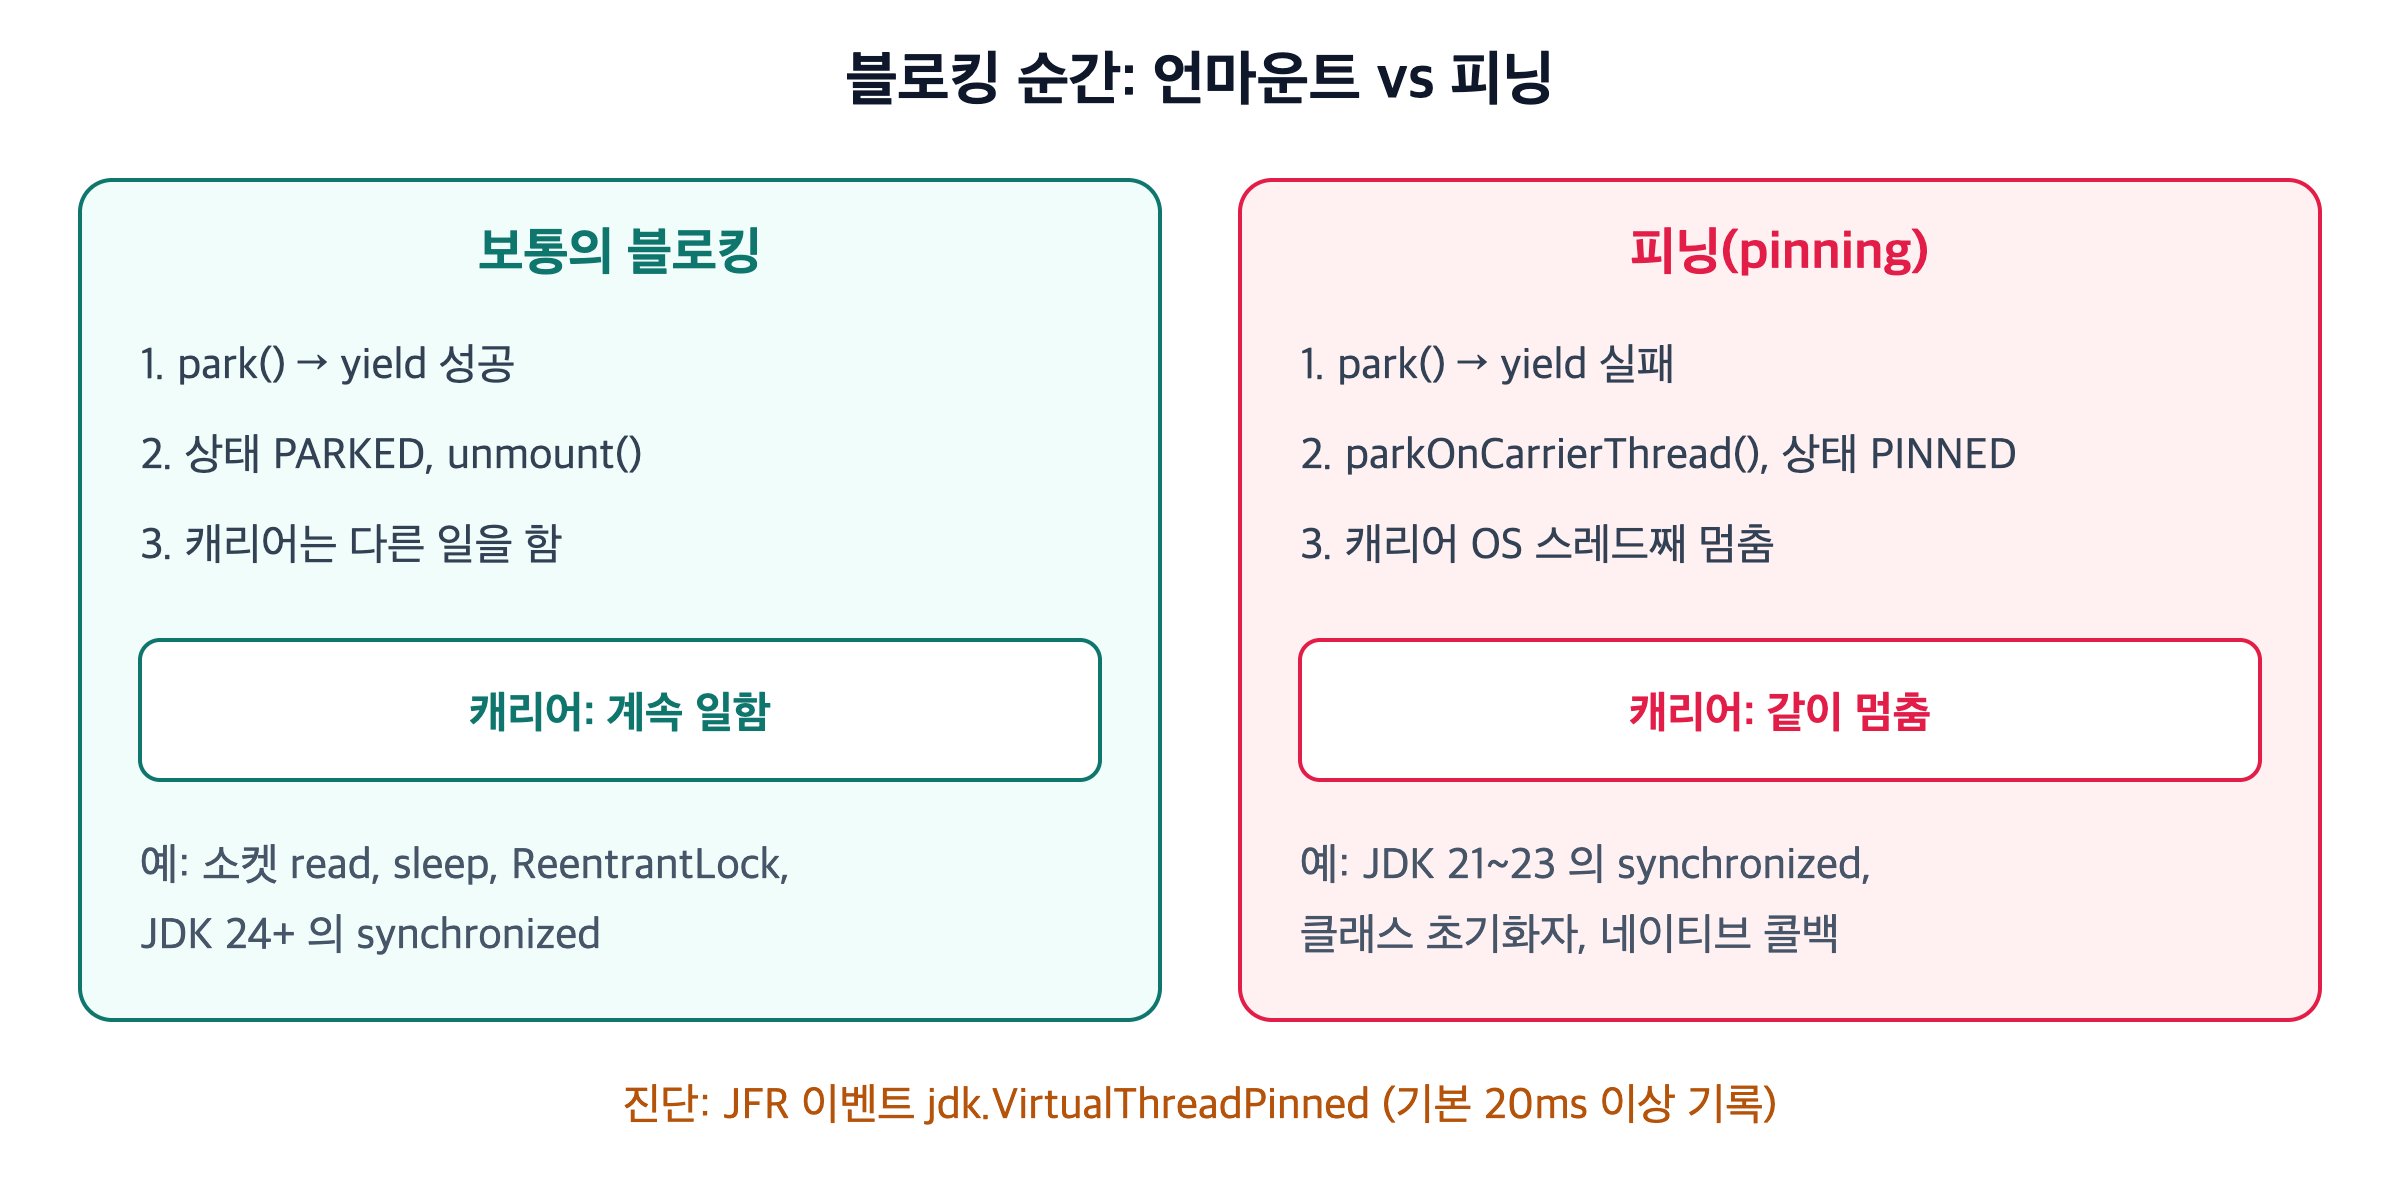
(블로킹 순간 yield 가 성공하면 언마운트, 실패하면 캐리어째 멈추는 피닝)
JDK 21의 피닝 조건은 두 가지였습니다.
- synchronized 블록·메서드 안에서 블로킹할 때
- native 메서드나 외부 함수(FFM) 실행 중일 때
synchronized 가 문제였던 이유는 JVM 모니터가 캐리어 OS 스레드 기준으로 소유자를 기록했기 때문입니다. 가상 스레드가 내려가면 모니터 소유 관계가 엉킵니다.
JDK 24의 JEP 491이 이것을 고쳤습니다. 원문은 "가상 스레드가 캐리어와 무관하게 모니터를 획득·보유·해제할 수 있다"고 적습니다. 이제 synchronized 안에서 블로킹해도, 모니터를 기다려도, Object.wait() 를 해도 언마운트됩니다. JEP 491이 남은 피닝으로 꼽는 경우는 이렇습니다.
- 클래스 로딩 중 클래스 참조를 해석하다 블로킹할 때
- 클래스 초기화자(static 초기화) 안에서 블로킹할 때, 또는 다른 스레드의 클래스 초기화를 기다릴 때
- 네이티브 코드가 자바로 콜백했는데 그 안에서 블로킹할 때
■ 3. 직접 해 보기
JDK 21 이상이면 됩니다. 아래 예제는 JDK 24.0.2 에서 단일 파일 실행(java 파일명.java)으로 돌렸습니다.
▶ 3-1. 1초짜리 작업 1만 개
JEP 444 의 예제와 같은 구조입니다.
[코드: java]
import java.time.Duration;
import java.time.Instant;
import java.util.concurrent.Executors;
import java.util.stream.IntStream;
public class VirtualDemo {
public static void main(String[] args) {
Instant start = Instant.now();
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
IntStream.range(0, 10_000).forEach(i ->
executor.submit(() -> {
Thread.sleep(Duration.ofSeconds(1));
return i;
}));
} // close()가 모든 작업이 끝날 때까지 기다립니다
System.out.println("elapsed: " + Duration.between(start, Instant.now()).toMillis() + " ms");
}
}
[/코드]
[코드: bash]
java VirtualDemo.java
[/코드]
newVirtualThreadPerTaskExecutor() 는 작업마다 새 가상 스레드를 만듭니다. 제 맥북에서는 1.5초 안팎에 끝났습니다. 같은 코드를 Executors.newFixedThreadPool(200) 으로 바꾸면 200개씩 50번 돌아야 하므로 50초가 넘게 걸렸습니다. 이 차이는 가상 스레드가 빨라서가 아닙니다. 기다리는 작업 1만 개가 동시에 기다릴 수 있어서입니다.
▶ 3-2. 캐리어가 바뀌는 장면 보기
가상 스레드의 toString() 은 지금 올라탄 캐리어를 함께 보여 줍니다.
[코드: java]
import java.util.ArrayList;
import java.util.List;
public class Carrier {
public static void main(String[] args) throws Exception {
List<Thread> threads = new ArrayList<>();
for (int i = 0; i < 4; i++) {
threads.add(Thread.ofVirtual().name("vt-" + i).start(() -> {
String before = Thread.currentThread().toString();
try { Thread.sleep(100); } catch (InterruptedException e) { }
System.out.println(before + " -> " + Thread.currentThread());
}));
}
for (Thread t : threads) t.join();
}
}
[/코드]
[코드: bash]
java -Djdk.virtualThreadScheduler.parallelism=1 Carrier.java
[/코드]
실제 출력의 일부입니다.
[코드: text]
VirtualThread[#28,vt-1]/runnable@ForkJoinPool-1-worker-1 -> VirtualThread[#28,vt-1]/runnable@ForkJoinPool-1-worker-2
VirtualThread[#29,vt-2]/runnable@ForkJoinPool-1-worker-1 -> VirtualThread[#29,vt-2]/runnable@ForkJoinPool-1-worker-2
[/코드]
sleep 전에는 worker-1, 후에는 worker-2 위에 있습니다. 핵심은 sleep 앞뒤로 같은 가상 스레드가 다른 OS 스레드에서 돈다는 사실입니다. 2-4절의 언마운트·재마운트가 눈에 보이는 장면입니다.
▶ 3-3. 운영 중에 들여다보기
[코드: bash]
# 가상 스레드까지 포함한 스레드 덤프 (JSON)
jcmd <pid> Thread.dump_to_file -format=json threads.json
# 피닝 기록: JFR 의 jdk.VirtualThreadPinned 이벤트 (기본 20ms 이상)
jcmd <pid> JFR.start duration=60s filename=pin.jfr
jfr print --events jdk.VirtualThreadPinned pin.jfr
[/코드]
JEP 444 는 기존의 평면 덤프를 늘리는 대신 가상 스레드를 묶어 보여 주는 새 덤프 형식을 만들었습니다. 이 덤프는 생성할 때 애플리케이션을 멈추지 않습니다.
■ 4. 플랫폼 스레드·가상 스레드·비동기 비교
항목 | 플랫폼 스레드 + 풀 | 가상 스레드 | 비동기(CompletableFuture·리액티브)
------------------------------------------------------------
OS 스레드와 관계 | 1:1, 평생 점유 | M:N, 실행 중에만 점유 | 소수 스레드에 콜백 배분
스택 | OS 예약 고정 크기 | 힙의 스택 청크, 늘고 줆 | 스택 없음(콜백 체인)
스케줄링 | 커널 | JDK ForkJoinPool | 이벤트 루프·실행기
코드 모양 | 동기식 | 동기식 | 콜백·연산자 사슬
스택 트레이스·디버거 | 그대로 | 그대로 | 단계마다 끊김
풀링 | 필수 | 하지 않음 | 해당 없음
잘 맞는 일 | CPU 작업, 소수의 긴 작업 | I/O 대기가 많은 대량 동시 작업 | I/O 대기 + 스트림 조합·배압
JDK 버전별로 달라진 점도 정리합니다.
JDK | 상태 | 바뀐 것
------------------------------
19 | 프리뷰 (JEP 425) | 첫 도입
20 | 2차 프리뷰 (JEP 436) | 다듬기
21 | 정식 (JEP 444) | synchronized·네이티브에서 피닝
24 | JEP 491 | synchronized 피닝 해소, jdk.tracePinnedThreads 제거
■ 5. 흔한 오해와 실수
"가상 스레드는 빠른 스레드다." 아닙니다. Oracle 문서는 못 박습니다. "가상 스레드는 더 빠른 스레드가 아니다. 플랫폼 스레드보다 코드를 빨리 실행하지 않는다. 속도(낮은 지연)가 아니라 규모(높은 처리량)를 위해 존재한다." 요청 하나의 응답 시간은 그대로입니다. 동시에 기다릴 수 있는 요청 수가 늘어날 뿐입니다.
CPU 작업에 가상 스레드를 쓴다. 캐리어 수는 기본적으로 코어 수입니다. 계산만 하는 가상 스레드는 블로킹 지점이 없으니 언마운트될 일도 없습니다. 이미지 변환·암호화 같은 일은 이점이 없습니다. Oracle 문서는 "가상 스레드가 1만 개 이상 생길 일이 없으면 이득을 보기 어렵다"는 경험칙도 제시합니다.
가상 스레드를 풀에 담는다. JEP 444는 "가상 스레드는 절대 풀링하지 말라"고 합니다. 만드는 비용이 객체 생성 수준이니 작업마다 새로 만드는 것이 기본입니다. newFixedThreadPool(200, Thread.ofVirtual().factory()) 같은 코드는 가상 스레드의 장점을 200개로 묶어 버립니다.
동시성 제한을 스레드 수로 건다. 플랫폼 스레드 시절에는 풀 크기가 곧 동시성 상한이었습니다. 가상 스레드에서는 그 안전장치가 사라집니다. 외부 API 가 동시 10건만 받는다면 Semaphore(10) 처럼 자원 쪽에서 제한해야 합니다. 그렇지 않으면 가상 스레드 1만 개가 DB 커넥션 풀 앞에 줄을 섭니다. 이 줄 서기 자체는 싸지만, 타임아웃이 짧으면 대량 실패로 바뀝니다.
ThreadLocal 에 비싼 객체를 캐시한다. 플랫폼 스레드 풀에서는 ThreadLocal<SimpleDateFormat> 이 스레드 수만큼만 생겼습니다. 가상 스레드는 재사용되지 않습니다. 작업 1만 개면 1만 개가 생깁니다. Oracle 문서는 이 패턴이 가상 스레드와 "근본적으로 어긋난다"고 하며 불변 객체(DateTimeFormatter)를 권합니다. 요청 문맥을 담는 용도의 ThreadLocal 은 괜찮습니다.
JDK 21 에서 synchronized 안에서 I/O 를 한다. JDK 21~23에서는 이 경우 캐리어가 통째로 멈춥니다. 캐리어가 코어 수만큼밖에 없으니 몇 개만 피닝돼도 전체가 멈춘 것처럼 보입니다. 오래 걸리는 I/O 를 감싸는 synchronized 는 ReentrantLock 으로 바꾸거나, JDK 24 이상으로 올리는 것이 답입니다. JDK 24에서는 -Djdk.tracePinnedThreads 가 제거돼 아무 효과가 없습니다. 피닝 진단은 JFR jdk.VirtualThreadPinned 로 합니다.
■ 6. 정리
- 가상 스레드는 스택을 힙의 스택 청크에 두고, JDK 의 ForkJoinPool 이 소수의 캐리어 OS 스레드에 올렸다 내리는 M:N 스레드입니다.
- 블로킹 지점에서 컨티뉴에이션이 yield 하며 캐리어를 비워 주고, 준비가 되면 아무 캐리어에서나 그 자리부터 이어 갑니다.
- 빠른 스레드가 아니라 많이 기다릴 수 있는 스레드입니다. 풀링하지 말고, 동시성은 세마포어로 제한하고, 피닝은 JFR 로 확인하세요.
■ 참고 자료
- JEP 444: Virtual Threads — OpenJDK(https://openjdk.org/jeps/444)
- JEP 491: Synchronize Virtual Threads without Pinning — OpenJDK(https://openjdk.org/jeps/491)
- Virtual Threads — Java SE 21 Core Libraries, Oracle(https://docs.oracle.com/en/java/javase/21/core/virtual-threads.html)
- VirtualThread.java — OpenJDK 소스(https://github.com/openjdk/jdk/blob/master/src/java.base/share/classes/java/lang/VirtualThread.java)
- Poller.java — OpenJDK 소스(https://github.com/openjdk/jdk/blob/master/src/java.base/share/classes/sun/nio/ch/Poller.java)
- java 명령 문서(-Xss 기본값) — Oracle(https://docs.oracle.com/en/java/javase/21/docs/specs/man/java.html)
'Language > [Java]' 카테고리의 다른 글
| [Java] Record 패턴 (0) | 2024.04.28 |
|---|---|
| [Java] Generic ! (0) | 2023.07.15 |
| [Java] mapMulti 사용 (0) | 2023.07.07 |
| [Java] static block 및 instance block (0) | 2023.06.26 |
| [Java] 제네릭을 조금 잘 써보면 어떨까 (0) | 2023.06.18 |
