레디스는 "단일 스레드인데 빠르다"는 말로 소개됩니다. 반은 맞고 반은 틀립니다. 명령을 실행하는 스레드는 하나가 맞습니다. 그러나 빠른 이유는 스레드 개수가 아닙니다. 소켓을 기다리지 않는 구조, 메모리 안에서 끝나는 자료구조, 시스템 콜을 줄이는 습관이 함께 만든 결과입니다.
이 글은 레디스 소스(ae.c, server.c, networking.c)와 공식 문서를 따라가며 요청 하나가 어떤 순서로 처리되는지 풉니다. 그리고 같은 구조가 왜 KEYS * 한 번에 서비스 전체를 멈추게 하는지도 봅니다.
■ 1. 레디스가 푸는 문제 — 스레드를 늘리지 않고 연결을 많이 받기
전통적인 서버는 연결 하나에 스레드 하나를 붙입니다. 스레드는 read() 에서 데이터가 올 때까지 잠들어 있습니다. 연결이 만 개면 잠든 스레드도 만 개입니다. 스레드마다 스택 메모리가 들고, 깨울 때마다 문맥 전환 비용이 듭니다. 공유 자료구조에는 락이 필요합니다.
레디스가 다루는 일은 성격이 다릅니다. GET, SET, LPUSH 같은 명령은 메모리 안의 해시 테이블이나 리스트를 한 번 건드리고 끝납니다. 공식 지연 시간 문서는 레디스의 처리 시간이 "보통 마이크로초 미만"이라고 적습니다. 일 자체는 짧고, 시간은 대부분 네트워크를 기다리는 데 씁니다.
이런 일에는 스레드를 늘리는 것보다 기다리는 일을 커널에 맡기는 것이 낫습니다. 스레드 하나가 수많은 소켓을 동시에 지켜보다가, 데이터가 도착한 소켓만 골라 처리합니다. 이것이 I/O 멀티플렉싱이고, 레디스 공식 문서가 직접 쓰는 단어입니다.
> Redis uses a mostly single threaded design. This means that a single process serves all the client requests, using a technique called multiplexing.
> — Redis 공식 문서, Diagnosing latency issues
같은 문서는 레디스가 Node.js 와 매우 비슷하게 동작한다고 설명합니다. 둘 다 느리다고 여겨지지 않는 이유는 요청 하나를 처리하는 시간이 짧고, 무엇보다 소켓 읽기·쓰기 같은 시스템 콜에서 블록되지 않도록 설계됐기 때문이라고 합니다.
[이미지 01] 01-shot-1.png
(레디스 공식 지연 시간 문서 (출
처: redis.io))
■ 2. 내부 동작 원리 — 이벤트 루프 한 바퀴
▶ 2-1. ae: 레디스가 직접 만든 이벤트 루프
레디스는 libevent 같은 외부 라이브러리를 쓰지 않습니다. src/ae.c 에 작은 이벤트 루프를 직접 구현했습니다. 운영체제마다 가장 좋은 멀티플렉싱 API 를 컴파일 시점에 고릅니다.
[코드: c]
/* Include the best multiplexing layer supported by this system.
* The following should be ordered by performances, descending. */
#ifdef HAVE_EVPORT
#include "ae_evport.c"
#else
#ifdef HAVE_EPOLL
#include "ae_epoll.c"
#else
#ifdef HAVE_KQUEUE
#include "ae_kqueue.c"
#else
#include "ae_select.c"
#endif
#endif
#endif
[/코드]
리눅스에서는 epoll, macOS·BSD 에서는 kqueue, 솔라리스 계열에서는 evport 를 씁니다. 실행 중인 레디스에서 INFO server 를 치면 multiplexing_api:epoll 처럼 무엇이 선택됐는지 나옵니다.
루프 본체는 놀랄 만큼 짧습니다. aeMain() 은 stop 플래그가 설 때까지 aeProcessEvents() 를 반복해서 부를 뿐입니다. server.c 의 main() 끝에서 이 함수가 호출되면 서버는 그 안에서 평생 돕니다.
[이미지 02] 02-shot-2.png
(레디스 이벤트 루프 구현 ae.c (출처: GitHub redis/redis))
▶ 2-2. 한 바퀴의 순서
aeProcessEvents() 한 번이 루프 한 바퀴입니다. 소스 순서 그대로 정리하면 이렇습니다.
1. beforeSleep 호출. 잠들기 전에 밀린 일을 처리합니다. 쌓인 응답을 소켓에 쓰고(handleClientsWithPendingWrites), AOF 버퍼를 파일로 내보내고(flushAppendOnlyFile), 만료 키를 빠르게 한 번 훑습니다(activeExpireCycle(ACTIVE_EXPIRE_CYCLE_FAST)).
2. 대기 시간 계산. 가장 가까운 타이머 이벤트까지 남은 시간을 구합니다. 그 시간만큼만 잠듭니다.
3. aeApiPoll — 커널에 맡기고 잠들기. 리눅스라면 epoll_wait() 입니다. 등록된 소켓 중 읽을 데이터가 생기거나 쓸 수 있게 된 것이 나오면, 또는 타이머 시간이 되면 깨어납니다.
4. afterSleep 호출.
5. 준비된 파일 이벤트 처리. 깨어난 소켓 목록을 돌며 읽기 핸들러를 먼저, 쓰기 핸들러를 나중에 부릅니다. 소스 주석은 그 이유를 "질의를 처리한 직후 바로 응답을 보낼 수 있을 때가 있기 때문"이라고 적습니다.
6. 시간 이벤트 처리. serverCron 같은 주기 작업을 실행합니다. 기본 설정 hz 10 이므로 초당 10번 돕니다.
[이미지 03] 03-event-loop.png

(레디스 이벤트 루프 한 바퀴: beforeSleep → epoll_wait → 읽기·쓰기 핸들러 → 시간 이벤트)
핵심은 3단계입니다. 레디스가 기다리는 곳은 이 한 곳뿐입니다. 소켓 하나하나를 붙잡고 기다리지 않습니다. 커널이 "이 소켓들이 준비됐다"고 알려 주면 그때 깨어나 준비된 것만 처리합니다. 준비된 소켓에서 read() 는 기다리지 않고 바로 돌아옵니다.
▶ 2-3. SET 명령 하나가 지나가는 길
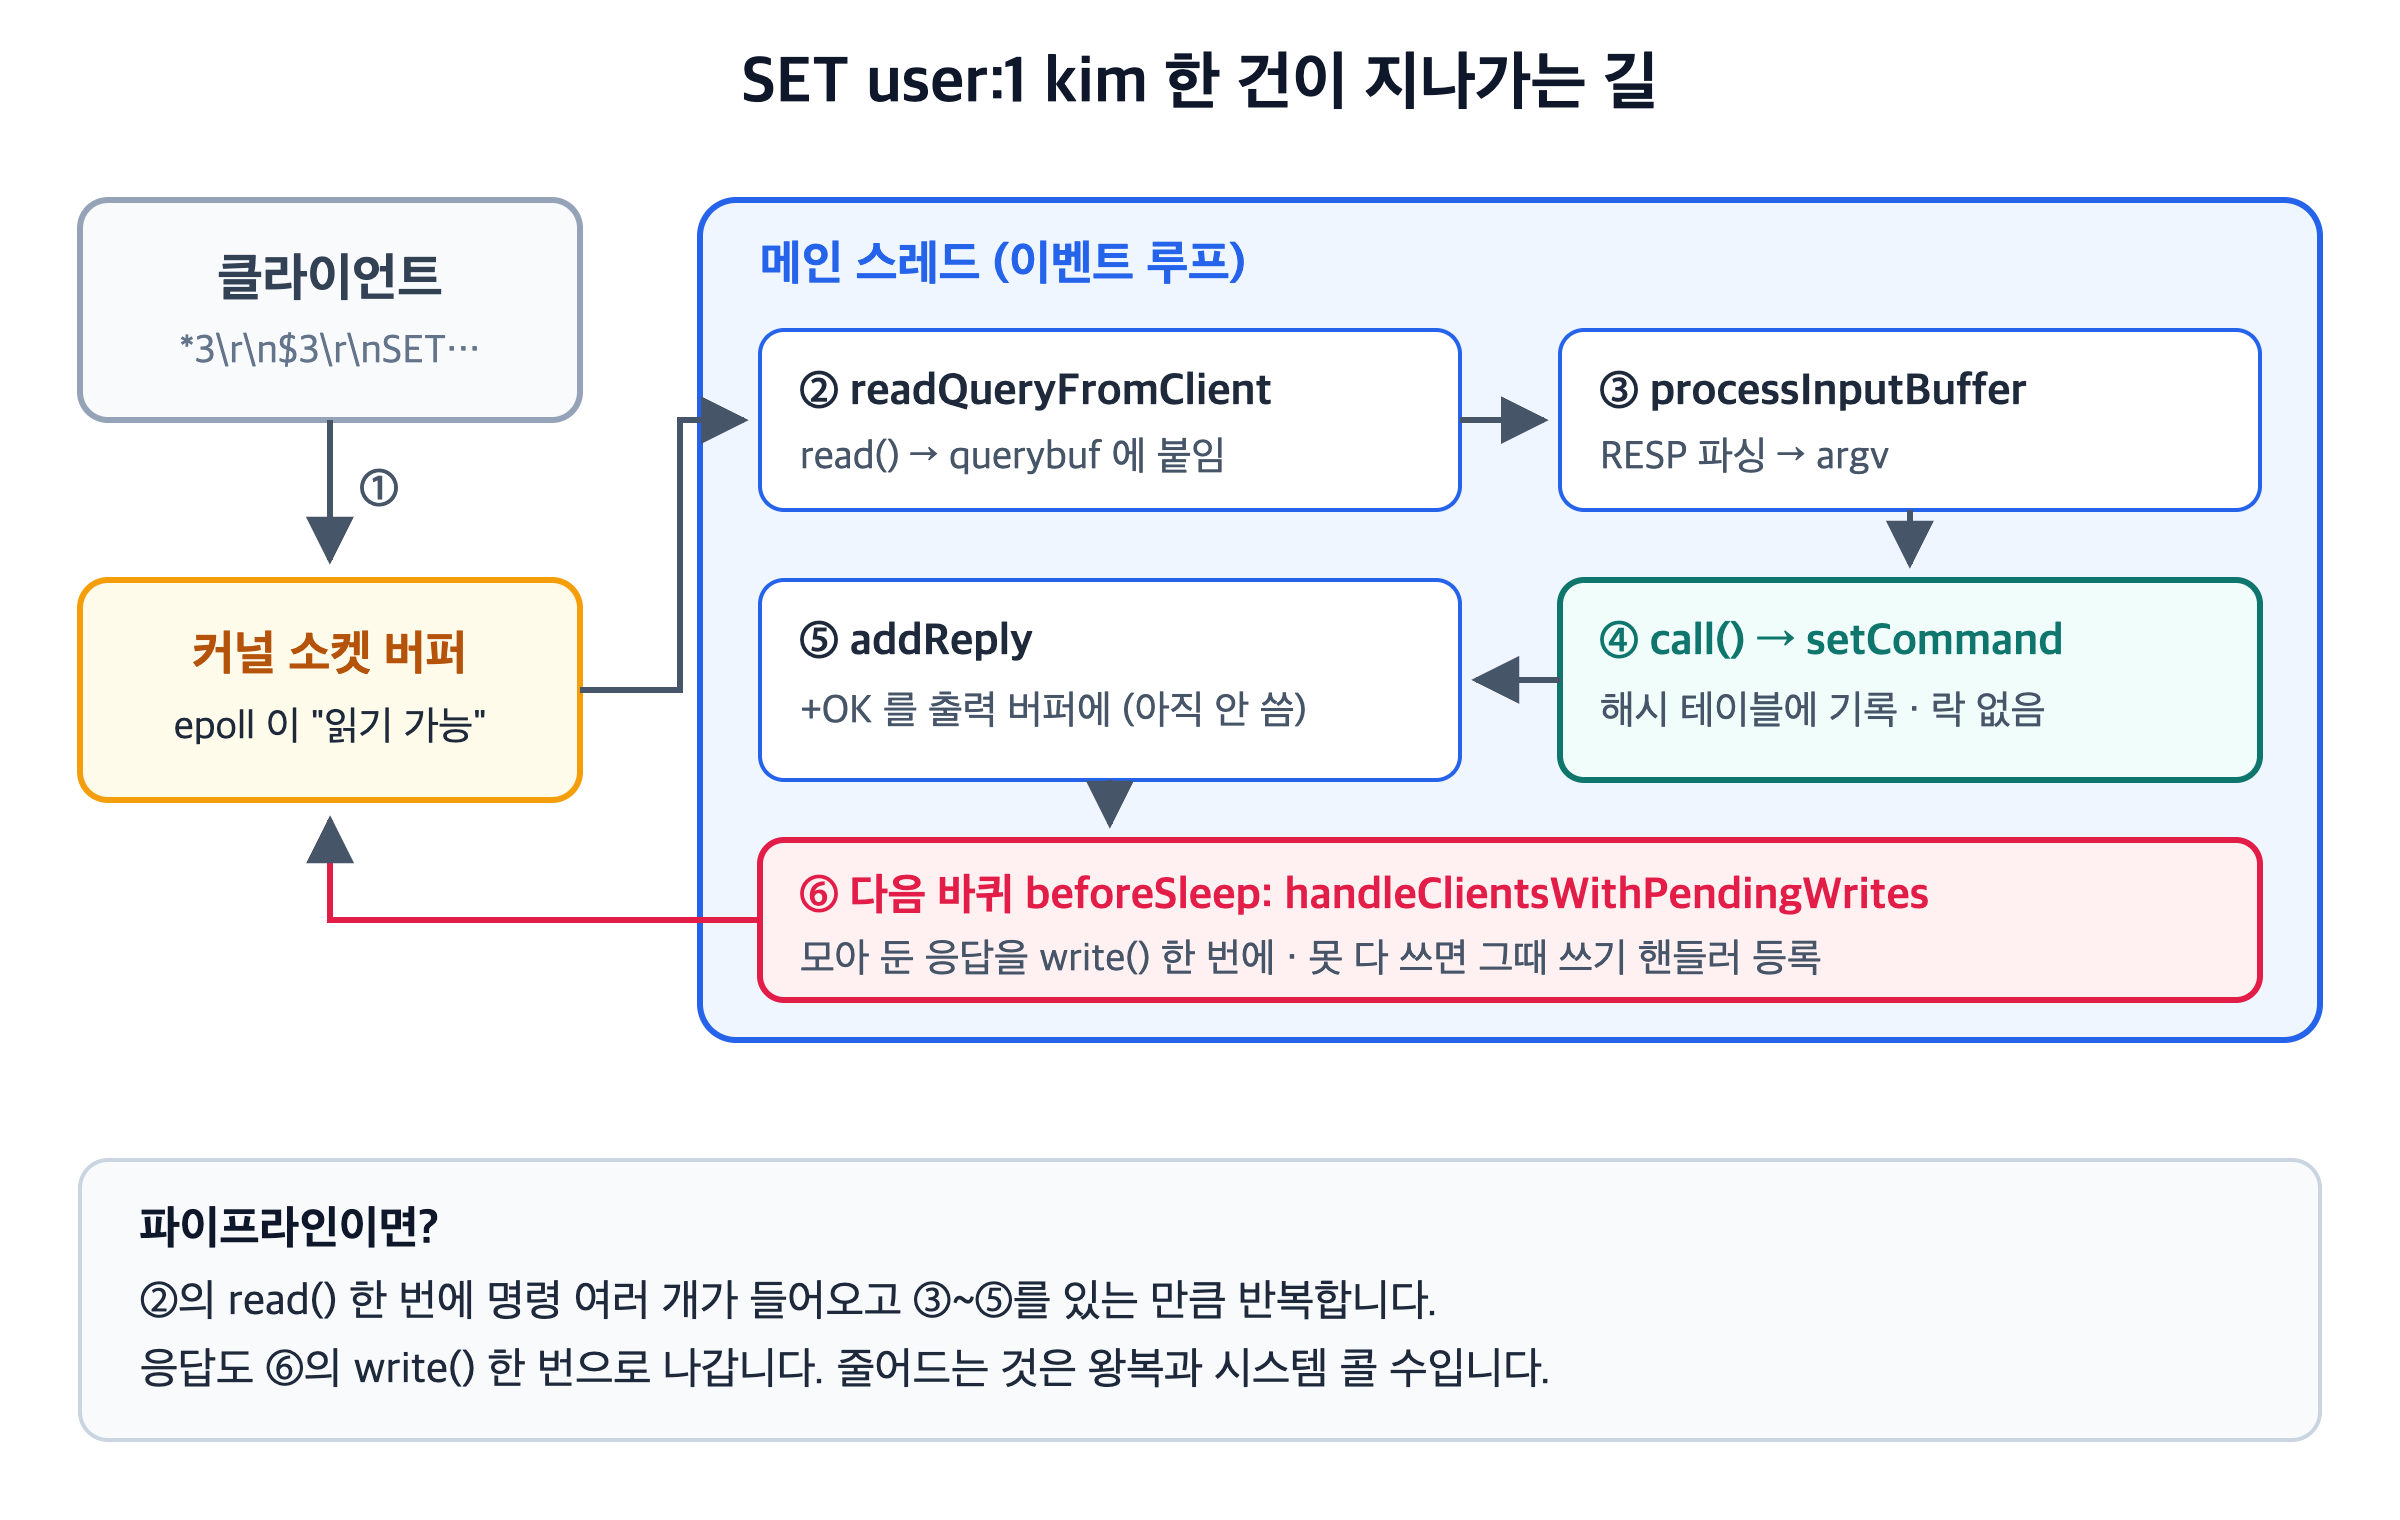
클라이언트가 SET user:1 kim 을 보낸다고 해 봅시다.
1. 연결 수립. 리스닝 소켓이 읽기 가능해지면 accept 핸들러가 새 연결을 받습니다. 클라이언트 객체를 만들면서 connSetReadHandler(conn, readQueryFromClient) 로 이 소켓의 읽기 핸들러를 등록합니다.
2. 바이트 도착. 클라이언트가 RESP 형식으로 *3\r\n$3\r\nSET\r\n... 를 보냅니다. 커널 수신 버퍼에 쌓이고, 다음 epoll_wait() 가 이 소켓을 돌려줍니다.
3. 읽기. readQueryFromClient() 가 read() 로 바이트를 클라이언트별 입력 버퍼(querybuf)에 붙입니다.
4. 파싱. processInputBuffer() 가 버퍼에서 완전한 명령을 잘라 인자 배열(argv)로 만듭니다. 명령이 아직 덜 왔으면 다음 바퀴를 기다립니다. 한 번에 여러 명령이 와 있으면(파이프라인) 있는 만큼 연달아 처리합니다.
5. 실행. processCommand() → call() → setCommand() 순서로 들어가 메모리의 해시 테이블에 키를 넣습니다. 여기에는 락이 없습니다. 이 자료구조를 만지는 스레드가 하나뿐이기 때문입니다.
6. 응답 버퍼링. addReply() 가 +OK\r\n 을 클라이언트의 출력 버퍼에 넣고, 이 클라이언트를 "쓸 응답이 있는 목록"에 올립니다. 아직 소켓에 쓰지 않습니다.
7. 쓰기. 다음 바퀴의 beforeSleep() 에서 handleClientsWithPendingWrites() 가 목록을 돌며 write() 로 응답을 보냅니다. 한 번에 다 못 쓰면 그때서야 쓰기 핸들러를 등록해 소켓이 비기를 기다립니다.
[이미지 04] 04-request-flow.png
(SET 요청 한 건의 흐름: 소켓 → querybuf → 파싱 → 실행 → 출력 버퍼 → beforeSleep 에서 write)
6~7단계가 눈여겨볼 부분입니다. 응답을 바로 쓰지 않고 모았다가 잠들기 직전에 한 번에 씁니다. 같은 바퀴에서 같은 클라이언트의 명령 여러 개가 처리됐다면 응답도 한 번의 write() 로 나갑니다. AOF appendfsync always 설정에서는 이 순서가 더 중요합니다. 디스크 기록을 마친 다음에 클라이언트에 응답해야 하므로, beforeSleep() 안에서 flushAppendOnlyFile() 이 응답 쓰기보다 먼저 호출됩니다.
▶ 2-4. 그래서 왜 빠른가
정리하면 속도는 네 가지에서 나옵니다.
- 기다림을 커널에 넘깁니다. 스레드 하나가 epoll 로 수많은 연결을 지켜봅니다. 연결이 늘어도 스레드는 늘지 않습니다.
- 일이 메모리에서 끝납니다. 명령 실행 중 디스크를 기다리지 않습니다. 디스크 쓰기(fsync)는 별도 스레드나 자식 프로세스로 넘깁니다.
- 락이 없습니다. 자료구조를 만지는 스레드가 하나라 동기화 비용과 락 경합이 없습니다. 모든 명령이 저절로 원자적입니다.
- 시스템 콜을 아낍니다. 공식 파이프라이닝 문서는 명령 처리 자체는 싸지만 소켓 I/O, 즉 read()·write() 시스템 콜로 사용자 영역과 커널 영역을 오가는 비용이 크다고 설명합니다. 파이프라인을 쓰면 여러 명령을 read() 한 번에 읽고 여러 응답을 write() 한 번에 보냅니다. 같은 문서는 이렇게 해서 초당 처리량이 파이프라인을 쓰지 않을 때의 10배까지 오른다고 적습니다.
FAQ 는 더 직접적으로 말합니다. 레디스에서 CPU 가 병목이 되는 일은 흔하지 않고, 보통은 메모리나 네트워크가 병목이라고 합니다. 평범한 리눅스 시스템에서 파이프라인을 쓰면 인스턴스 하나가 초당 100만 요청을 처리할 수 있다고도 적습니다.
▶ 2-5. "단일 스레드"의 정확한 범위
레디스 프로세스를 top -H 로 보면 스레드가 여러 개입니다. 공식 문서도 "대부분 단일 스레드(mostly single threaded)"라고 씁니다. 나눠 보면 이렇습니다.
작업 | 누가 하나 | 근거
------------------------------
명령 실행·자료구조 변경 | 메인 스레드 하나 | 지연 시간 문서
소켓 읽기·파싱·응답 쓰기 | 기본은 메인 스레드, io-threads 를 켜면 I/O 스레드 | redis.conf, 8.0 릴리스 노트
AOF fdatasync (everysec) | 백그라운드 스레드 (2.4부터) | 지연 시간 문서
UNLINK, FLUSHALL ASYNC 메모리 해제 | 백그라운드 스레드 | redis.conf LAZY FREEING
RDB 스냅숏, AOF 재작성 | fork() 한 자식 프로세스 | 지연 시간 문서
▶ 2-6. I/O 스레드 — 실행은 그대로 하나
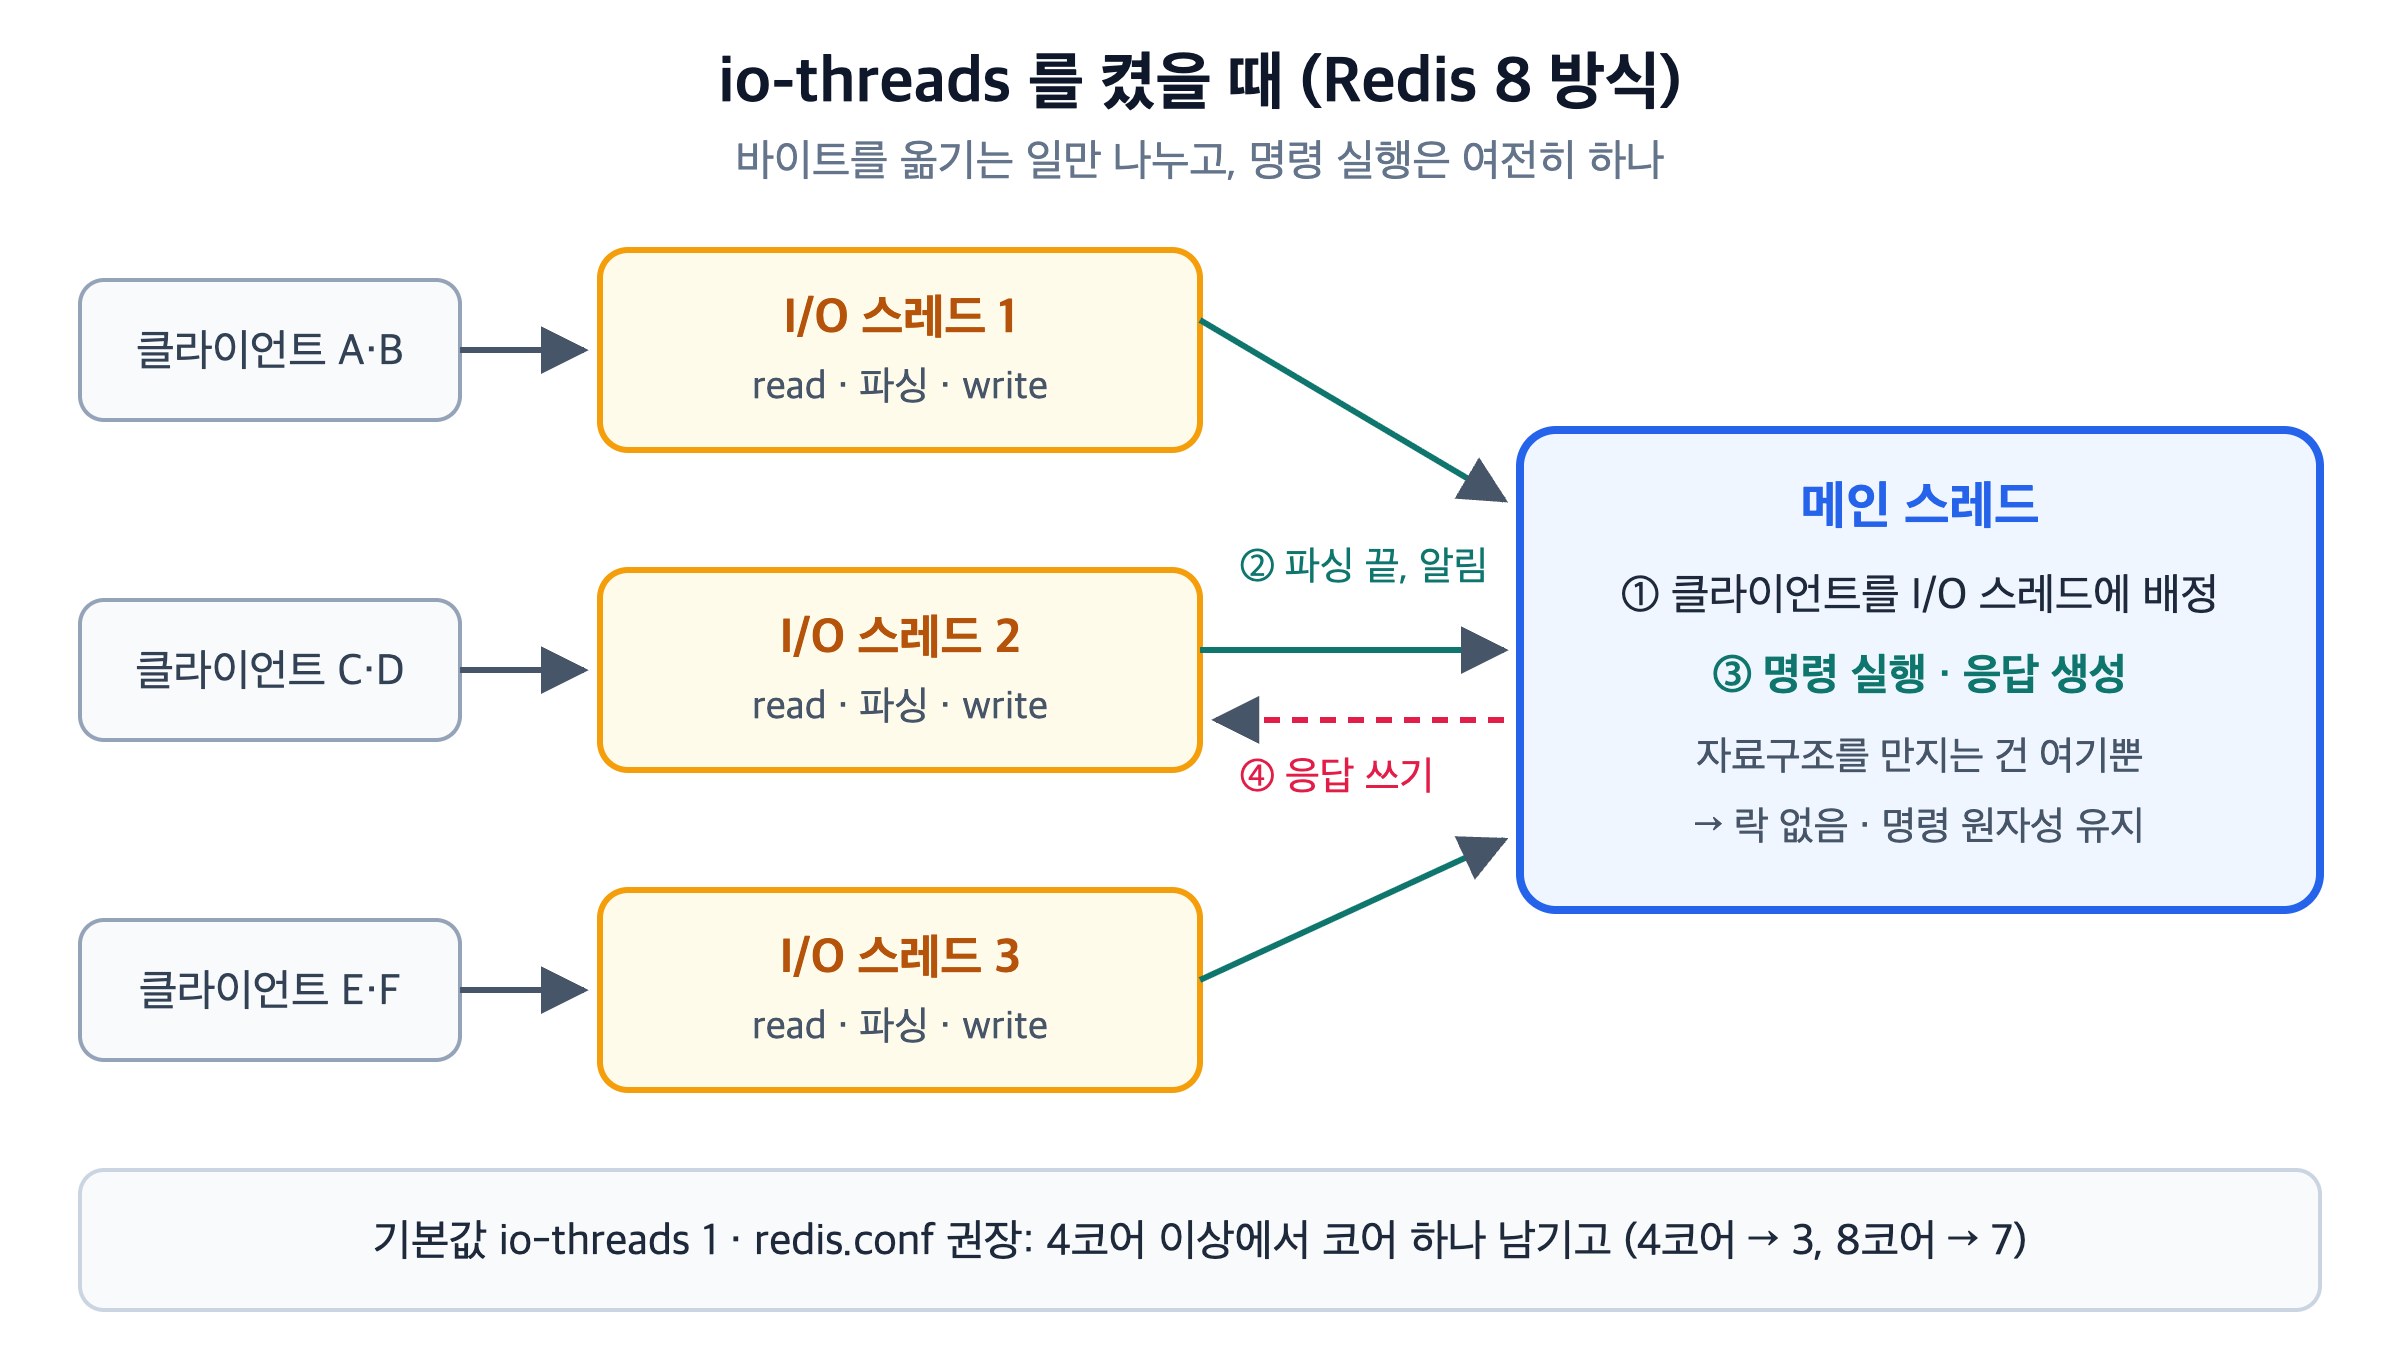
6.0 부터 레디스는 소켓 읽기·쓰기와 프로토콜 파싱을 별도 I/O 스레드에 나눌 수 있습니다. 8.0 에서는 이 구현을 새로 만들었습니다. 레디스 블로그의 8.0-M03 발표 글은 새 방식을 이렇게 설명합니다.
1. 메인 스레드가 각 클라이언트를 특정 I/O 스레드에 배정합니다.
2. I/O 스레드는 그 클라이언트의 질의를 읽고 파싱한 뒤 메인 스레드에 알립니다.
3. 메인 스레드가 명령을 실행하고 응답을 만듭니다.
4. I/O 스레드가 응답을 클라이언트에 씁니다.
[이미지 05] 05-io-threads.png
(io-threads 를 켰을 때: 읽기·파싱·쓰기는 I/O 스레드, 실행은 메인 스레드 하나)
명령 실행은 여전히 메인 스레드 하나입니다. 그래서 락 없는 자료구조와 명령 단위 원자성은 그대로 유지됩니다. 나뉜 것은 시스템 콜과 파싱처럼 바이트를 옮기는 일뿐입니다. 같은 글은 멀티코어 인텔 CPU 에서 io-threads 8 로 측정했을 때 실행하는 명령에 따라 처리량이 37%에서 112%까지 올랐다고 밝힙니다.
기본값은 꺼져 있습니다(io-threads 1). redis.conf 주석은 코어가 4개 이상인 머신에서만, 코어 하나는 남겨 두고 켜라고 권합니다. 4코어면 3개, 8코어면 7개입니다. 또 레디스가 실제로 CPU 를 많이 쓰는 성능 문제가 있을 때만 켜라고 적습니다.
[이미지 06] 06-shot-3.png
(Redis 8.0-M03 발표 글: 새 비동기 I/O 스레딩 (출처: Redis 블로그))
■ 3. 직접 해 보기
도커만 있으면 됩니다. 레디스 컨테이너와 파이썬 컨테이너를 같은 네트워크에 띄웁니다.
[코드: bash]
docker network create rdsnet
docker run -d --name redis --network rdsnet redis:8
docker exec redis redis-cli INFO server | grep -E "redis_version|multiplexing_api"
[/코드]
아래 스크립트는 세 가지를 잽니다. 파이프라인 없이 1만 번, 1000개씩 묶어 1만 번, 그리고 다른 연결이 무거운 Lua 스크립트를 돌리는 동안의 PING 응답 시간입니다.
[코드: python]
# bench.py
import time, threading
import redis
r = redis.Redis(host="redis", port=6379)
N = 10_000
# 1) 한 번에 하나씩: 명령마다 왕복 1번
t = time.perf_counter()
for i in range(N):
r.set(f"k:{i}", i)
print(f"파이프라인 없이 : {time.perf_counter() - t:.3f}s")
# 2) 파이프라인: 1000개씩 묶어 보냄
t = time.perf_counter()
pipe = r.pipeline(transaction=False)
for i in range(N):
pipe.set(f"k:{i}", i)
if i % 1000 == 999:
pipe.execute()
pipe.execute()
print(f"파이프라인 1000개: {time.perf_counter() - t:.3f}s")
# 3) 느린 명령 하나가 다른 클라이언트를 세운다
slow = redis.Redis(host="redis", port=6379)
busy = "local i = 0 while i < 3e8 do i = i + 1 end return i"
th = threading.Thread(target=lambda: slow.eval(busy, 0))
th.start()
time.sleep(0.2) # EVAL 이 먼저 메인 스레드를 잡도록
t = time.perf_counter()
r.ping() # 다른 연결의 PING
print(f"EVAL 도는 중 PING: {time.perf_counter() - t:.3f}s")
th.join()
[/코드]
[코드: bash]
docker run --rm --network rdsnet -v "$PWD":/app -w /app python:3.12-slim \
sh -c "pip -q install redis && python bench.py"
[/코드]
필자의 맥북(도커 데스크톱, Redis 8.10.2)에서 나온 결과입니다. 숫자는 환경마다 다릅니다. 봐야 할 것은 비율과 현상입니다.
[코드: text]
파이프라인 없이 : 1.213s
파이프라인 1000개: 0.095s
EVAL 도는 중 PING: 3.756s
[/코드]
파이프라인 쪽이 10배 넘게 빠릅니다. 서버가 한 일은 같고 왕복과 시스템 콜 수만 줄었습니다. 세 번째 줄이 이 글의 요점입니다. PING 은 세상에서 가장 가벼운 명령입니다. 그런데 다른 연결의 Lua 루프가 메인 스레드를 쥐고 있는 동안 3초 넘게 기다렸습니다. 이벤트 루프가 다음 바퀴로 넘어가지 못했기 때문입니다.
정리할 때는 아래 명령을 씁니다.
[코드: bash]
docker rm -f redis && docker network rm rdsnet
[/코드]
■ 4. 설정값과 대안 비교
먼저 지연에 직접 영향을 주는 설정입니다. 기본값은 저장소의 redis.conf 기준입니다.
설정 | 기본값 | 바꾸면 무엇이 달라지나
----------------------------------------------
io-threads | 1 (꺼짐) | 소켓 읽기·쓰기·파싱을 I/O 스레드로 분산. 명령 실행은 그대로 하나
appendfsync | everysec | always 는 쓰기마다 fsync 후 응답이라 매우 느림. no 는 커널에 맡김
lazyfree-lazy-user-del | no | yes 면 DEL 이 UNLINK 처럼 백그라운드에서 메모리 해제
lazyfree-lazy-eviction, -expire | no | yes 면 메모리 초과 축출·만료 삭제도 백그라운드 해제
busy-reply-threshold (옛 lua-time-limit) | 5000ms | 스크립트가 이 시간을 넘기면 다른 클라이언트에 BUSY 오류를 돌려줌
hz | 10 | serverCron 실행 빈도. 만료·정리 작업 주기에 영향
다음은 "멀티 코어를 어떻게 쓰나"에 대한 선택지입니다.
방식 | 명령 실행 | 코어 활용 | 원자성·단순성 | 언제
------------------------------------------------------------
기본 단일 인스턴스 | 스레드 1개 | 사실상 1코어 | 모든 명령 원자적, 락 없음 | 대부분의 경우
io-threads 켜기 | 스레드 1개 | 네트워크 처리에 여러 코어 | 그대로 유지 | CPU 가 네트워크 처리로 포화될 때
한 머신에 여러 인스턴스 | 인스턴스마다 1개 | 인스턴스 수만큼 | 인스턴스 간 원자성 없음 | FAQ 가 권하는 고전적 방법
레디스 클러스터 | 샤드마다 1개 | 여러 머신 | 다른 슬롯 키는 한 명령에 못 묶음 | 메모리·처리량이 한 대를 넘을 때
■ 5. 흔한 오해와 실수
▶ 오해 1. "단일 스레드라서 빠르다"
인과가 거꾸로입니다. 레디스는 단일 스레드인데도 빠른 것이고, 그 이유는 위에서 본 멀티플렉싱과 인메모리 처리입니다. 단일 스레드가 주는 이득은 락이 없다는 점입니다. 그 대가로 명령 하나가 길어지면 모두가 기다립니다.
▶ 오해 2. "레디스는 프로세스에 스레드가 하나다"
아닙니다. 공식 문서 스스로 mostly 라는 단서를 답니다. 2.4부터 디스크 I/O 를 백그라운드 스레드로 처리했고, 4.0부터 객체 삭제를 백그라운드로 넘겼습니다(FAQ). 6.0부터는 네트워크 I/O 스레드가 있습니다. 단일인 것은 명령 실행입니다.
▶ 실수 1. 운영 서버에서 KEYS *
공식 지연 시간 문서가 대문자로 경고하는 항목입니다. KEYS 는 키 공간 전체를 훑는 O(N) 명령이고, 도는 동안 메인 스레드는 다른 일을 못 합니다. 위 실험의 Lua 루프와 같은 일이 일어납니다. 문서는 KEYS 를 디버깅 용도로만 쓰고, 운영에서는 2.8부터 들어온 SCAN, SSCAN, HSCAN, ZSCAN 으로 조금씩 나눠 훑으라고 권합니다. SORT, LREM, SUNION, 큰 집합끼리의 교집합도 같은 위험이 있습니다. 모든 명령의 시간 복잡도는 공식 문서에 적혀 있으니, 낯선 명령은 쓰기 전에 확인합니다.
▶ 실수 2. 큰 키를 DEL 로 지우기
DEL 은 메모리를 그 자리에서 해제합니다. redis.conf 주석에 따르면 원소가 수백만 개인 집합형 값이라면 서버가 길게는 몇 초 동안 멈출 수 있습니다. UNLINK 는 키를 키 공간에서 떼어 내는 일만 상수 시간에 하고, 실제 해제는 다른 스레드가 백그라운드에서 합니다. 애플리케이션 코드를 고치기 어렵다면 lazyfree-lazy-user-del yes 로 DEL 을 UNLINK 처럼 동작하게 할 수 있습니다.
▶ 실수 3. 같은 초에 대량 만료
레디스는 만료 키를 두 가지 방식으로 지웁니다. 접근할 때 만료됐으면 지우는 게으른 방식과, 주기적으로 표본을 뽑아 지우는 능동 방식입니다. 공식 문서 설명에 따르면 능동 방식은 표본을 뽑아 25%가 넘게 만료돼 있으면 같은 일을 반복합니다. 공식 문서는 EXPIREAT 으로 아주 많은 키에 같은 시각을 걸면 이 반복 때문에 서버가 블록될 수 있다고 경고합니다. 만료 시각에 무작위 값을 조금 섞으면 피할 수 있습니다.
▶ 실수 4. fork() 와 투명 거대 페이지
RDB 저장이나 AOF 재작성은 자식 프로세스를 fork() 해서 합니다. 그런데 fork() 호출 자체는 메인 스레드에서 일어나고, 페이지 테이블 복사에 시간이 듭니다. 문서의 예로 24GB 인스턴스는 페이지 테이블만 48MB 입니다. 리눅스의 투명 거대 페이지(THP)가 켜져 있으면 fork() 이후 쓰기 시 복사(copy-on-write)가 페이지 단위로 크게 일어나 지연과 메모리가 함께 튑니다. 공식 문서는 THP 를 끄라고 권합니다.
▶ 실수 5. io-threads 를 켜면 느린 명령도 빨라진다고 기대하기
I/O 스레드는 읽기·파싱·쓰기만 나눕니다. KEYS, 무거운 Lua 스크립트, 큰 SORT 는 여전히 메인 스레드 하나에서 돕니다. 명령 실행 시간이 병목이라면 io-threads 는 답이 아닙니다. 명령을 바꾸거나 데이터를 샤딩해야 합니다. redis.conf 는 또 redis-benchmark 로 효과를 잴 때 벤치마크 쪽도 --threads 로 스레드를 맞추지 않으면 개선이 보이지 않는다고 적습니다.
■ 6. 정리
- 레디스는 스레드 하나가 epoll·kqueue 로 모든 소켓을 지켜보다가 준비된 것만 처리합니다. 빠른 이유는 기다리지 않는 구조와 메모리 안에서 끝나는 명령, 그리고 락이 없다는 점입니다.
- 단일인 것은 명령 실행뿐입니다. 디스크 동기화, 큰 객체 해제, 6.0 이후의 네트워크 I/O 는 다른 스레드가 맡고, 8.0 에서 I/O 스레딩이 새로 구현됐습니다.
- 그 대가로 느린 명령 하나가 모든 클라이언트를 세웁니다. KEYS 대신 SCAN, DEL 대신 UNLINK, 왕복 대신 파이프라인을 씁니다.
■ 참고 자료
- Redis 공식 문서 — Diagnosing latency issues(https://redis.io/docs/latest/operate/oss_and_stack/management/optimization/latency/)
- Redis 공식 문서 — Redis pipelining(https://redis.io/docs/latest/develop/using-commands/pipelining/)
- Redis 공식 문서 — Redis FAQ(https://redis.io/docs/latest/develop/get-started/faq/)
- Redis Open Source 8.0 릴리스 노트(https://redis.io/docs/latest/operate/oss_and_stack/stack-with-enterprise/release-notes/redisce/redisos-8.0-release-notes/)
- Redis 블로그 — Redis 8.0-M03 is out. Even more performance & new features(https://redis.io/blog/redis-8-0-m03-is-out-even-more-performance-new-features/)
- redis/redis — src/ae.c(https://github.com/redis/redis/blob/unstable/src/ae.c)
- redis/redis — src/ae_epoll.c(https://github.com/redis/redis/blob/unstable/src/ae_epoll.c)
- redis/redis — src/server.c(https://github.com/redis/redis/blob/unstable/src/server.c)
- redis/redis — src/networking.c(https://github.com/redis/redis/blob/unstable/src/networking.c)
- redis/redis — redis.conf(https://github.com/redis/redis/blob/unstable/redis.conf)
'Develop > [Redis]' 카테고리의 다른 글
| [Redis] Redis Pub Sub (0) | 2022.04.13 |
|---|---|
| [Redis] Persistence (0) | 2022.04.13 |
| [Redis] Cluster vs Sentinel (0) | 2022.04.12 |
| [Redis] TTL이란 (0) | 2022.04.12 |
| [Redis] Eviction 정책 (0) | 2022.04.12 |
